

利用Python wxpy自动化管理微信公众号与获取微信数据
本文介绍如何使用Python库wxpy对接微信接口,实现自动化管理微信公众号及获取个人微信数据。通过调用itchat底层指令,可批量导出好友信息、自动归档聊天记录(含音视频图片)并建立本地数据库。文章提供了基于wxpy.register()实现自动回复、消息转发及特定对象互动的具体代码示例,适用于个人数据备份与基础公众号运营场景。
2026-10-13
21

本文介绍如何使用Python库wxpy对接微信接口,实现自动化管理微信公众号及获取个人微信数据。通过调用itchat底层指令,可批量导出好友信息、自动归档聊天记录(含音视频图片)并建立本地数据库。文章提供了基于wxpy.register()实现自动回复、消息转发及特定对象互动的具体代码示例,适用于个人数据备份与基础公众号运营场景。
本文详细解析如何使用Python实现二叉搜索树(BST)。内容涵盖BST的定义与性质,并提供求树深度、中序遍历输出节点值、查找指定关键字节点等核心功能的代码实现。重点展示了递归与迭代两种查找方式的时间复杂度为O(h),并附带完整的Node类定义及测试用例,帮助开发者掌握BST的基础操作与Python编程技巧。
本文详细介绍Python中PyExecJS模块的安装与配置方法,对比Node.js、V8等JS运行时环境,重点解决Windows下JScript调用及UTF-8编码导致的UnicodeEncodeError问题,提供实用的代码编写建议。
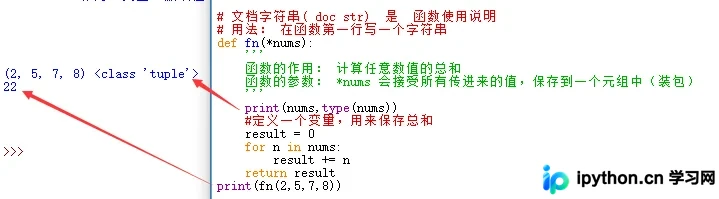
本文详细介绍Python中文档字符串(Docstring)的定义规范与作用,通过示例展示如何在函数首行编写说明文本。同时讲解如何利用help()函数查询自定义函数及内置print()函数的使用文档,帮助开发者快速掌握代码自解释与文档查阅技巧。
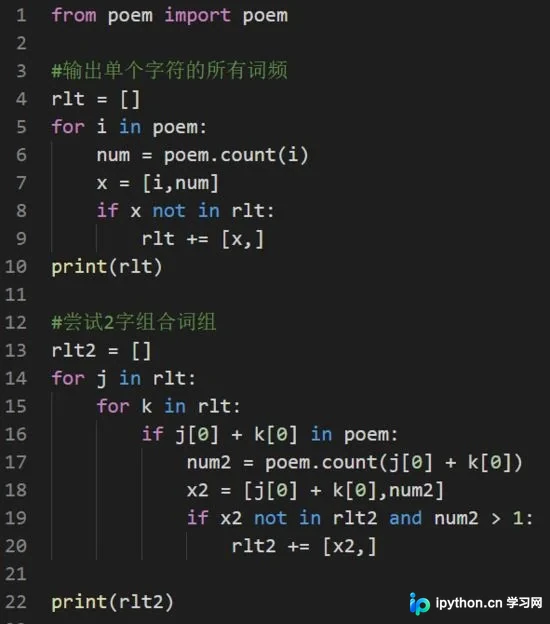
本文基于实际开发案例,详细解析如何使用Python编写词频统计脚本。文章从需求拆解入手,将复杂任务简化为单字、双字及多字词的统计逻辑,并展示了从简单常量到长文本处理的演进过程。重点探讨了当处理数千字长文时,因嵌套循环导致的指数级计算量问题(如4字词运算超467亿次),并通过优化算法结构和引入更高效的统计策略,显著提升了运行效率。
本文详解Python3中获取当前目录与脚本所在目录的区别。通过对比os.getcwd()、sys.path[0]与__file__变量,说明在不同执行场景(如打包exe或子模块调用)下的路径差异,并给出使用os.path.realpath()获取准确脚本目录的标准写法,附带获取父目录与绝对路径的代码示例。
本文介绍在Ubuntu系统中解决Python Matplotlib中文显示乱码的方法。涵盖系统级安装中文字体、Python代码中指定默认字体、直接加载本地字体文件以及将字体复制到Matplotlib目录等四种方案,帮助开发者在无法安装系统字体或Docker环境下实现图表中文正常渲染。
本文详解Django框架中视图函数的三种核心返回方式:直接构造HTTP响应体、使用render函数渲染HTML模板,以及通过status参数或子类返回HTTP错误。涵盖具体代码示例与参数说明,帮助开发者掌握Django视图层的数据处理与响应生成技巧。
本文详解Python中numpy和pandas计算标准差的区别。默认情况下,numpy.std()使用有偏估计(除以n),而pandas.std()使用无偏估计(除以n-1)。通过调整ddof参数,可实现两种算法的互换。文章指出ddof=1为无偏估计的关键,并提醒在scikit-learn等库中手动设置该参数的重要性,尤其在数据量较小时需特别注意。
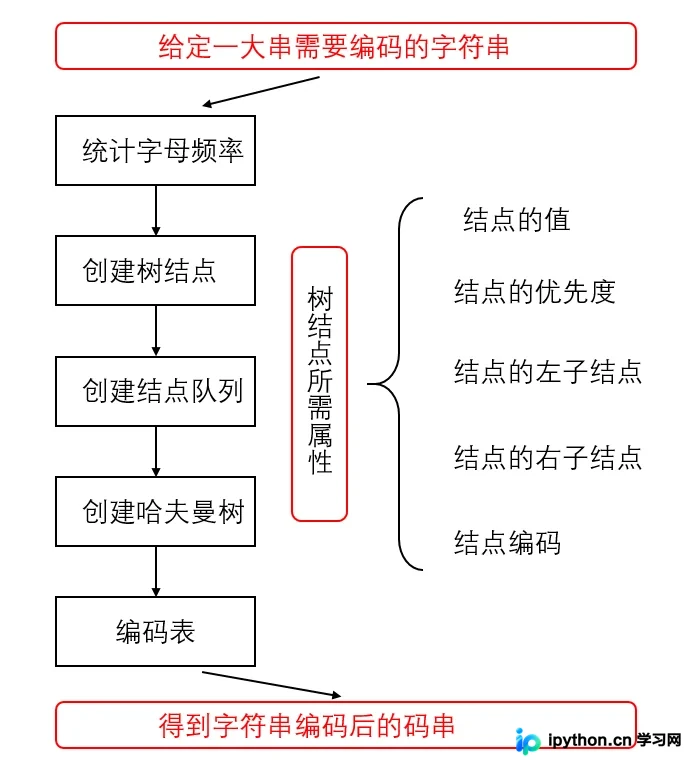
本文详细解析Python中哈夫曼树的构建与编码过程。从树节点类定义、优先度队列管理,到字符频率统计、中序遍历生成编码表,最后实现字符串的编码与解码。通过逐段代码分析,帮助读者理解哈夫曼编码的核心逻辑与递归实现,适用于Python初学者及算法爱好者参考。
本文详细解析Python企业编码生成系统的主程序模块,涵盖初始化、界面构建及核心逻辑。系统支持6位至25位多种防伪编码生成、条形码与二维码批量输出及抽奖功能,通过tkinter构建交互界面,并包含严格的输入验证机制,确保操作安全与数据准确。
本文介绍在 Django REST Framework 中如何序列化外键以获取非 ID 字段信息。通过两种方法实现:一是在 Serializer 中使用 source 属性指定关联字段;二是在 Model 中利用 property 装饰器定义计算字段并配合 ReadOnlyField。适用于需要返回关联对象详细信息的 API 开发场景。