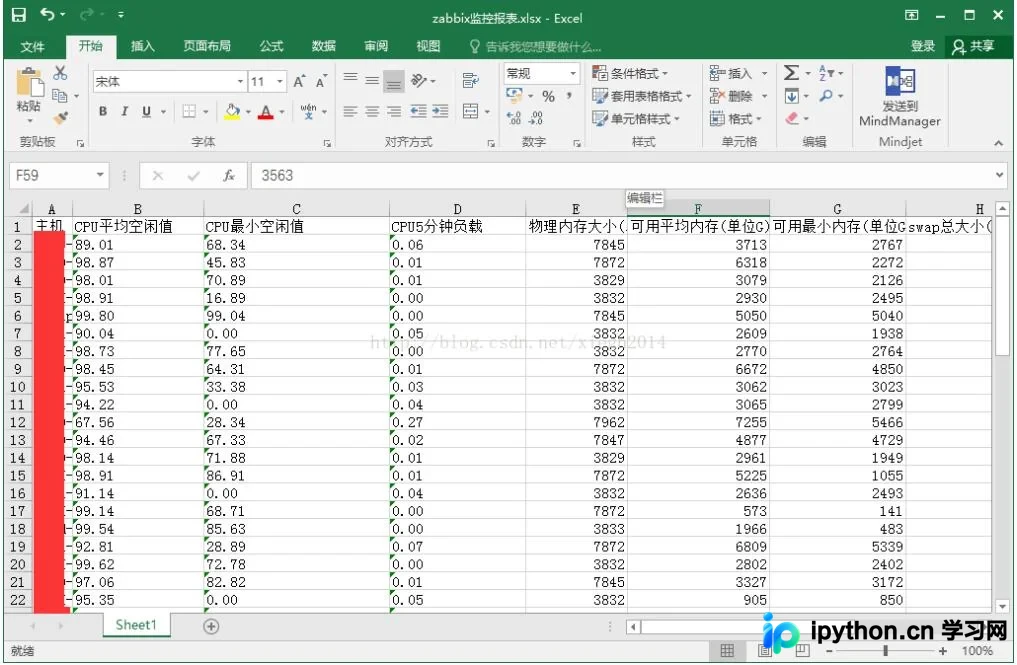
Zabbix 3.2 通过 Python 脚本生成监控报表的完整方案
本文详细介绍如何利用 Python 脚本连接 Zabbix 数据库,提取 CPU、内存及 Swap 等关键性能指标,并自动生成 Excel 格式监控报表。通过配置数据库连接参数与查询 Key 列表,实现自动化数据抓取与格式化输出,适用于 Zabbix 3.2 环境下的运维报表需求。
2026-10-13
20

本文详细介绍如何利用 Python 脚本连接 Zabbix 数据库,提取 CPU、内存及 Swap 等关键性能指标,并自动生成 Excel 格式监控报表。通过配置数据库连接参数与查询 Key 列表,实现自动化数据抓取与格式化输出,适用于 Zabbix 3.2 环境下的运维报表需求。
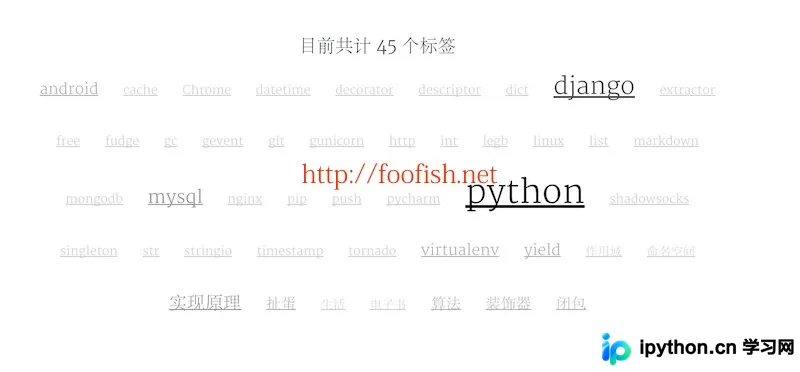
本文详细介绍如何使用Python实现标签云算法,通过计算标签引用次数动态映射字体大小和颜色。核心逻辑利用线性公式确定步长,将引用次数区间映射到预设的字体大小数组中,并对应生成相应的颜色值,确保视觉层次清晰且页面美观。
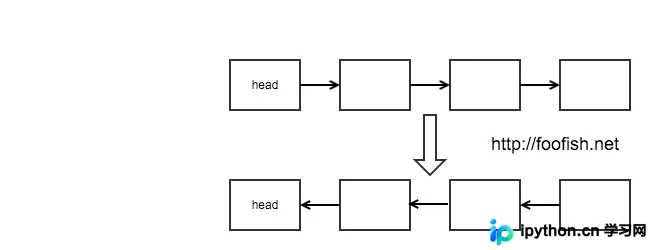
本文详细解析Python中单向链表反转的两种核心实现方式:循环迭代与递归。通过定义Node类,分别演示了利用pre、head、next三个指针进行迭代反转的过程,以及通过递归找到临界点后反向链接节点的逻辑。文章包含完整代码示例及测试输出,帮助开发者深入理解链表操作原理。
本文详细介绍如何在Python中使用pymongo库连接MongoDB数据库。内容涵盖MongoDB环境配置、数据插入、查询统计、排序偏移以及更新删除操作。重点解析了使用$set与不使用$set在更新数据时的字段保留差异,并提供完整的代码示例与结果分析,帮助开发者掌握Python与MongoDB的高效交互方法。
本文介绍如何在Python中计算数据的偏度和峰度。通过结合NumPy进行基础统计量(均值、标准差)的计算,并利用SciPy库的stats模块获取偏度和峰度指标,帮助开发者理解数据分布的不均衡性及峰值特征。
本文详细解析NumPy和Pandas中数组的合并、拉直与重塑操作。通过concatenate和pandas.concat实现垂直或水平合并,利用ravel进行行优先(C顺序)或列优先(Fortran顺序)的拉直,并结合reshape探讨不同内存顺序下的重塑效果,提供完整代码示例与结果分析。
本文介绍Python中Pandas与NumPy数组的相互转换及DataFrame连接方法。通过np.array()将Pandas对象转为数组,利用pd.DataFrame()将数组转为DataFrame,并使用pd.concat进行左右拼接。掌握这些基础操作有助于高效处理数据。
本文提供Python批量解压ZIP压缩文件的完整代码示例。通过os模块遍历目录获取文件列表,利用zipfile模块判断并解压文件,支持指定源路径与存储路径。代码包含处理编码问题及目录创建的逻辑,适用于需要自动化处理大量压缩文件的场景。
本文介绍PyCharm远程调试时同步远程解释器卡在上传helper文件处的解决方法。通过删除安装目录下的skeletons文件夹并重启配置,可快速解决该问题,适用于Linux开发环境。
本文详细解析 Python 中 int() 函数的使用方法,涵盖将字符串或数字转换为整型的语法及参数说明。重点介绍 base 参数在进制转换中的应用,如十六进制和八进制处理。同时区分 int 作为有符号整型数据类型的概念,提供完整代码示例与返回值说明,帮助开发者掌握基础类型转换技巧。
本文详细解析Python中自定义函数的定义与调用方法。涵盖使用def关键字声明函数、参数传递、返回值处理及None值的返回逻辑。通过具体代码示例演示函数实现,并深入探讨import导入机制及路径配置问题,解决自定义模块调用失败的实际操作难点。
本文详细介绍如何利用Python的xlrd库读取Excel文件中的坐标数据,并结合matplotlib库进行可视化处理。通过具体代码示例,展示如何解析工作表行列数据,提取X、Y坐标值,并使用散点图直观呈现数据分布及坐标标注,适用于基础数据可视化场景。