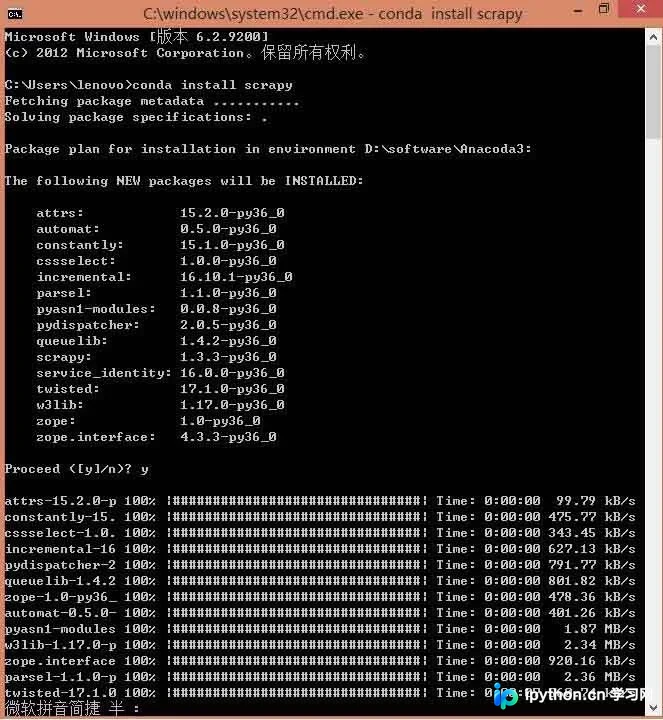
使用Anaconda快速安装Scrapy框架及PyCharm配置指南
本文介绍利用Anaconda简化Scrapy框架安装的方法。通过conda install scrapy一条命令解决复杂依赖,并详细讲解在PyCharm中配置项目解释器为Anaconda Python路径的操作步骤。同时提醒用户注意点击OK而非Apply以避免不必要的库更新,并提供了验证安装成功的测试方法。
2026-10-12
19

本文介绍利用Anaconda简化Scrapy框架安装的方法。通过conda install scrapy一条命令解决复杂依赖,并详细讲解在PyCharm中配置项目解释器为Anaconda Python路径的操作步骤。同时提醒用户注意点击OK而非Apply以避免不必要的库更新,并提供了验证安装成功的测试方法。
本文详细介绍使用Python通过PyMongo库操作MongoDB数据库的完整流程。内容涵盖连接服务器、选择数据库与集合、插入单条或多条数据、执行各类查询(包括条件、模糊、排序、分页)、更新记录以及删除数据的方法。重点解析insert_one、update_one等推荐API的使用及返回值处理,帮助开发者掌握MongoDB在Python中的基础应用。
本文详解 Python3.6 环境下 psutil 模块的安装方法及核心功能。psutil 是跨平台系统监控库,可获取 CPU、内存、磁盘及网络利用率。文章提供 Windows 下安装 .whl 文件的步骤,并展示通过 psutil 获取 CPU 时间、物理/逻辑核心数、内存使用量、磁盘 IO 及网络统计信息的完整代码示例,适用于系统资源分析与进程管理。
本文详细解析如何使用Python实现最长公共子序列(LCS)算法。通过动态规划构建状态矩阵,并利用回溯矩阵逆向追踪最优解。文章提供完整的Python代码示例,展示如何计算两个序列的最长公共子序列长度及具体序列内容,适用于算法学习与面试准备。
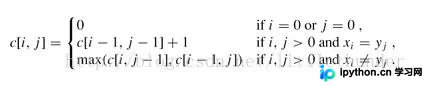
本文深入解析Python中三种核心字符串处理函数:replace、re.sub与strip。通过具体代码示例,展示如何利用字典映射进行批量字符替换,结合正则表达式实现复杂模式匹配替换,以及使用strip去除指定前后缀字符。内容涵盖基础用法、参数详解及实际应用场景,适合Python初学者及需要高效处理文本数据的开发者参考。
本文详解在 Python Selenium 中如何管理浏览器标签页与窗口。涵盖使用 ActionChains 模拟快捷键(Ctrl+T/W)进行标签页的新建与关闭,以及通过 window_handles 获取并切换窗口句柄的方法。同时区分 driver.quit() 与 driver.close() 的区别,并提供完整的代码示例与操作逻辑。

本文介绍如何使用Python的xlutils库实现Excel文件的追加写入并保留原有格式。通过结合xlrd读取和xlwt写入,利用copy()方法复制工作簿,可避免直接写入导致的格式丢失问题。文章提供了完整的代码示例,并详细说明了xls与xlsx后缀文件的兼容性及常见操作异常的处理方法。
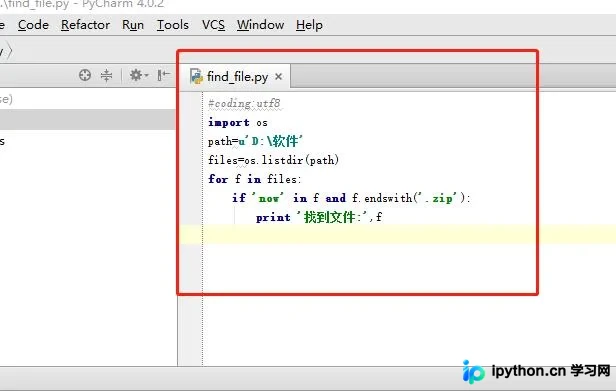
本文介绍如何使用Python的os模块查找指定目录下的文件。通过os.listdir()获取文件列表,结合for循环与if条件判断(如文件名包含特定字符、后缀名匹配),实现精准查找。示例以D:\软件目录为例,查找包含“now”且后缀为“.zip”的文件,并打印结果。
本文介绍如何使用Python脚本自动生成Caffe所需的train_list.txt文件,并详细解析os模块在文件重命名、读写、目录管理及路径处理中的核心用法。涵盖open模式、文件读写方法、文件夹创建删除、路径拼接及系统命令执行等实用技巧,辅助深度学习数据预处理。
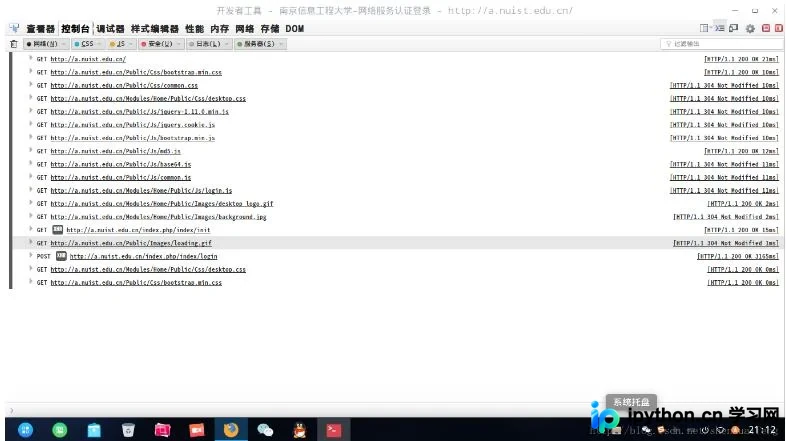
本文详细讲解如何利用Python和requests库实现校园网自动登录。通过Firefox浏览器和Firebug插件监控网络请求,分析POST请求的Header和Body参数。重点解析密码字段的Base64编码过程,并提供完整的Python登录脚本,帮助读者掌握网络请求模拟与数据构造技巧。
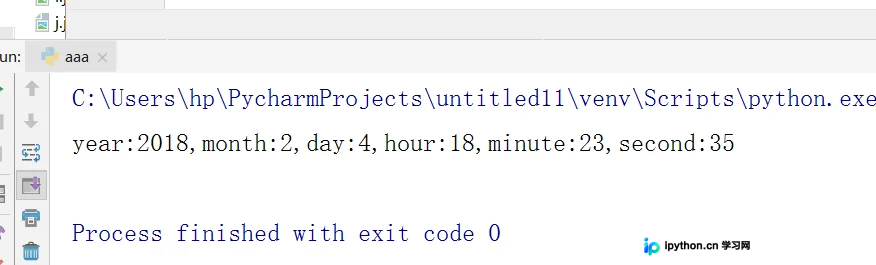
本文介绍在 Python 中将标准时间字符串(如“2018-02-04 18:23:35”)解析为包含年、月、日、时、分、秒键值对的字典的两种常用方法。通过正则表达式匹配或内置 time 模块,可以高效提取时间信息并转换为结构化数据,适用于日志分析和数据处理场景。