

Python while循环结合else语句的用法详解
本文详细解析Python中while循环与else语句的结合用法。当while循环正常结束(即条件变为假)而非通过break中断时,else块中的代码将执行。通过具体代码示例展示了a=4时的运行结果,帮助开发者理解该控制流机制。
2026-10-13
17

本文详细解析Python中while循环与else语句的结合用法。当while循环正常结束(即条件变为假)而非通过break中断时,else块中的代码将执行。通过具体代码示例展示了a=4时的运行结果,帮助开发者理解该控制流机制。
本文深入解析Python中Lambda匿名函数的定义原理与使用场景。通过对比普通函数,详细阐述lambda关键字、参数列表及表达式返回值的语法结构,并提供完整代码示例展示其实际应用,帮助开发者快速掌握这一简洁高效的编程技巧。
本文详细介绍Python NumPy库中reshape、resize、swapaxes及flatten等数组变形函数的用法与区别。重点讲解将多个二维数组合并为三维数组的三种方法:直接构造、append重组及list转换,分析各方法的适用场景与性能差异,并提供完整代码示例。
本文详细介绍TensorFlow中tile函数的核心功能,即复制张量的指定维度。通过具体代码示例解析参数含义,展示如何对多维数据进行行列扩展,帮助开发者掌握该函数的实际应用。
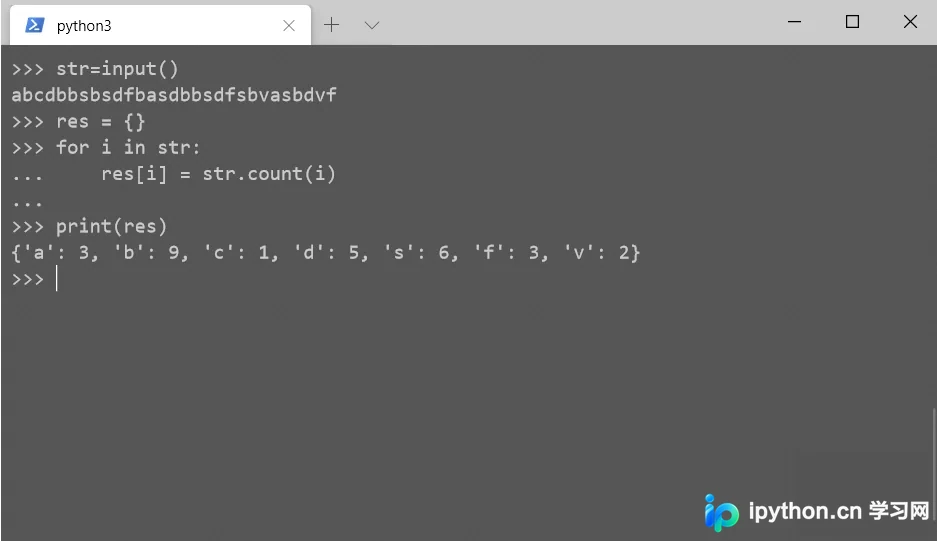
本文详细介绍在Python中统计字符串内各字符出现次数的方法。通过input获取用户输入,利用for循环遍历字符串,并结合内置的str.count()函数统计每个字符的频率。最终结果存储于字典中并输出,展示了Python处理文本数据的简洁与高效。
本文深入解析Python内置模块itertools的核心功能,涵盖chain、count、compress、starmap、product、permutations及combinations等关键函数。通过具体代码示例,展示如何高效处理序列链接、无限序列生成、条件过滤及笛卡尔积计算,并提供利用combinations求解特定质数组合的实战案例,帮助开发者掌握高级迭代技巧。
本文详解TensorFlow中tf.ConfigProto()的核心用法,涵盖log_device_placement日志打印、inter/intra_op线程数设置及soft_placement自动分配机制。深入解析GPU模式下的显存增长策略(allow_growth)与固定比例限制(per_process_gpu_memory_fraction),并提供CUDA检测与设备指定代码示例,助力模型训练性能优化。
本文详细介绍TensorFlow中tf.dynamic_partition函数的使用方法,通过基础整数矩阵和One-Hot编码两个实例,演示如何根据索引列表将张量动态拆分为多个子张量。涵盖reshape操作、分区索引指定及结果验证,适用于需要动态处理多维数据分组的场景。
本文详细介绍在Python中将itertools.chain对象转换为数组的两种常用方法。第一种直接使用list(),操作简单但存在嵌套列表且效率较低的问题;第二种推荐利用numpy库的np.fromiter()函数,通过指定数据类型实现更高效的转换。通过代码示例与时间对比,验证了numpy方法在处理大规模数据时的速度优势,为开发者提供性能更优的解决方案。
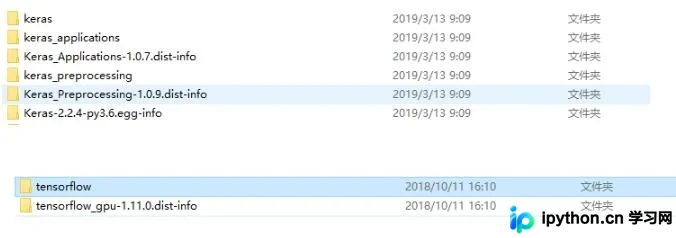
本文针对在Anaconda环境中安装TensorFlow-GPU后,Keras仍调用CPU进行计算的问题,分析了因同时存在tensorflow和tensorflow-gpu文件夹导致的默认调用冲突。通过彻底卸载现有库并重新在PyCharm中安装tensorflow-gpu和keras,成功实现GPU加速。
本文针对TensorFlow在使用GPU训练时出现CPU占用率过高且无法调用显卡的问题,分析其原因为TensorFlow GPU版本与服务器CUDA及CuDNN版本不匹配。通过检查当前CUDA和CuDNN版本,并在官网下载对应版本的TensorFlow-GPU进行重新安装,从而解决该兼容性问题,确保模型训练能正常利用GPU加速。
本文介绍如何利用Python实现IP地址的包含关系判断。通过自定义函数将不同格式的IP地址(如标准IP、范围IP、CIDR等)统一转换为十进制数值范围,进而通过数值比较判断两个IP地址之间是否存在包含关系,解决了标准库在某些场景下的局限性。