Python文件操作详解:open、write与flush机制解析
本文详细介绍Python中文件操作的核心方法。通过open函数创建文件对象,解析r、w、a等访问模式及缓冲参数。重点讲解write写入字符串、read读取内容及flush刷新缓冲区的作用,阐明数据从内存缓冲区写入磁盘的机制,以及close方法如何确保数据完整性,防止意外退出导致的数据丢失。
2026-10-13
15

本文详细介绍Python中文件操作的核心方法。通过open函数创建文件对象,解析r、w、a等访问模式及缓冲参数。重点讲解write写入字符串、read读取内容及flush刷新缓冲区的作用,阐明数据从内存缓冲区写入磁盘的机制,以及close方法如何确保数据完整性,防止意外退出导致的数据丢失。
本文分析Python中logging.basicConfig设置日志级别失败的原因。当其他库在导入时已初始化根日志处理器,basicConfig将跳过配置。解决方案是确保在调用basicConfig前,root.handlers为空,或将配置语句置于所有import之前。
本文详细介绍Python中常用的高阶函数,包括lambda匿名函数、map、filter、reduce和sorted。通过具体代码示例,讲解如何接收函数作为参数以提高代码效率,涵盖自定义排序、序列映射、条件过滤及元素累加等实际应用场景。
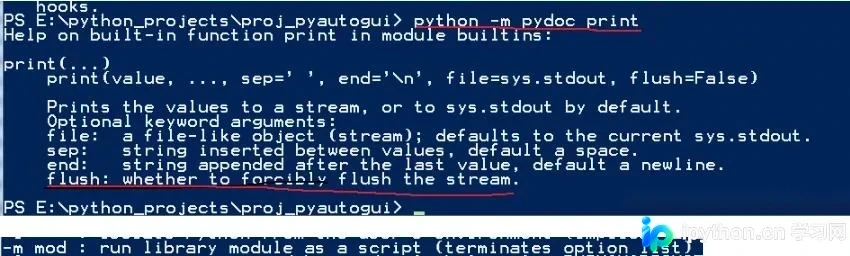
本文深入解析Python中print()函数flush=True参数的作用机制。通过说明输出缓冲原理,阐述在while循环和文件写入等场景下,如何利用该参数强制清空缓冲区以实现内容的实时显示,帮助开发者解决输出延迟问题。
本文深入解析Python解释器的常用命令行选项,包括-c、-m、-i等执行模式及sys.argv的行为差异,并详细阐述PYTHONHOME、PYTHONPATH、PYTHONSTARTUP等关键环境变量的作用与配置方法,帮助开发者高效管理Python运行环境与模块加载路径。
本文通过对比实验展示Python中频繁使用print语句对程序执行效率的巨大影响。在1万次循环中,包含print的代码耗时约85.9秒,而无print仅0.002秒,相差近4.3万倍。对于高频交易或复杂策略,这种延迟可能导致错失交易时机,建议生产环境移除调试打印。
本文深入解析Python中的反射机制,通过具体实例演示如何利用getattr、setattr和hasattr三个内置函数动态获取、设置及判断对象属性。文章包含完整的代码示例,展示如何根据字符串动态调用方法或修改对象状态,帮助开发者理解Python的动态特性及其在面向对象编程中的应用。
本文详细解析Python中sys模块的常用方法及属性,涵盖sys.argv、sys.exit、sys.getdefaultencoding等核心功能,帮助开发者掌握系统级操作与模块管理技巧。
本文提供基于Python3的疫情监控完整代码,利用requests获取腾讯疫情接口数据,并通过Pyecharts库绘制全国疫情分布地图。代码包含确诊、疑似、死亡及治愈数据的实时展示与地图渲染,适用于Python学习与数据可视化实践。
本文深入解析Python3中shutil模块的高级文件操作功能,涵盖文件与目录的拷贝、移动、删除及压缩解压。通过具体代码实例,演示shutil.move与os.rename的区别,以及copy2、copytree和make_archive等核心函数的用法,帮助开发者高效处理文件系统任务。
本文详细总结了Python中os模块的常用方法及属性,涵盖文件统计、创建、删除及路径处理等核心功能。通过具体代码示例,解析如何利用os模块进行文件属性获取、目录遍历及系统命令执行,为Python开发中的文件系统操作提供参考。
本文详细解析 Python 中使用 sqlite3 进行数据库查询的方法。重点介绍如何通过查询 sqlite_master 表获取所有表名,利用 PRAGMA table_info 获取指定表的字段信息,并通过 Python 代码示例演示如何同时获取 SQL 查询结果及其对应的列名,为数据库操作提供实用参考。