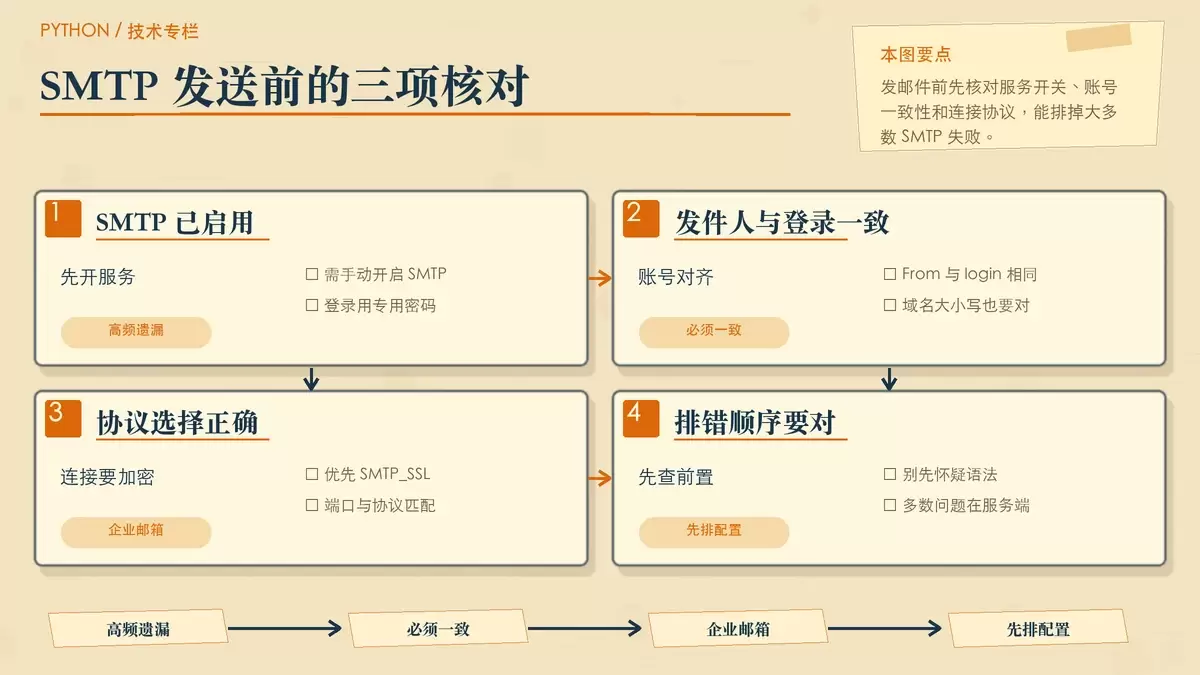
在 Python 中如何将分析结果自动发送至指定邮箱或企业微信机器人?
把分析结果自动推送到邮箱或企业微信,真正容易出问题的不是发送代码本身,而是鉴权、消息格式、调度稳定性和密钥管理。本文按这四个环节拆解常见报错与避坑点,并给出可直接改造的 Python 示例。
2026-08-25
136

把分析结果自动推送到邮箱或企业微信,真正容易出问题的不是发送代码本身,而是鉴权、消息格式、调度稳定性和密钥管理。本文按这四个环节拆解常见报错与避坑点,并给出可直接改造的 Python 示例。
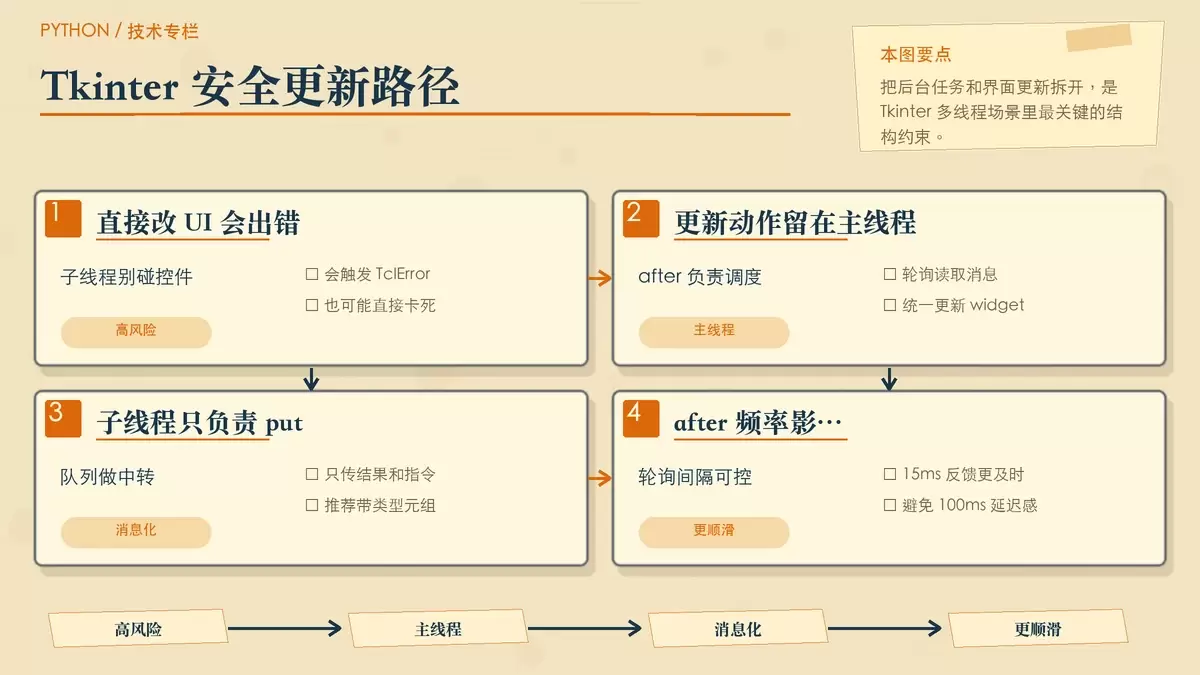
在 Tkinter 里,子线程直接改界面不是“有风险”,而是设计上就不成立。稳定做法只有一条:子线程把结果放进 `queue.Queue`,主线程借助 `root.after()` 定时取出并更新控件。文章会把原因、正确写法,以及线程池和退出清理这些常见细节一次讲清。
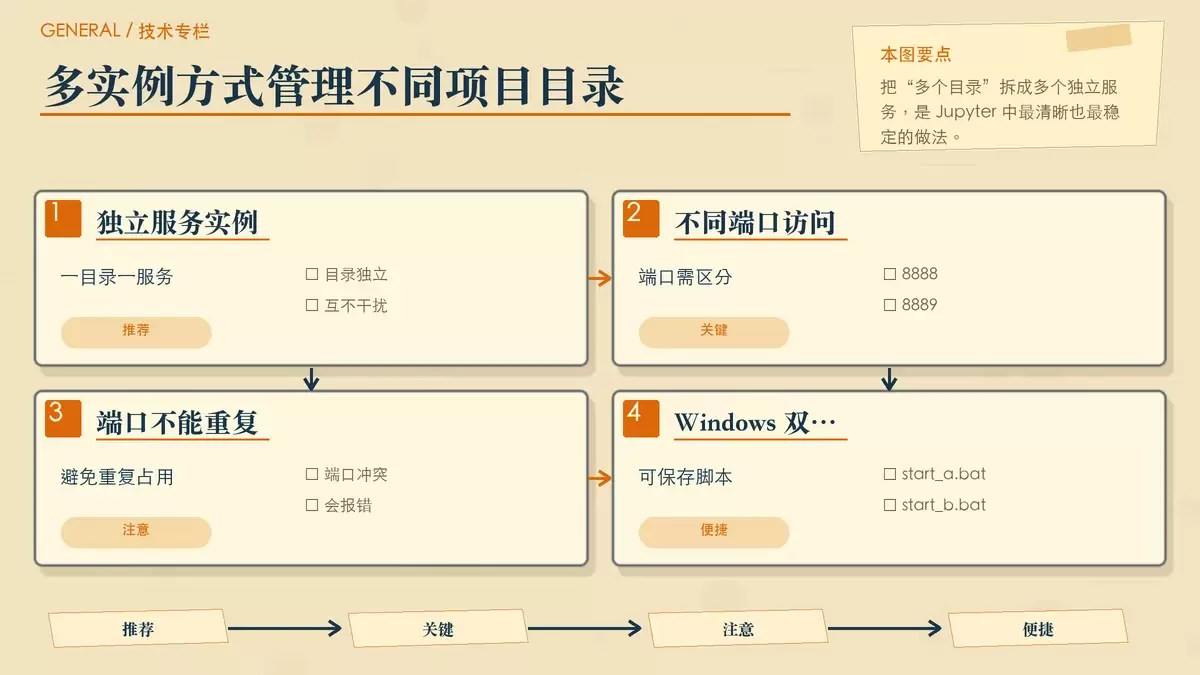
Jupyter Notebook 并没有“多个默认工作目录”这个原生配置项,`c.NotebookApp.notebook_dir` 只能指定一个根路径。真正可行的做法,通常是为不同项目分别启动多个服务实例,或在单个 Notebook 会话里切换当前工作目录;如果配合 VS Code 远程连接,还可以让内核自动跟随 `.ipynb` 文件所在目录。
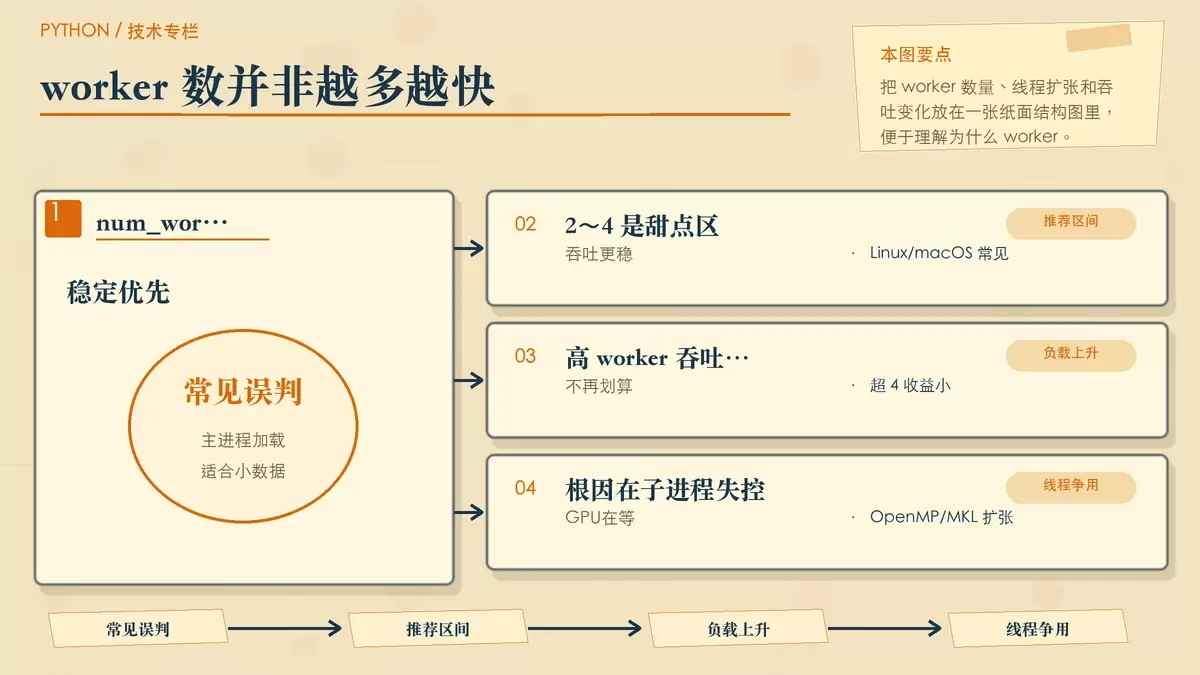
训练时出现 CPU 打满、GPU 却吃不满,很多时候不是模型太慢,而是 PyTorch 的数据加载链路配置失衡。本文围绕 DataLoader、固定页内存、线程控制和瓶颈定位四个环节,整理出一套更稳妥的排查与调参思路。
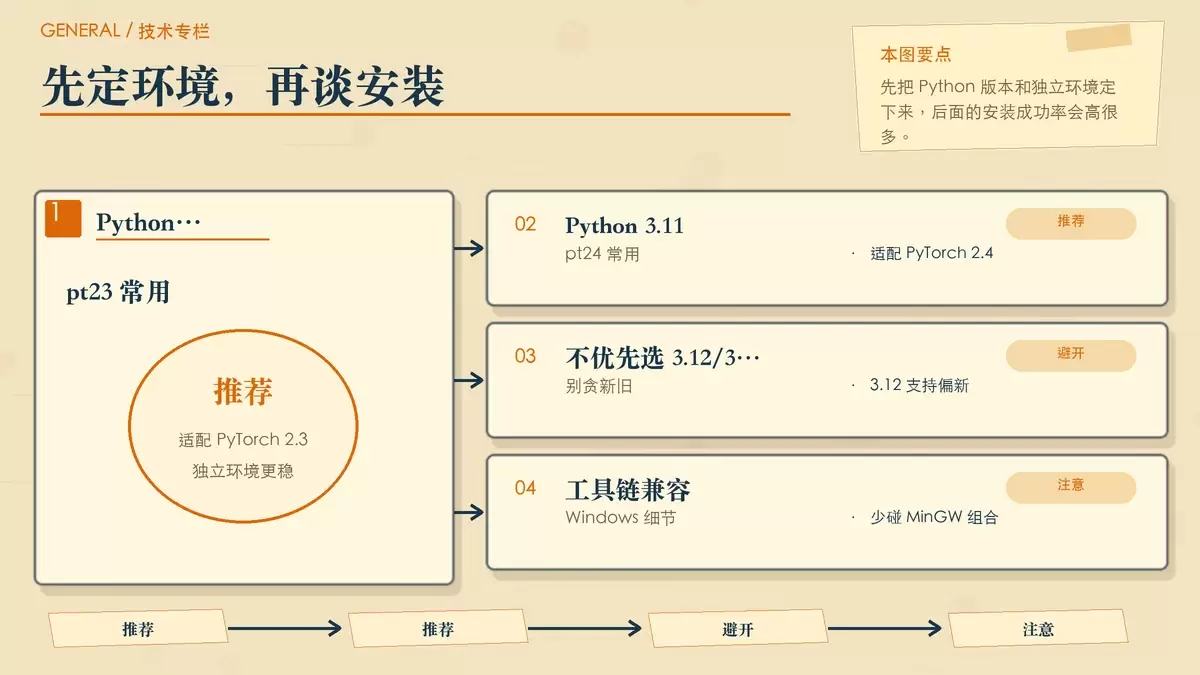
用 Anaconda 安装 PyTorch,真正容易出问题的通常不是命令本身,而是 Python 版本、CUDA 选择、镜像源优先级和运行时环境没有对齐。本文按实际排错顺序整理安装步骤,并给出 CPU/GPU 判断办法与常见误区,方便快速装好后立刻验证。
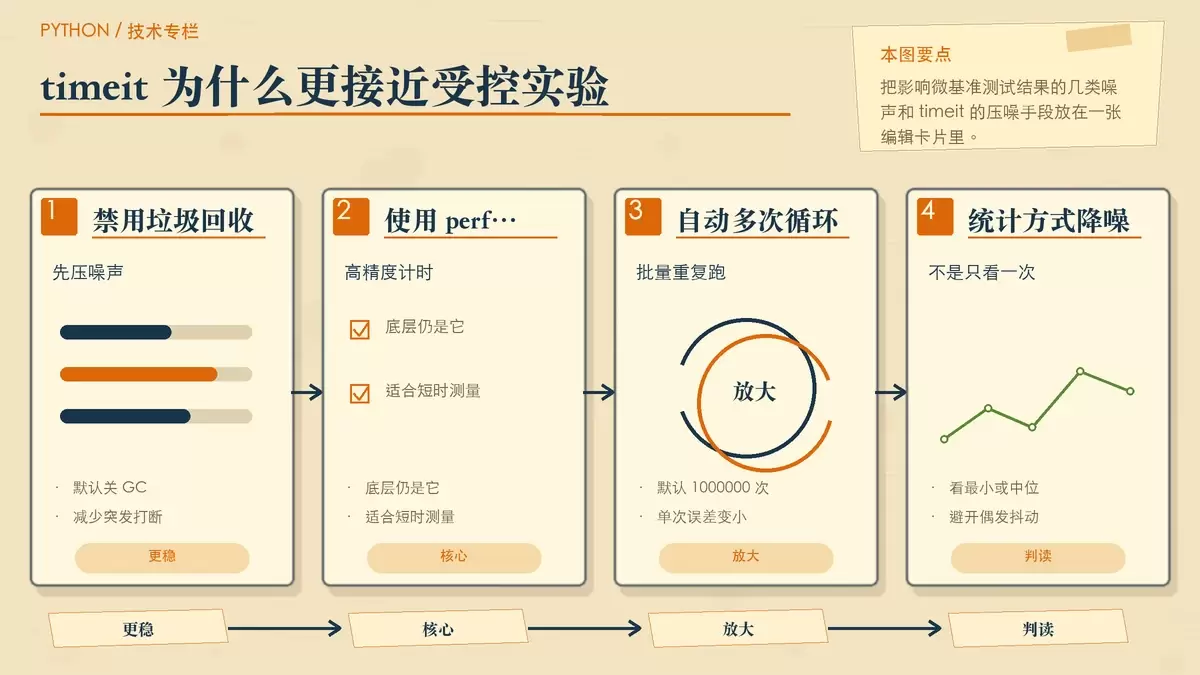
在 Python 里,`timeit` 比手写 `perf_counter()` 更适合做小段代码基准测试,不只是因为“能计时”,而是它默认关闭 GC、批量重复执行并结合结果分布来压低噪声。本文会把几个最容易写错的地方拆开讲清楚,包括作用域、函数调用写法,以及 `repeat()` 结果到底该怎么看。
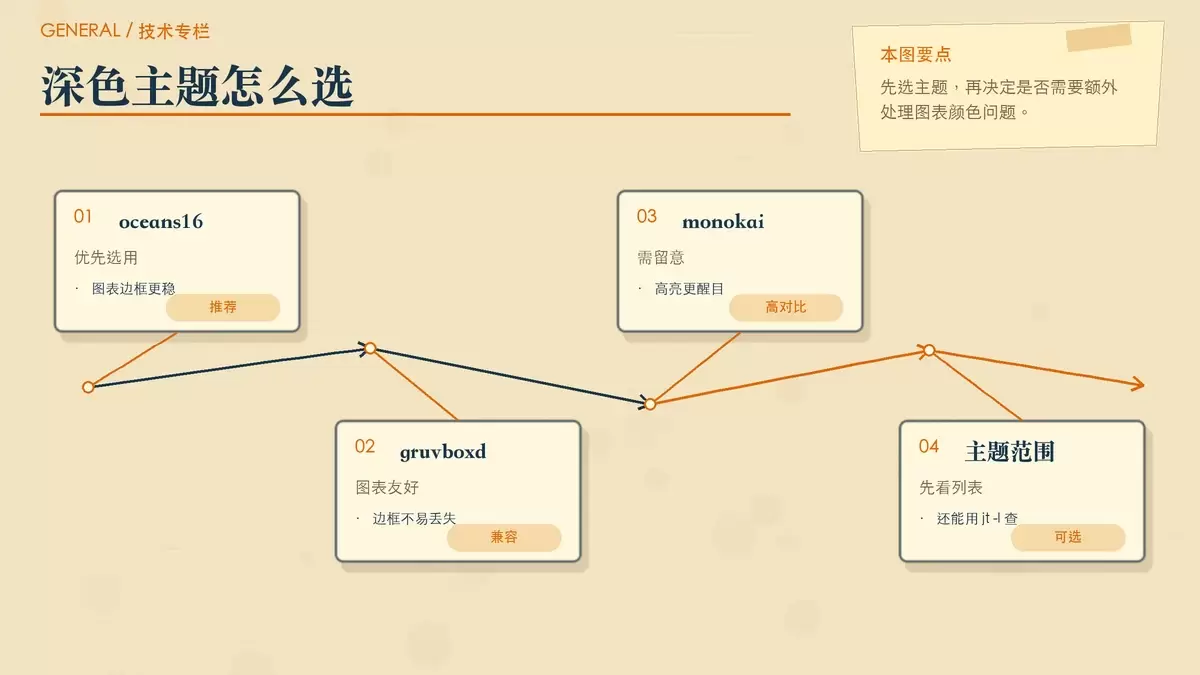
Jupyter Notebook 想切到深色模式,最省事也最稳定的做法不是手改 CSS,而是直接使用 jupyter-themes。本文整理安装、主题选择、启用命令和回退方法,并补上图表边框、缓存不刷新的常见问题处理。 Jupyter Notebook 想换成深色背景,很多人会先去改 CSS 或找浏览器插件,但这类办法常常只改了界面,图表和输出区域却没跟上。
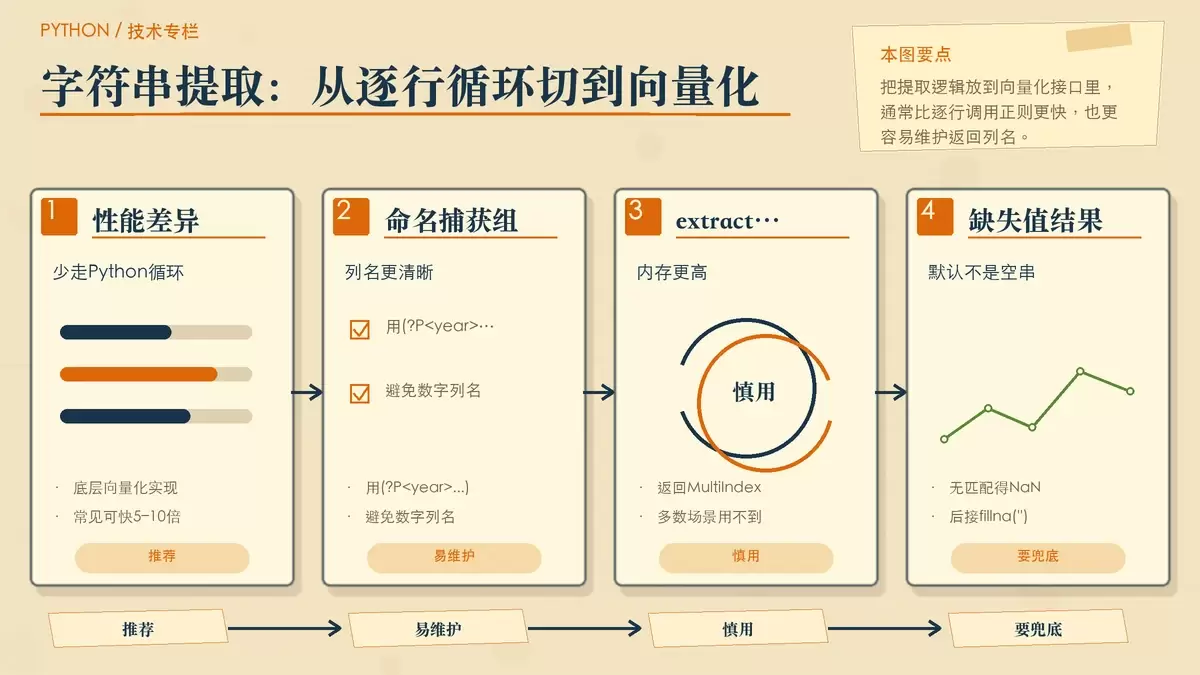
处理百万级字符串列时,性能瓶颈往往不在正则本身,而在 Python 层循环、返回结构和空值处理。本文围绕 pandas 的 `str.extract` 与 `str.replace`,梳理提取、替换、内存控制和超大规模并行处理中的关键写法与常见坑点。
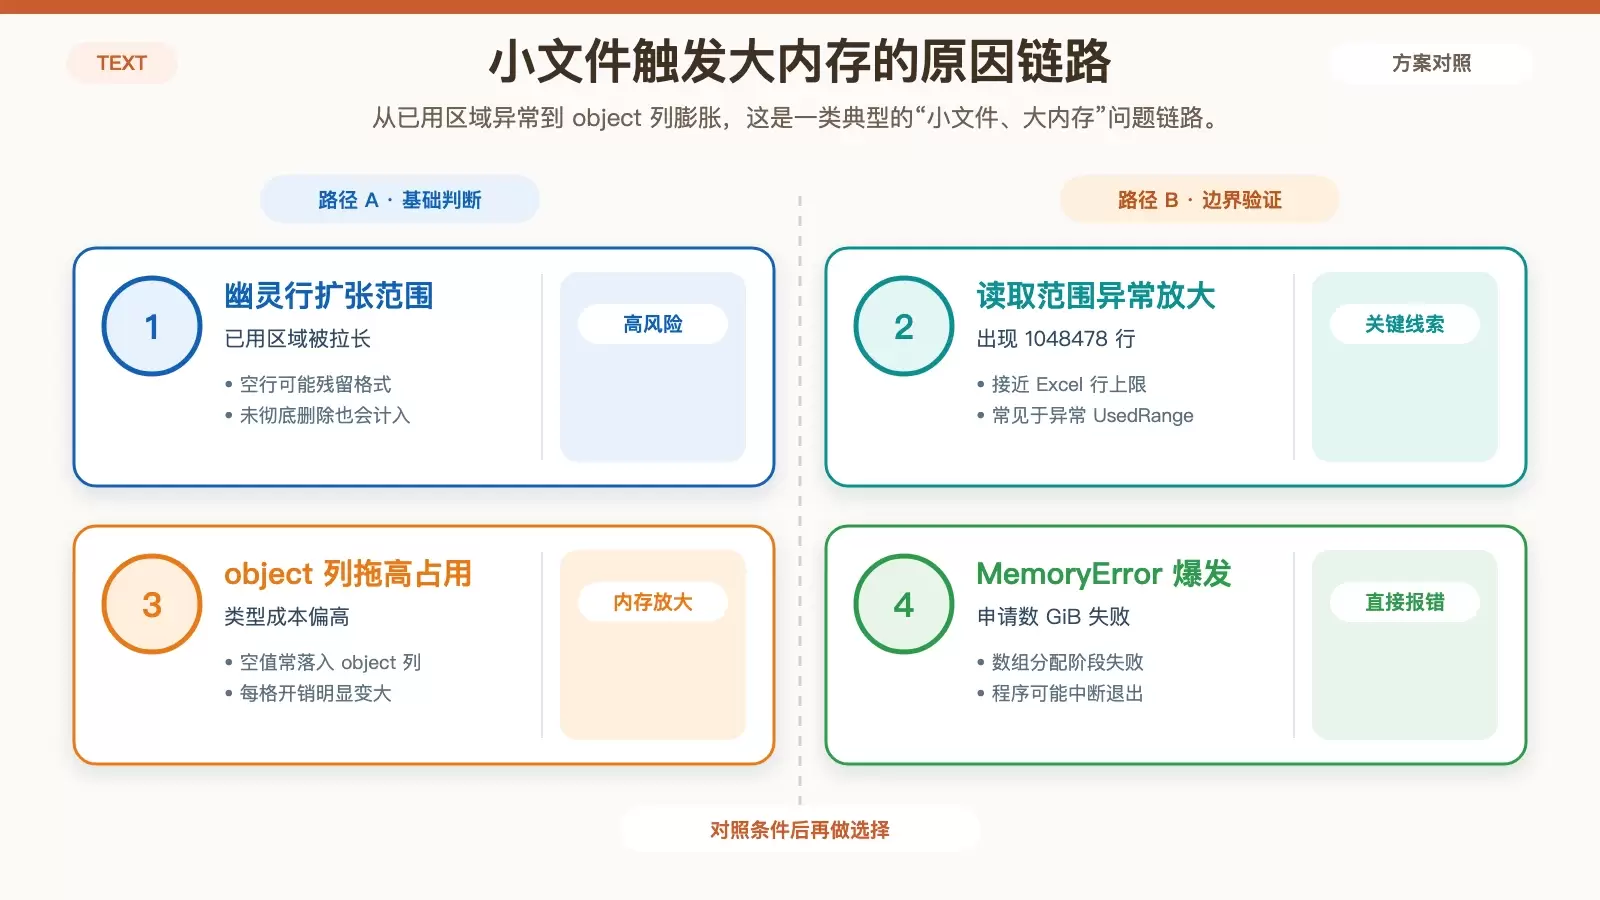
Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
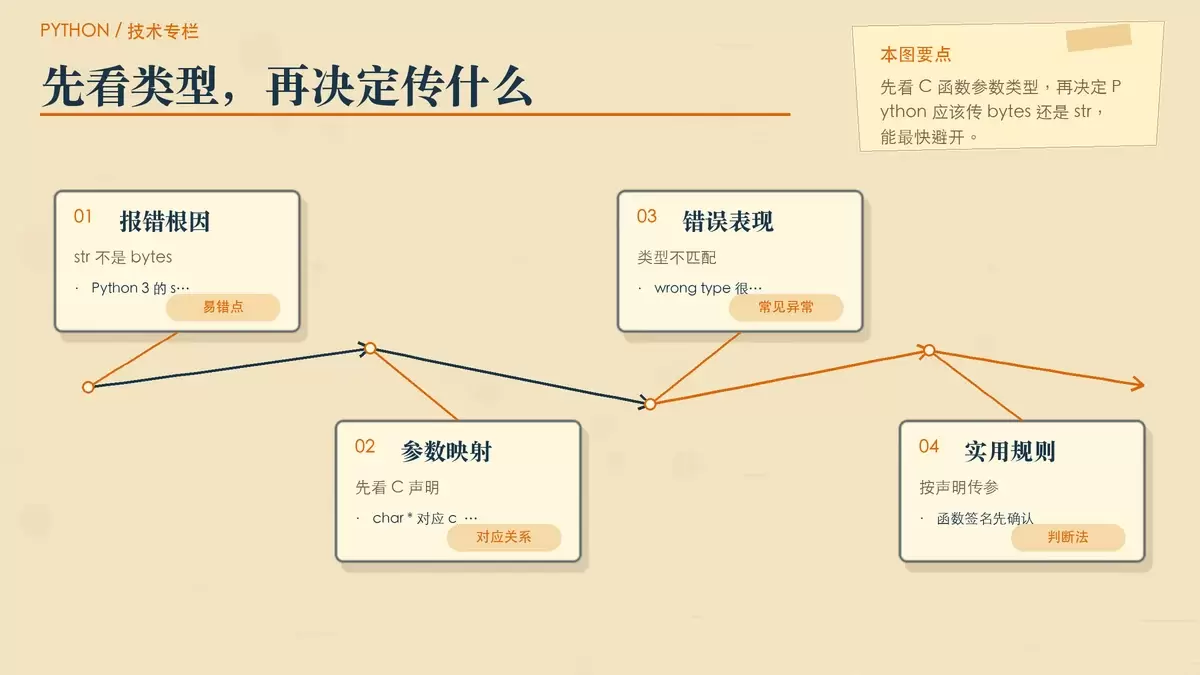
在 Python 里用 ctypes 调 C 共享库时,`char *` 参数最常见的坑就是把 `str` 直接传进去,结果触发 `ArgumentError: wrong type`。这篇文章把 `c_char_p`、`bytes`、编码方式以及 `c_wchar_p` 的适用场景拆开说明,帮你快速判断该传什么、什么时候该换类型。 用 Python 的 ctypes 调 C 共享库时,字符串参数经常在看似最简单的地方翻车:C 端写的是 char * ,Python 端却直接传了 str 。
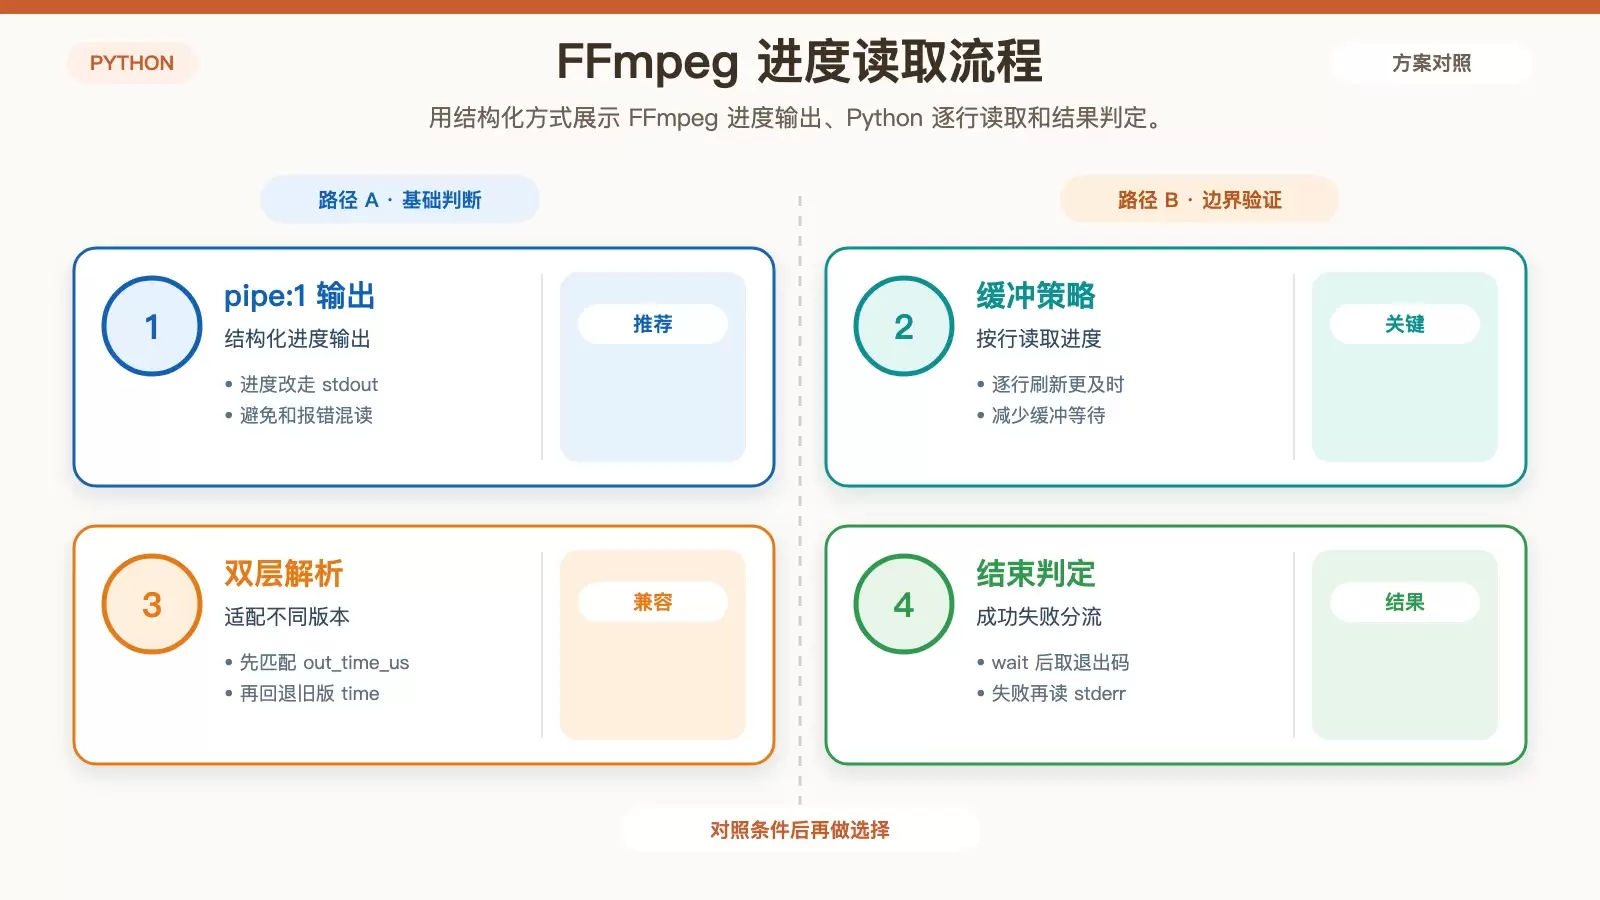
在 Python 里调用 FFmpeg 并不难,真正麻烦的是卡住、没进度、批量任务中断和 Windows 环境问题。本文按“一次性执行、实时进度、批量处理、常见报错”四个场景重组做法,保留可直接使用的命令与代码,并说明什么情况下该选 `run`、`Popen` 或 `pathlib` 组合。
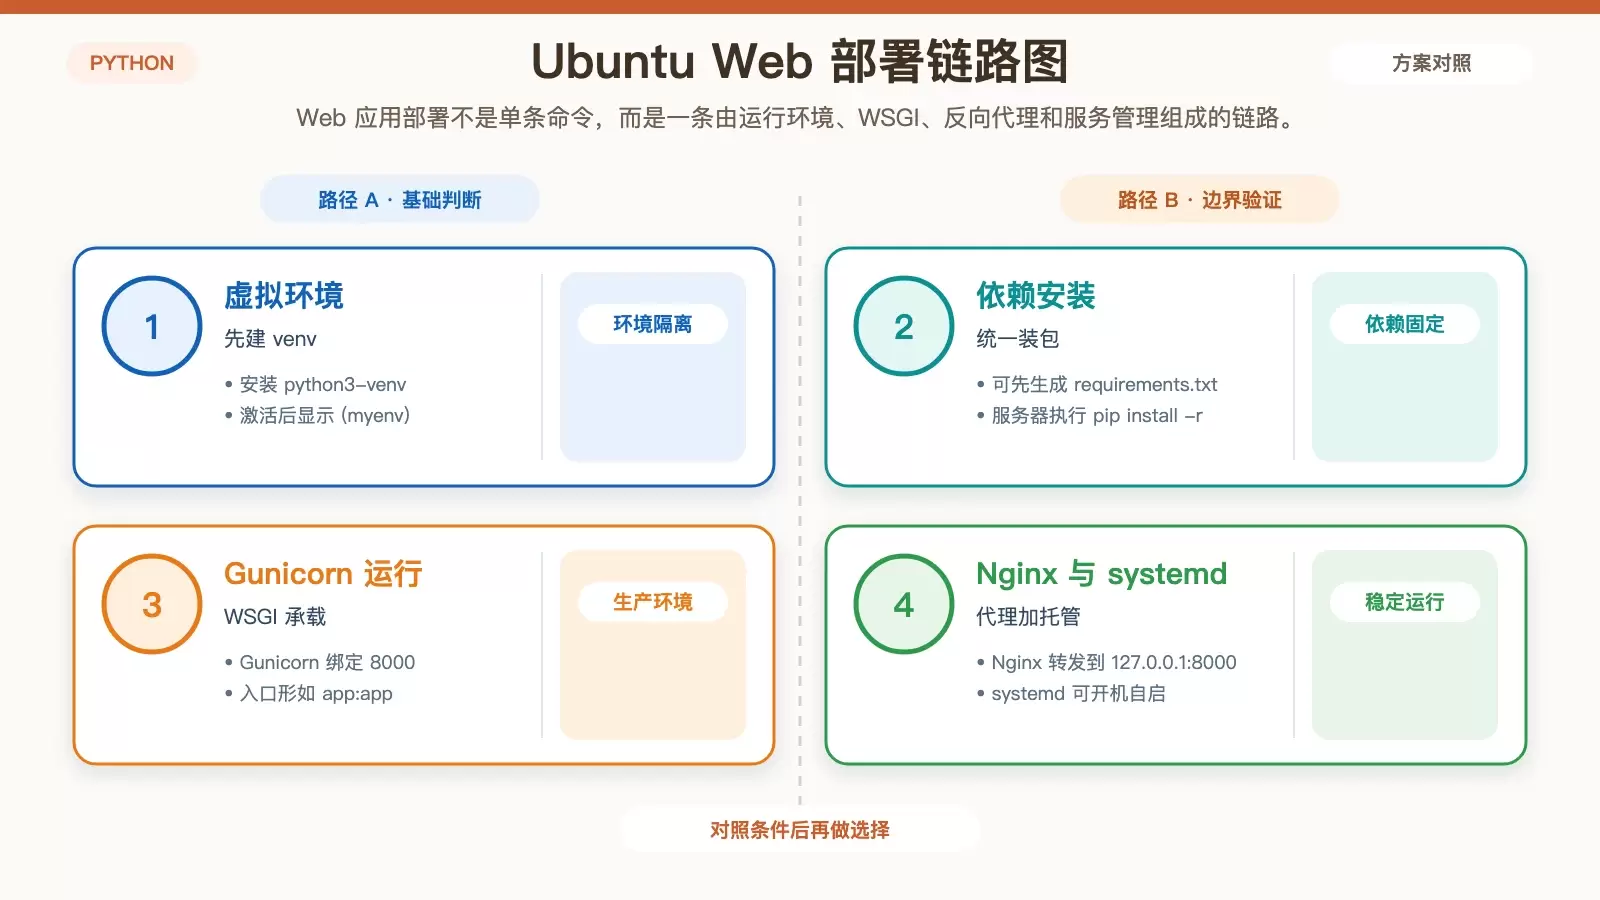
在 Ubuntu 上发布 Python 应用,核心先分清两类场景:把 Flask、Django 部署到服务器,或把脚本打包成可执行文件。本文按这两条路径整理出环境准备、运行方式、反向代理、自启动和打包工具的关键步骤,并补齐实际使用中最容易出错的判断点。