pandas.read_csv() 读取 CSV 文件乱码的排查与解决
在使用 pandas.read_csv() 读取 CSV 文件时,若遇到中文乱码,通常是因为文件编码与读取参数不匹配。本文介绍通过设置 encoding 参数(如 'gbk' 或 'utf-8')解决乱码的方法,并详细说明当直接指定编码报错时,如何利用记事本将文件另存为指定编码格式,从而确保数据正确读取。
2026-10-11
6

在使用 pandas.read_csv() 读取 CSV 文件时,若遇到中文乱码,通常是因为文件编码与读取参数不匹配。本文介绍通过设置 encoding 参数(如 'gbk' 或 'utf-8')解决乱码的方法,并详细说明当直接指定编码报错时,如何利用记事本将文件另存为指定编码格式,从而确保数据正确读取。
本文介绍在Python开发中,如何利用主流代码编辑器(如Notepad++、VS Code、Eclipse、Sublime Text)对选中的代码块进行批量Tab缩进处理。通过简单的快捷键操作(Tab键缩进,Shift+Tab回缩),可快速调整代码层级结构。同时说明编辑器支持将Tab字符转换为指定数量的空格,以满足不同编码规范的需求。
在 Django 测试或迁移过程中,若遇到 'Related model cannot be resolved' 错误,通常是因为 Migration 文件遗漏了对相关 App 的依赖声明。本文介绍如何通过手动执行迁移获取详细报错,定位到具体的 Migration 文件,并在 dependencies 中显式添加缺失的 App 依赖(如 telegrambot)来修复该问题。
数据分析前需统一格式并剔除无效记录。本文基于pandas库演示完整的数据清洗流水线,涵盖多格式读写、空值插补、去重、类型转换、离群点过滤及特征归一化,提供可直接运行的预处理代码,助力快速构建高质量数据集。
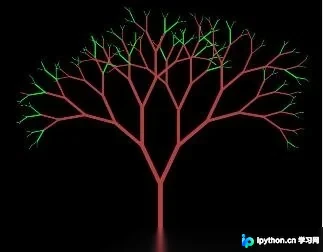
本文介绍如何利用Python的turtle库和递归函数绘制分形树。通过定义树枝长度、角度和颜色,实现自相似的层次结构。代码示例展示了如何递归生成树枝,并根据长度区分颜色,最终形成逼真的分形树效果。
本文深入解析 NumPy 中 shape 属性的含义及其在多维数组中的应用。通过具体代码示例,展示如何创建一维至四维数组,理解 shape 元组中各数字代表的维度长度,并掌握使用冒号进行多维切片的具体操作与结果分析。
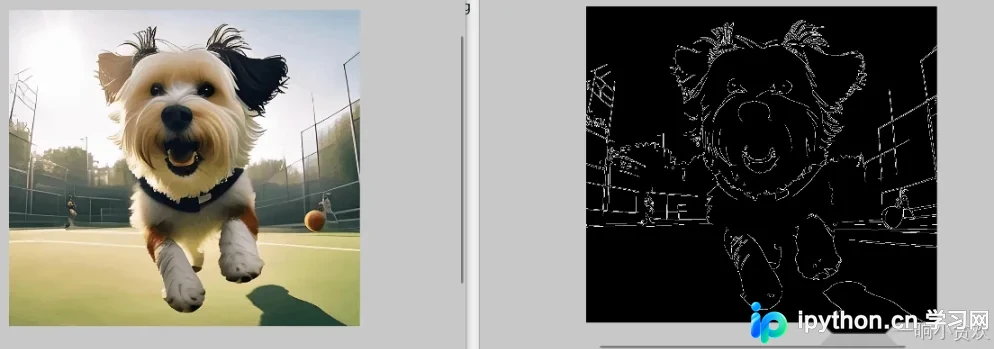
本文介绍如何利用Python的OpenCV与Matplotlib库,结合Canny边缘检测算法将普通照片转换为线条轮廓图。内容涵盖环境准备、基础脚本编写以及基于PyQt5的图形界面批量处理工具,附带参数调整建议与运行效果说明。
本文介绍如何在Anaconda环境中使用pip命令安装第三方Python库。尽管Anaconda已预装部分常用库,但实际开发中常需手动安装特定依赖。通过启动Anaconda Command Prompt并执行pip install命令,可快速完成库的安装与配置。
在Python多线程编程中,子线程抛出的异常默认不会传递到主线程。本文详细解析了通过自定义Thread类、记录异常状态标志位(flag)以及利用traceback模块回溯信息,实现主线程安全捕获子线程异常的具体方法与代码实现。
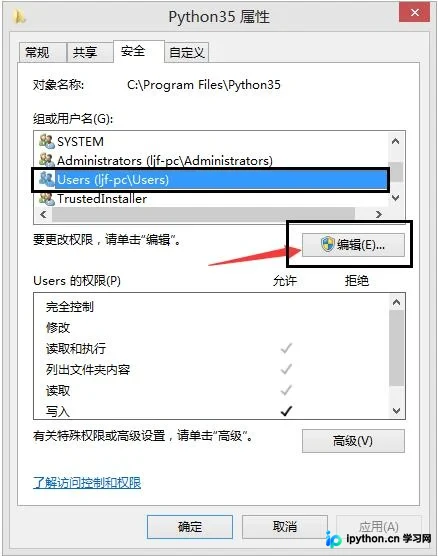
在Windows系统中使用pip安装Python模块时,若遇到“拒绝访问”(WinError 5)的权限错误,通常是因为安装路径位于系统受保护的Program Files目录下。本文详细记录了通过修改Python安装目录安全权限来解决该问题的具体操作步骤,帮助用户顺利完成模块安装。
本文介绍如何使用 pandas 的 concat 函数对 Series 数据进行轴向连接。通过示例演示了默认 axis=0 的连接方式,以及按 axis=1 连接生成 DataFrame 的情况。重点解析了不同轴向操作对结果类型的影响,并展示了索引重叠时的连接行为。
在使用 pip install jupyterlab 安装深度学习交互式笔记本时,常因缺少 Rust 编译环境或依赖损坏导致构建失败。本文详细解析 pywinpty 包的底层依赖机制,并给出基于 conda 通道快速补全组件、绕过本地编译限制的标准操作步骤。