Python3使用SAX解析XML详解与示例
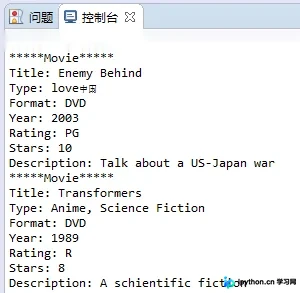
本文介绍Python3中基于SAX(Simple API for XML)解析XML文档的方法。SAX采用事件驱动机制,包含解析器和事件处理器两部分,适用于大型文件或需提取特定信息的场景。文章通过具体代码示例演示如何继承[[wp:a3]]类并实现[[wp:a1]]函数,解析movies.xml文件并输出电影信息。
2026-10-13
6

本文介绍Python3中基于SAX(Simple API for XML)解析XML文档的方法。SAX采用事件驱动机制,包含解析器和事件处理器两部分,适用于大型文件或需提取特定信息的场景。文章通过具体代码示例演示如何继承[[wp:a3]]类并实现[[wp:a1]]函数,解析movies.xml文件并输出电影信息。
本文详解Python3处理JSON及TXT文件时中文乱码的成因与解决。核心在于打开文件时指定encoding='utf-8',并在json.dump中设置ensure_ascii=False,确保中文正常显示而非转为Unicode编码或乱码。
本文详解Python3中urllib与http模块的使用方法。urllib包负责URL处理,包含request、error和parse等子模块,支持通过urlopen打开网页及urlretrieve下载文件。http包提供底层HTTP协议封装,如HTTPConnection用于发送GET/POST请求并获取响应状态码及内容。文章结合代码实例,帮助开发者掌握网络编程基础。
本文介绍Python3中网络请求路径包含中文时引发的UnicodeEncodeError错误。通过示例展示如何利用urllib.parse.quote对中文参数进行编码,从而解决浏览器自动处理而代码需手动编码的问题,确保请求正常发送。
本文介绍如何在Python3中利用requests库结合IP代理池实现随机IP生成。通过从预设代理列表随机选择IP,配置请求头信息,并访问测试网站验证当前IP。该方法适用于需要隐藏真实IP或进行网络爬虫开发的场景,代码简洁实用,可直接参考使用。
本文介绍Python3中判断列表是否为空的两种常用方法。通过示例代码展示如何利用列表在布尔上下文中的真值特性(if a)以及使用len()函数检查长度(len(a) == 0)。这两种方式简洁高效,适用于大多数需要判断列表状态的场景。
本文详解如何在Python3环境下,利用xlrd库读取Excel文件数据,并通过pymysql模块将解析后的数据写入MySQL数据库。文章涵盖环境配置、依赖安装及核心代码实现,帮助开发者快速掌握数据自动化入库流程,适用于日常报表处理与数据迁移场景。
本文提供基于Python3和xlrd库解析Excel文件的完整实例。通过封装open_excel、excel_by_index及read_excel函数,实现按索引打开工作簿、按行列提取数据并转换为字典列表的功能。代码包含处理异常及遍历Sheet的具体逻辑,适用于需要批量读取Excel内容的开发场景。
本文介绍使用Python3实现简单验证码识别的完整流程。通过Pillow库处理图像,利用编辑距离算法计算字符差异,结合GitHub开源字库完成自动登录场景下的验证码解析,适合初学者作为入门Demo参考。
本文介绍在Python3中使用Numpy库将TXT格式的数据文件读取并转换为矩阵的方法。通过打开文件、逐行读取、去除换行符并按空格分割数据,利用列表切片将处理后的数据赋值给预定义的Numpy矩阵对象。文章详细解析了矩阵行索引与数据赋值的逻辑过程,适用于需要批量处理数值型文本数据的场景。
本文介绍Python3中获取当前文件绝对路径的两种常用方法。第一种利用sys.argv直接获取脚本路径;第二种结合os.getcwd()与os.listdir()拼接生成完整路径。文中对比了两种方法返回路径中斜杠方向的区别,并提供了相应的代码示例供参考。
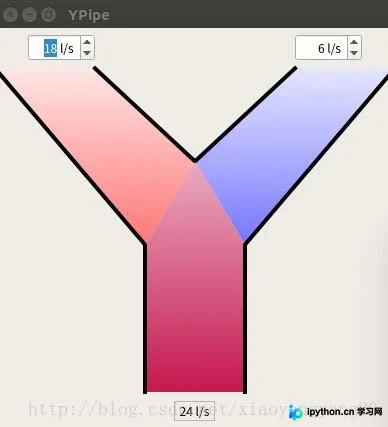
本文介绍如何使用Python3和PyQt5创建一个自定义的流体混合窗口部件。该部件基于逻辑坐标进行绘制,并通过setWindow方法实现坐标系的映射。文章提供了完整的代码示例及运行效果,旨在帮助开发者掌握自定义控件的开发技巧。