

Python DataFrame笛卡尔积优化:从双重循环到Merge的高效实现
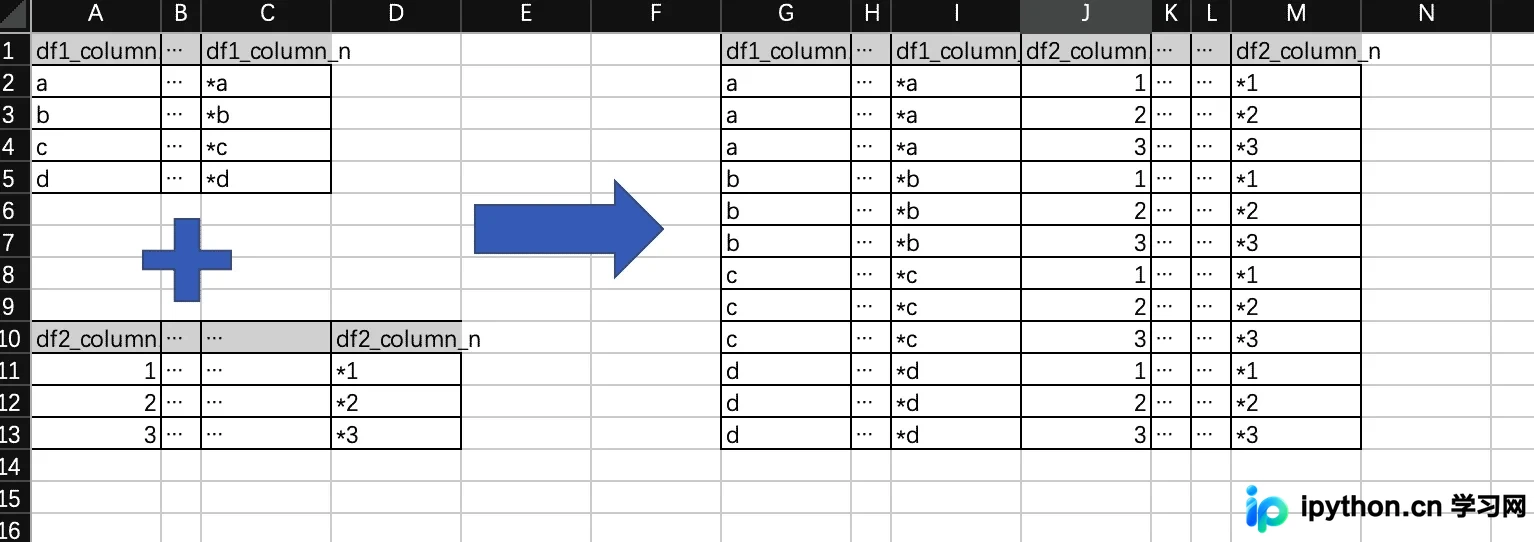
本文介绍如何在Python中高效计算两个Dataframe的笛卡尔积。通过对比双重循环法与基于Merge的优化法,展示了利用Pandas内置功能将时间复杂度从O(m*n)降低至O(n)的技巧,并提供了具体的代码实现与性能测试数据,帮助开发者解决大数据量下的合并性能瓶颈。
2026-10-13
6

本文介绍如何在Python中高效计算两个Dataframe的笛卡尔积。通过对比双重循环法与基于Merge的优化法,展示了利用Pandas内置功能将时间复杂度从O(m*n)降低至O(n)的技巧,并提供了具体的代码实现与性能测试数据,帮助开发者解决大数据量下的合并性能瓶颈。
本文详解 pandas DataFrame 的数据选取与切片操作。重点介绍 loc、iloc、ix 及直接索引四种方式的区别与用法,对比布尔索引在 loc 与 iloc 中的表现差异,并指出 ix 已弃用及 chained indexing 风险,帮助开发者高效处理数据。
本文详解Pandas中将列表转换为数据框的两种场景:多列表合并与嵌套列表转换。通过字典映射和转置操作,展示如何将普通列表或包含子列表的结构高效转化为标准DataFrame格式,适用于数据清洗与预处理环节。
本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。
本文介绍在Jupyter Notebook中解决DataFrame显示过长自动换行或省略的方法。通过调整pd.set_option参数,可自定义整体宽度、高度、最大行列数及单元格内容长度,实现数据表的完整展示与格式化输出,提升数据分析体验。
本文主要介绍如何解决Python中DataFrame打印结果自动换行的问题,通过设置pd.set_option('display.width', 5000)调整显示宽度。同时补充了Python2.7中实现字符不换行打印的三种方法:使用print后加逗号、引用__future__模块自定义end参数以及调用sys模块直接输出,帮助开发者灵活控制输出格式。
本文介绍在 Python Pandas 中为 DataFrame 新增数值列的两种核心方法。通过示例演示如何直接赋值生成单列数据,以及使用 concat 函数按轴拼接已有数据列。涵盖从创建初始 DataFrame 到输出最终结果的完整流程,帮助开发者快速掌握数据框结构扩展技巧。
本文详细介绍Python中Pandas库的核心功能,涵盖Series与DataFrame的创建、数据查看与筛选、行列操作、数据合并及缺失值处理。通过具体代码示例,帮助开发者快速掌握关系型数据的整理、分析与建模技巧,适用于金融、统计及工程领域。
本文介绍在 Pandas 中调整 DataFrame 列顺序的两种常用方法。通过操作列名列表或使用 insert 函数,可以将特定列(如 Mid)移动至第一列。示例展示了从读取 CSV 文件到重新排列列并保存结果的完整流程,适用于数据预处理和特征工程场景。
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵以标识缺失位置。进一步结合any()和sum()方法,展示如何快速判断哪些列包含缺失值并统计每列缺失值的数量,帮助开发者高效处理数据清洗工作。
本文介绍在Python Pandas中处理DataFrame NaN值的方法。通过示例展示如何合并数据产生NaN,并使用where方法结合notnull()将NaN替换为None或其他指定值,帮助开发者进行数据清洗。
本文介绍Pandas库中DataFrame.rename函数的使用方法,用于重命名数据框的行索引或列名。详细解析了mapper、index、columns、axis等关键参数,对比了两种调用约定,并通过代码示例演示了字典映射与函数转换的实际效果,帮助开发者高效进行数据预处理。