

PHP判断搜索引擎蜘蛛(爬虫)的两种实现方法
在PHP开发中,识别访客是否为搜索引擎蜘蛛通常通过解析HTTP_USER_AGENT请求头实现。本文介绍两种常见思路:一是维护包含百度、Google、Bing等主流爬虫标识的全面匹配列表;二是基于“bot”、“spider”、“slurp”等通用关键词进行快速检测。代码展示了如何读取服务器变量并进行字符串匹配,适用于SEO优化、反爬策略或统计访问来源场景。
2026-10-15
6

在PHP开发中,识别访客是否为搜索引擎蜘蛛通常通过解析HTTP_USER_AGENT请求头实现。本文介绍两种常见思路:一是维护包含百度、Google、Bing等主流爬虫标识的全面匹配列表;二是基于“bot”、“spider”、“slurp”等通用关键词进行快速检测。代码展示了如何读取服务器变量并进行字符串匹配,适用于SEO优化、反爬策略或统计访问来源场景。
在 Go 编程中,深层调用链传递 error 时容易丢失上下文。本文介绍了使用 fmt.Errorf("%w") 进行错误包装,结合 errors.Is 和 errors.As 检查与提取错误类型。对于复杂场景,还提供了利用 runtime.Callers 获取完整调用栈的方法,以实现精准定位问题根源。
在Oracle数据库中,直接使用WHERE rownum = 1配合ORDER BY无法保证取得排序后的第一行。正确的做法是使用子查询先完成排序,外层再过滤rownum。对于需获取第N行或按组取首行的复杂需求,应使用ROW_NUMBER() OVER()窗口函数,它比传统多层嵌套更清晰高效。本文详解不同场景下的具体SQL实现步骤。
本文介绍如何利用Golang标准库crypto/sha256计算配置文件的SHA256哈希值,并结合time.Ticker定时轮询机制实现对配置变更的实时监控。当检测到哈希值发生变化时,自动触发配置重载逻辑,确保应用配置及时生效。
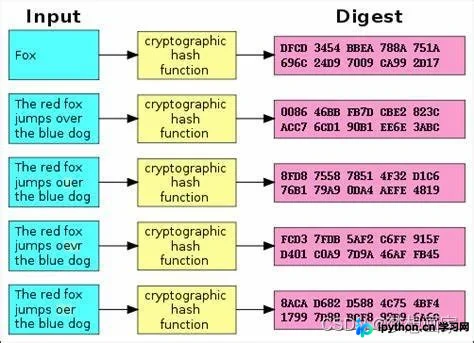
本文深入解析Golang中io.Pipe的用法,演示如何通过管道连接进程间通信。内容包括使用io.Copy重定向程序输出、结合exec.Command实现命令行远程交互、在HTTP处理函数中实时流式响应,以及利用Pipe构造JSON POST请求体。通过具体代码示例,掌握判断数据来源(终端或管道)及标准输入读取技巧。
本文详细解析Go语言中切片(Slice)的底层内存机制,指出频繁扩容导致的性能损耗。通过预分配容量、重用底层数组、结合sync.Pool对象池以及文件读取时的预估分配等实战案例,提供减少GC压力和提升运行效率的具体代码实现方法。
本文详细介绍如何在Go中使用shopspring/decimal库解决浮点数计算精度丢失问题。涵盖库的引入、基本运算操作、数值格式化及比较方法,重点强调所有数据必须通过Decimal初始化的正确用法,避免常见陷阱,适用于金融等对精度要求极高的业务场景。
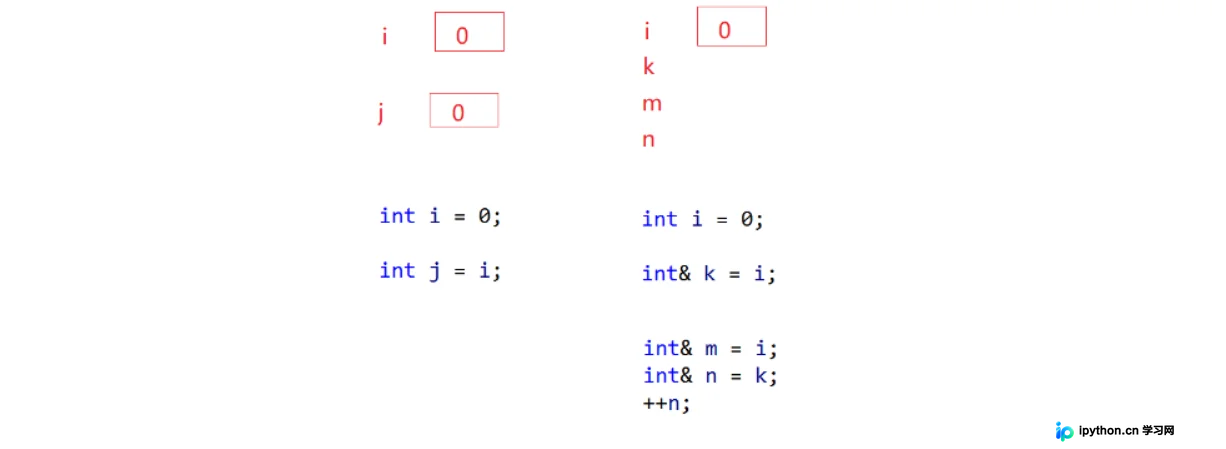
本文详细解析C++中的引用与内联函数。引用作为变量的别名,不开辟新内存空间,需初始化且类型必须匹配,常用于避免拷贝以提升传参和返回值效率。内联函数通过inline关键字建议编译器在编译时展开代码,消除栈帧创建开销,适用于频繁调用的小规模函数。结合底层汇编代码对比,深入理解两者机制差异及常见陷阱。
本文介绍如何使用 Go 语言的 Goroutine 和 sync.WaitGroup 并发执行多个 HTTP 请求。通过示例代码对比串行与并行调用的差异,讲解 Channel 结果收集与等待组配合使用方法,帮助开发者掌握高效并发处理外部 API 的技巧。
本文深入解析MyBatis中ResultMap的高级用法,重点讲解如何处理实体类中的复杂关联属性。通过对比“按照查询嵌套”和“按照结果嵌套”两种方式,演示了多对一(使用association)和一对多(使用collection)关系的配置细节、SQL编写及执行日志分析,帮助开发者避免N+1查询问题并优化数据映射逻辑。
本文介绍如何在PHP中利用fputcsv函数和php://output流,直接将MySQL查询结果以CSV格式输出为Excel文件。该方法避免了全量加载数据导致的内存溢出问题,通过逐行读取、刷新输出缓冲及GBK编码转换,实现高效且无需第三方类库的大数据量导出。
本文详细解析C#中abstract(抽象)与virtual(虚拟)关键字的核心区别。通过代码示例说明如何定义抽象类与方法,以及如何使用override实现虚方法的动态绑定,帮助开发者正确运用多态性避免继承陷阱。