

Python保存数据到文件的常用方法与代码示例
本文系统梳理在 Python 中将内存数据持久化至磁盘的四种主流方案,详细演示 open() 基础文本写入、csv 模块表格导出、NumPy 数组保存及 Pandas DataFrame 多格式转换。结合打开模式参数配置与防覆盖提醒,提供可直接运行的完整代码,助力开发者根据数据结构快速选型。
2026-10-11
7

本文系统梳理在 Python 中将内存数据持久化至磁盘的四种主流方案,详细演示 open() 基础文本写入、csv 模块表格导出、NumPy 数组保存及 Pandas DataFrame 多格式转换。结合打开模式参数配置与防覆盖提醒,提供可直接运行的完整代码,助力开发者根据数据结构快速选型。
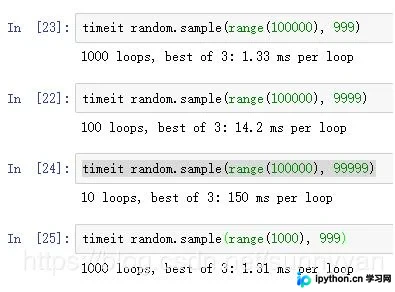
针对Python中random.sample()在大规模数据下执行缓慢的问题,本文介绍了使用numpy.random.choice作为高效替代方案。通过设置replace=False确保无放回抽样,并结合权重参数(weights/cum_weights)实现复杂场景下的随机抽取,显著提升处理效率。
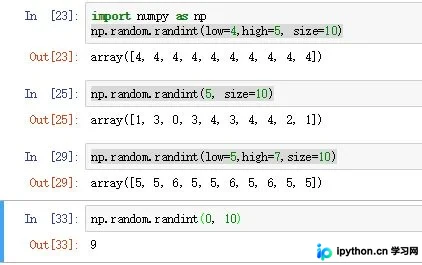
本文详细解析Python中NumPy库提供的random.randint函数,通过参数说明、代码示例与运行结果演示,帮助开发者快速掌握如何在指定半开区间内生成离散均匀分布的随机整数数组,并支持自定义形状、边界及数据类型。
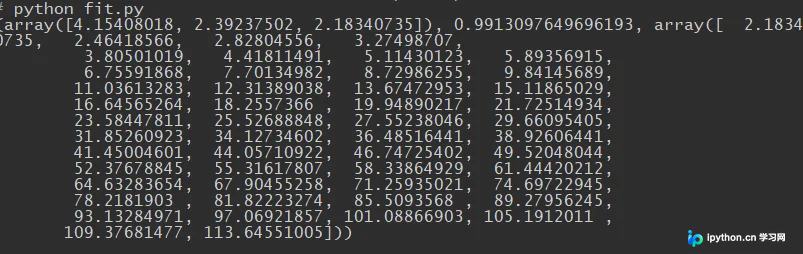
介绍如何使用NumPy库的polyfit函数高效完成数据的非线性多项式拟合。文中详细演示了如何提取多项式系数并自动计算模型的拟合优度(R²),同时揭示了如何借助权重机制与虚拟坐标点,实现拟合曲线强制经过坐标原点的实用技巧。
本文深入解析 Python NumPy 中数组与矩阵相减的底层逻辑,重点阐述广播机制(Broadcasting)在维度不一致时的自动处理规则。通过损失函数计算与多维数组运算的实例,展示一维与二维数组交互时的维度扩展过程,帮助开发者避免维度错误并高效进行矩阵运算。
使用PyInstaller打包包含OpenCV和NumPy的Python程序时,若运行报错“ImportError: numpy.core.multiarray failed to import”,通常由NumPy版本过高引起。建议将Python降级至3.6.8,NumPy降级至1.16.4,并指定OpenCV版本为3.4.5.20以解决兼容性问题。
本文详解如何使用Python读取txt文件指定范围内的数据,并提取每行固定位置的数值。通过逐行分割与numpy批量加载两种方法,结合matplotlib库将提取的x/y轴数据转为折线图,全程提供可直接运行的代码示例与常见报错排查指南,适合日志分析与基础数据处理需求。
本文详细介绍 Python numpy 库中 polyfit 函数的作用与应用场景。该函数主要用于基于最小二乘法的多项式曲线拟合,核心参数包括自变量序列、因变量序列及拟合阶数。通过实际代码演示如何求解一次函数 y=kx+b 的参数,并解释返回值结构与计算机浮点数精度特性,协助开发者快速掌握坐标点拟合与系数提取方法。
本文详解 NumPy 中用于数组合并的 np.vstack() 与 np.hstack() 方法。两者分别实现竖直堆叠与水平拼接,核心差异在于目标轴与维度匹配规则。文章提供完整代码示例,梳理常见报错原因与参数传递技巧,帮助开发者准确重组数据矩阵。
本文介绍如何使用Python的pymysql库连接MySQL数据库,遍历指定数据库下的所有表并统计数据条数。同时,利用numpy库提供的统计函数(如np.mean、np.sum等)处理提取的数据。最后,通过xlwt库将统计结果导出为Excel文件,实现数据库数据量的自动化统计与报表生成。
本文详解NumPy中数组分割与搜索的核心函数。通过np.array_split按指定位置或轴拆分数组,利用np.where快速返回满足条件的元素索引,并结合np.searchsorted在已排序序列中执行二分查找。内容包含准确参数说明、可运行代码示例及常见误区提示,助您高效处理结构化数据。