Python爬虫为何选择MongoDB:灵活性与高性能解析
本文解析Python爬虫选用MongoDB的核心原因。MongoDB采用文档存储方式,直接支持JSON和List结构,无需预定义表结构即可随时创建集合。其模式自由特性允许每条记录字段长度不一致,完美适配爬虫获取的杂乱非结构化数据。此外,MongoDB具备高性能、易部署、支持动态查询及多语言接口等优势,是处理海量爬虫数据的理想选择。
2026-10-14
7

本文解析Python爬虫选用MongoDB的核心原因。MongoDB采用文档存储方式,直接支持JSON和List结构,无需预定义表结构即可随时创建集合。其模式自由特性允许每条记录字段长度不一致,完美适配爬虫获取的杂乱非结构化数据。此外,MongoDB具备高性能、易部署、支持动态查询及多语言接口等优势,是处理海量爬虫数据的理想选择。
MongoDB 默认使用 ObjectId,但某些业务场景需要类似传统数据库的自增整数 ID。本文介绍利用 PHP 驱动调用 `findAndModify` 命令,在名为 'ids' 的辅助集合中实现原子递增($inc)来获取唯一 ID,并提供完整的封装函数与测试代码示例。
本文详解如何使用Python抓取猫眼电影TOP100榜单及电影天堂数据,涵盖静态页面分析、正则表达式提取、User-Agent随机切换及编码处理技巧。重点演示将爬取数据持久化存储至本地CSV文件、MySQL数据库(使用pymysql及executemany批量插入)及MongoDB的具体实现,并提供完整的代码框架与SQL查询示例。
本文介绍如何使用Python通过pyodbc连接SQLServer数据库,读取指定表数据,并利用pymongo将数据批量插入到MongoDB数据库中。示例包含完整的连接配置、数据读取及插入逻辑,适用于数据库间的数据同步场景。
本文详细介绍Python中如何使用PyMongo库与MongoDB数据库进行基本交互。内容涵盖模块安装、模块导入、数据库连接、集合选择以及核心的CRUD(增删改查)操作方法,包括find、insert、update和delete系列函数的使用示例与注意事项。
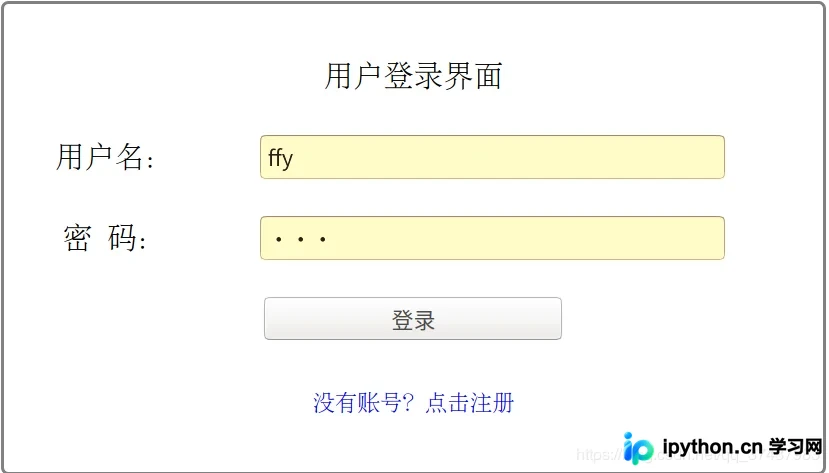
本文介绍使用Python Socket实现FTP文件传输系统的完整案例。系统通过Socket进行客户端与服务端的数据通信,结合Flask构建Web交互界面,支持用户注册登录、文件上传、下载、删除及多进程并发处理。
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
本文详解如何在 Python 中通过 signal 模块接管 Ctrl+C 键盘中断信号。针对从 Redis 读取并批量写入 MongoDB 的场景,演示如何定义自定义回调函数,在程序终止前将缓冲区剩余数据持久化到数据库,避免数据丢失。包含完整代码示例及 C 语言扩展下的行为差异说明。
本文介绍使用Python实现人脸识别验证的完整流程。通过结合face_recognition库进行特征提取,利用TensorFlow构建神经网络模型进行训练,并将数据持久化至MongoDB。代码示例展示了从注册、特征比对到最终验证的逻辑,并指出当前方案在部分遮挡场景下可能存在识别率波动的问题,供开发者参考优化。
本文详细介绍Python中两种主流数据持久化存储方案:MongoDB与MySQL。通过具体代码示例,讲解如何创建连接对象、建立数据库与集合/表,并执行数据插入操作。同时涵盖使用mysql-Front可视化工具进行建库、建表及字段配置的完整流程,为Python开发者提供实用的数据存储实现参考。
本文详细介绍Python中操作Redis和MongoDB数据库的方法。涵盖Redis的直接连接与连接池模式,解析其内存存储机制及性能优势;深入讲解MongoDB的特性、适用场景及与MySQL的互补使用策略。通过具体代码示例,展示如何建立连接、执行数据插入、查询及删除操作,帮助开发者高效管理非关系型数据。
本文详细介绍如何在Python中利用MongoEngine对MongoDB数据库进行高效操作。内容涵盖MongoEngine作为对象文档映射器(ODM)的核心概念、安装方法,以及通过定义Model类实现数据的保存、多条件查询(如年龄范围10至30岁)、排序、字段更新等具体代码示例,帮助开发者降低代码耦合度并优化数据库管理。