Python实现图像随机Patch提取:策略、代码与优化技巧
本文详解在Python中从大图像随机截取多个固定大小Patch的策略,旨在解决数据丰富性不足、IO开销大及覆盖不均等问题。通过固定步长获取坐标并加入随机扰动,结合边界修正与ROI功能,实现高效且覆盖均匀的Patch提取。代码仅计算边界框,后续可根据边缘效应、方差过滤及数量限制进行优化,适用于超分辨率等训练场景。
2026-10-15
5

本文详解在Python中从大图像随机截取多个固定大小Patch的策略,旨在解决数据丰富性不足、IO开销大及覆盖不均等问题。通过固定步长获取坐标并加入随机扰动,结合边界修正与ROI功能,实现高效且覆盖均匀的Patch提取。代码仅计算边界框,后续可根据边缘效应、方差过滤及数量限制进行优化,适用于超分辨率等训练场景。
本文详细解析如何使用Python通过梯度下降法求解逻辑回归模型。内容涵盖线性回归与逻辑回归的对比、Sigmoid函数应用、似然函数推导、目标函数构建及梯度计算。提供完整的Python代码实现,包括Sigmoid预测、损失计算、梯度更新及停止策略,并分析逻辑回归的优缺点。
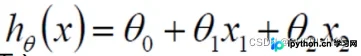
本文通过Python和NumPy库从零实现线性回归模型,封装为类结构。利用sklearn的糖尿病数据集进行训练与测试,涵盖数据预处理、参数初始化、损失计算及交叉验证等核心步骤,并提供完整代码与可视化结果供参考。
本文介绍基于C语言实现的标准化选择题考试系统。通过结构体数组存储试题数据,利用文件I/O函数实现试题库的持久化保存与读取。核心功能涵盖试题录入、随机抽取N道题进行答题、自动判卷计分以及试卷查看,适合C语言初学者理解数据结构与文件操作的综合应用。
本文介绍如何使用OpenCV内置的ANN_MLP类构建神经网络以识别手写数字。通过Keras加载MNIST数据集,配置反向传播算法与Sigmoid激活函数进行模型训练。实验显示100次迭代后准确率达0.9376,且模型文件仅1MB,远小于SVM和KNN,非常适合客户端部署。

本文详细介绍如何使用Caffe的Python接口自动生成solver.prototxt配置文件。重点解析了基于训练集大小、batch_size计算test_interval、max_iter和stepsize等关键参数的方法,并提供了两种Python代码实现方式:字典写入法与protobuf对象法,最后简述了启动训练的流程。
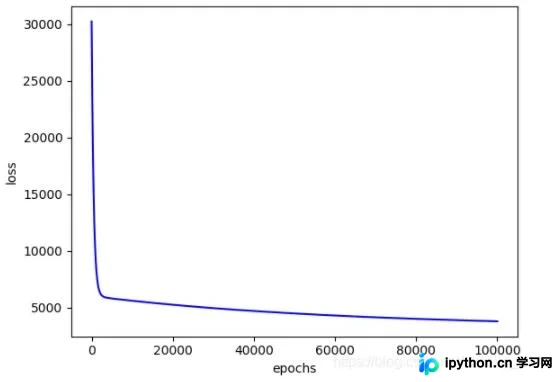
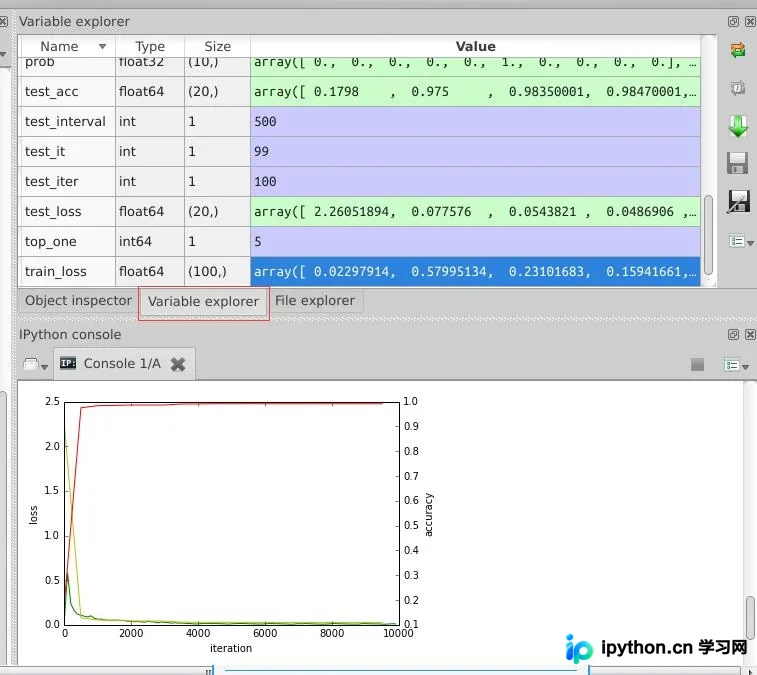
本文介绍如何使用Caffe的Python接口可视化训练过程中的Loss和Accuracy。通过推荐Anaconda环境及Spyder工具,展示如何配置SGDSolver参数,并在迭代过程中收集数据,最终生成训练损失、测试损失及测试准确率的对比图表,帮助开发者直观监控模型训练状态。
本文介绍如何利用Caffe Python接口自动生成deploy.prototxt文件,并基于训练好的caffemodel对新图片进行分类预测。重点解析deploy文件与test文件的结构差异,通过mnist示例展示从生成配置文件到执行分类预测的完整流程,包括图片预处理、网络加载及结果输出。
本文总结GoFrame框架在实际开发中的常见陷阱与最佳实践,包括gf gen dao生成空Columns的排查、利用不定参数简化调用、封装复合结构体管理多表关系、优先使用With替代Join查询,以及基于map切片的批量数据插入方法。通过具体代码示例,帮助开发者提升效率并规避潜在问题。
本文深入解析OpenCV中的图像标注技术,涵盖边界框、多边形分割及语义分割等核心方法。通过Python代码示例,详细演示如何使用cv2模块手动绘制直线、圆形和矩形边界框,并基于K近邻(KNN)算法实现图像颜色分割,为机器学习模型训练提供高质量标注数据。
本文介绍如何使用Python脚本批量检查数据集中的图像可用性。通过多进程技术遍历文件夹,对每张图片进行读取、尺寸校验及JPEG完整性检测,自动识别并删除过小、无法打开或文件截断的错误图像,确保模型训练数据的质量。
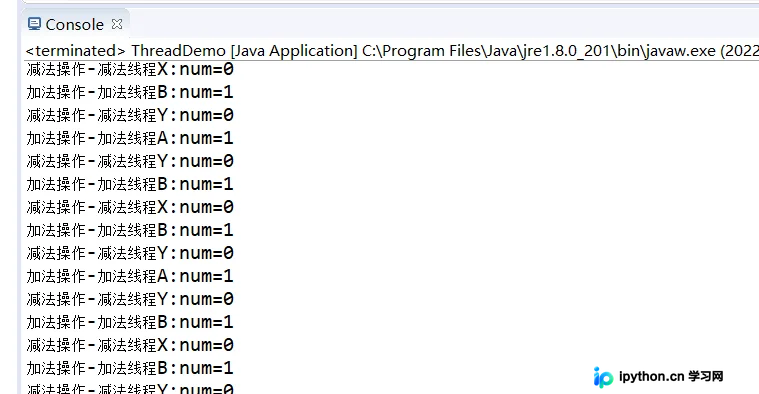
通过三个典型场景解析Java多线程并发控制技术。涵盖利用synchronized与wait/notify实现互斥的数字加减,模拟标准的生产者-消费者模式,以及使用Callable接口处理有返回值的抢答竞争。代码展示线程状态流转与资源锁定机制。