

Python怎么读取txt文件的指定行内容
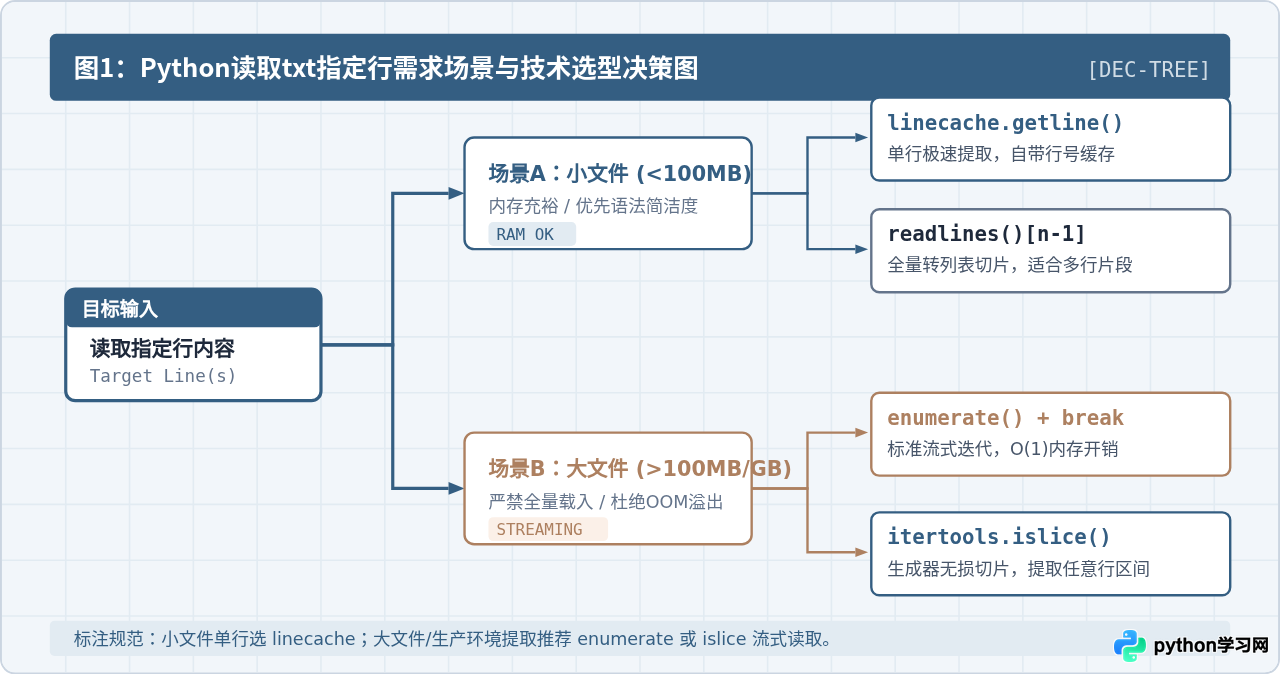
详细讲解Python读取txt文本文件指定行内容的四种常用方法,涵盖linecache模块、enumerate流式遍历、itertools.islice区间切片与readlines列表索引,深入剖析内存机制、性能差异与边界异常处理。
2026-10-22
31

详细讲解Python读取txt文本文件指定行内容的四种常用方法,涵盖linecache模块、enumerate流式遍历、itertools.islice区间切片与readlines列表索引,深入剖析内存机制、性能差异与边界异常处理。
本文介绍使用Python处理自动生成C代码的需求。通过正则表达式匹配以UINT32 O_开头及OUT关键字的行,结合linecache模块按行号截取内容,自动将函数实现转换为extern声明并写入.h文件。该方法适用于批量处理大型C源文件,提高头文件生成效率。
本文介绍Python标准库linecache模块,通过getline方法快速获取文件指定行内容。该方法由traceback模块内部使用,支持从sys.path查找文件。若行号超出范围或文件不存在,均返回空字符串而不报错。针对大文件读取效率低的问题,提供了基于enumerate的手动遍历替代方案,需注意行号从1开始计数。
本文介绍如何使用 Python 批量读取指定目录下的 TXT 文件,并通过 linecache 模块提取特定行数据,经过字符串处理后转换为 CSV 格式。文章提供了完整的代码示例,涵盖文件遍历、行读取、数据清洗及文件写入等关键步骤。
本文介绍如何使用 Python 的 linecache 模块高效处理固定格式的文本数据。通过遍历目录获取文件列表,利用 linecache.getlines() 读取指定行内容,并结合行数判断逻辑,从结构化的报文文件中精准提取匹配分值(matchRatio)或标记未命中状态。该方法适用于日志分析、批量文件处理等场景,代码示例展示了从路径拼接、行数统计到字符串切片提取的完整流程。
本文探讨Python中处理大型文本文件的多种策略,重点分析readline、readlines及文件迭代器的性能差异。通过linecache模块实现高效随机行访问,并展示如何构建自定义迭代器以优化内存占用。针对GB级日志文件,提供从顺序读取到随机定位的具体代码实现与性能考量。