

Python 3.x 迭代器与 next 函数机制详解
本文深入解析 Python 3.x 中迭代器的工作原理,阐述 iter 函数如何生成带有 next 指针的迭代对象。重点说明 Python 3 中 next() 函数已更替为 __next__() 方法,并通过文件读取与字符串遍历两个实例,演示 for 循环底层调用迭代器及显式调用 next 函数的具体过程与 StopIteration 异常处理机制。
2026-10-14
6

本文深入解析 Python 3.x 中迭代器的工作原理,阐述 iter 函数如何生成带有 next 指针的迭代对象。重点说明 Python 3 中 next() 函数已更替为 __next__() 方法,并通过文件读取与字符串遍历两个实例,演示 for 循环底层调用迭代器及显式调用 next 函数的具体过程与 StopIteration 异常处理机制。
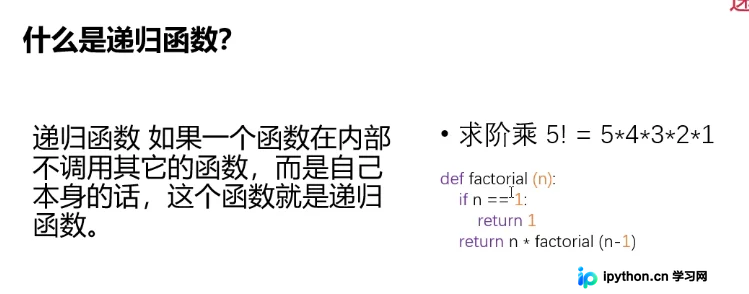
本文深入解析Python递归函数的核心条件与实现逻辑,通过对比循环与递归方式计算阶乘,展示代码差异。同时结合os模块演示如何利用递归遍历树形文件结构,并重点提醒递归调用中潜在的栈溢出风险及内存消耗问题,帮助开发者掌握递归技巧并规避常见陷阱。
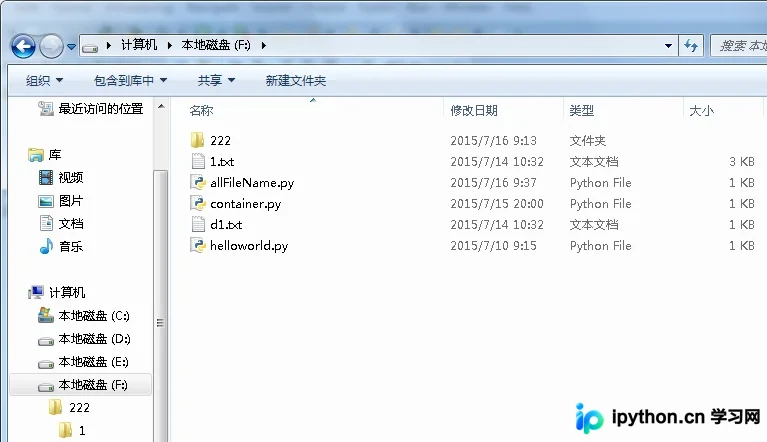
本文介绍Python中读取目录下所有文件夹与文件路径的两种方法。通过os.walk直接遍历,或利用递归函数手动处理。重点解析路径拼接、编码转换及系统保留文件夹的处理,对比两种方式的优劣与适用场景。
本文介绍如何使用 Python 的 linecache 模块高效处理固定格式的文本数据。通过遍历目录获取文件列表,利用 linecache.getlines() 读取指定行内容,并结合行数判断逻辑,从结构化的报文文件中精准提取匹配分值(matchRatio)或标记未命中状态。该方法适用于日志分析、批量文件处理等场景,代码示例展示了从路径拼接、行数统计到字符串切片提取的完整流程。
本文介绍使用 Python 编写的一个简单脚本,用于统计指定目录下的代码行数。通过遍历文件并过滤特定后缀,可快速计算总文件数及有效代码行,适用于送测前的代码量评估及后续自动化统计场景。
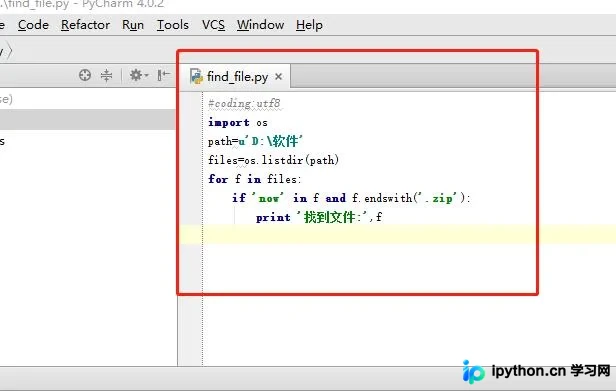
本文介绍如何使用Python的os模块查找指定目录下的文件。通过os.listdir()获取文件列表,结合for循环与if条件判断(如文件名包含特定字符、后缀名匹配),实现精准查找。示例以D:\软件目录为例,查找包含“now”且后缀为“.zip”的文件,并打印结果。
本文介绍了使用Python随机读取指定文件夹下文件的具体实现方法。通过os.walk遍历目录获取文件列表,并利用random模块随机选取其中一个文件路径。文中提供了完整代码示例,并强调了Python3.5环境测试通过及rootdir参数需根据实际目录修改的注意事项,旨在帮助开发者快速掌握该技巧。