Python合并指定文件夹内所有TXT文件的方法
本文介绍使用Python脚本合并同一文件夹下所有TXT文件的方法。通过遍历目录读取内容并写入新文件,实现批量合并。代码包含路径配置、文件读写逻辑及耗时统计,适用于需要整合多个文本数据的场景。
2026-10-14
6

本文介绍使用Python脚本合并同一文件夹下所有TXT文件的方法。通过遍历目录读取内容并写入新文件,实现批量合并。代码包含路径配置、文件读写逻辑及耗时统计,适用于需要整合多个文本数据的场景。
本文介绍在Python中如何遍历指定文件夹及其所有子文件夹,以获取内部所有文件的完整路径和名称。通过示例展示了使用os.walk函数进行递归遍历的两种常见写法,包括列表推导式与递归函数的实现方式,帮助开发者快速处理文件查找任务。
本文介绍如何使用Python批量将目录下的Word文档转换为PDF格式。核心步骤包括利用glob、os.walk或自定义函数遍历目录,并通过Windows COM组件调用Word服务进行转换。该方法要求运行环境为安装有Word(建议2007及以上)的Windows系统,文中提供了完整的遍历与转换代码示例。
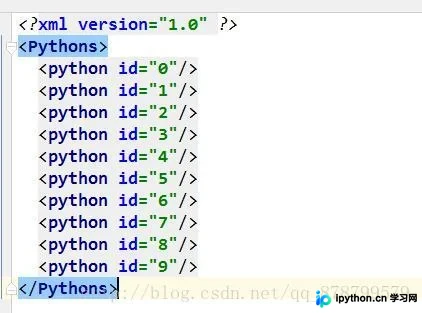
本文详细介绍如何使用 Python 标准库 xml.dom.minidom 进行 XML 文件的生成与读取。通过具体代码示例,演示如何创建带有属性的节点结构并写入文件,以及如何解析现有 XML 文件并提取特定标签的属性值。包含完整的生成与读取代码片段及运行结果分析,帮助开发者快速掌握 Python 处理 XML 数据的核心方法。
本文演示了如何在PHP中利用内建的zip_*系列函数读取ZIP压缩包的内容。通过获取每个文件的名称、大小及压缩方式,并展示提取文件文本内容的具体步骤,帮助开发者掌握基础的文件流处理操作。
本文详细介绍Python标准库shutil模块的核心文件操作功能。涵盖shutil.copy()单文件复制、shutil.copytree()整文件夹备份、shutil.move()文件移动与重命名,以及结合os模块实现的永久删除操作。通过具体代码示例解析各函数的参数行为、返回值及常见错误处理,帮助开发者掌握高效的文件管理技巧。
本文深入解析Python标准库os模块的核心功能,涵盖获取操作系统名称、环境变量、用户信息及CPU数量等系统属性。详细演示os.urandom等函数的使用,并重点介绍abort、exec系列、fork、kill及system等进程管理函数的具体用法与注意事项,帮助开发者掌握Python与操作系统交互的关键技术。
本文系统梳理Python中os模块的29种常用方法,涵盖工作目录获取与切换、多级目录创建删除、文件与目录的重命名及删除、路径拼接与解析、文件属性获取以及系统命令执行等核心功能。通过具体代码示例,详解os.getcwd、os.makedirs、os.path.join等关键函数的用法与返回值,帮助开发者高效进行文件系统交互与环境变量管理。
本文介绍如何利用pandas库向现有CSV文件追加新的列和行数据。首先通过Excel准备包含中文编码的CSV文件,接着演示使用df['列名']赋值方式添加整列数据,以及通过df.loc索引定位添加特定行数据。文中包含完整的代码示例及文件路径、编码格式等关键参数说明,适用于Python初学者进行基础数据操作。
本文介绍使用Python批量处理大量以数字命名的CSV文件的方法。通过遍历指定目录,利用正则表达式筛选有效文件,逐个读取并对指定列进行格式修改,最后将处理后的数据写入新的CSV文件。该方法适用于需要批量修改数据格式的场景,提高了数据处理效率。
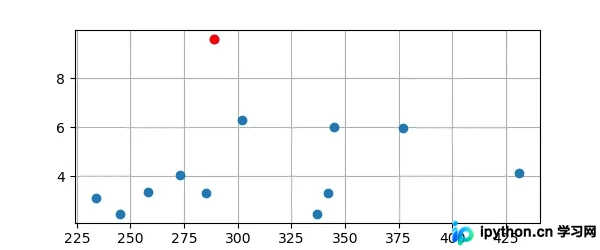
本文介绍如何使用Python的Numpy模块loadtxt方法读取文本文件数据,并结合matplotlib进行可视化。通过示例代码展示如何将读取的数据转换为数组,提取特定列作为坐标轴,计算对数并绘制散点图,同时高亮显示特定数据点,为数据处理与可视化提供基础参考。
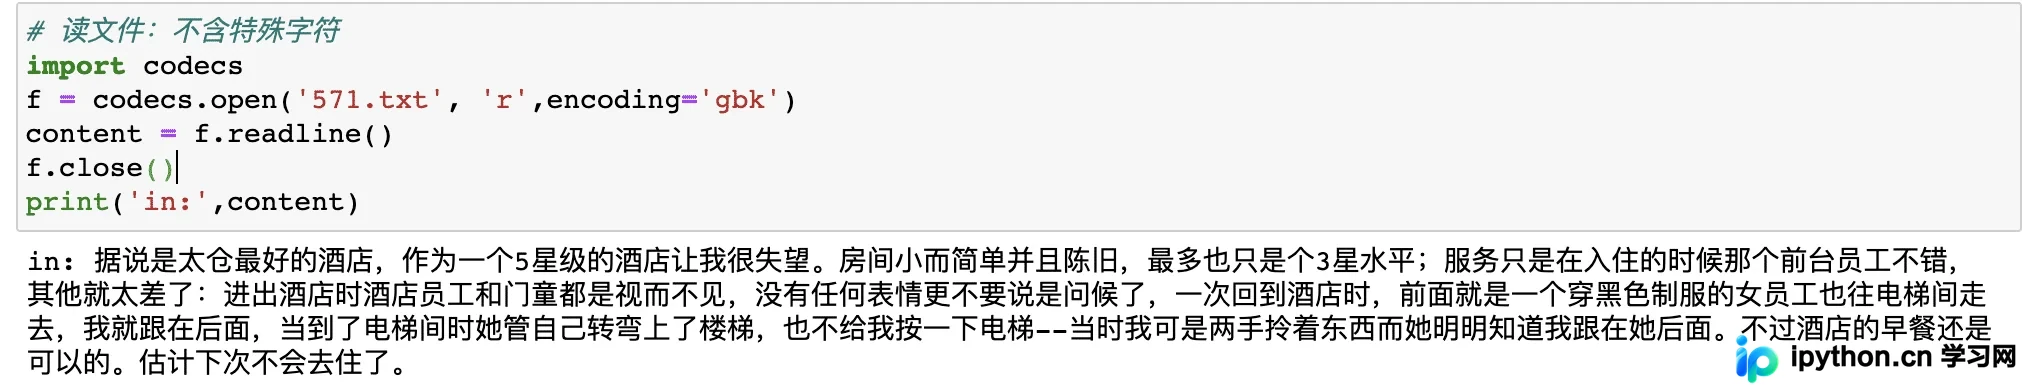
本文解析Python中使用codecs模块读取文件时遇到的UnicodeDecodeError错误。当utf-8与gbk编码均无法正确解析文件,且出现乱码或特殊字符时,可通过在codecs.open中设置errors="ignore"参数来忽略无法解码的字节,从而正常读取文件内容。