Python遍历指定路径下文件并按修改时间区间筛选
本文介绍如何使用Python遍历指定目录下的所有文件,并根据文件的修改时间区间进行筛选。通过结合os.walk与os.stat获取文件信息,利用time模块解析时间戳,实现仅提取指定日期范围内(如7月5日至31日)的Word文档。代码示例展示了如何过滤文件类型、判断时间范围并输出结果列表,适用于需要按时间批量处理文档的场景。
2026-10-14
6

本文介绍如何使用Python遍历指定目录下的所有文件,并根据文件的修改时间区间进行筛选。通过结合os.walk与os.stat获取文件信息,利用time模块解析时间戳,实现仅提取指定日期范围内(如7月5日至31日)的Word文档。代码示例展示了如何过滤文件类型、判断时间范围并输出结果列表,适用于需要按时间批量处理文档的场景。
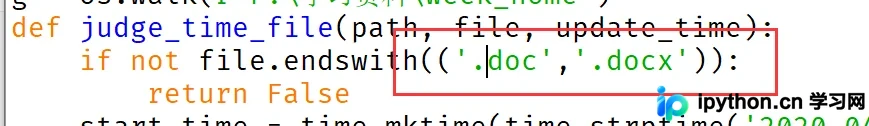
本文详解 Python 中查找特定类型文件的三种常用方法。首先介绍利用字符串后缀匹配的基础方式,随后深入讲解 fnmatch 模块的通配符匹配与过滤功能,以及 glob 模块的简洁路径查找。此外,还演示了如何使用 os.walk 函数递归遍历目录树,结合 fnmatch 实现多级目录下特定格式文件的批量定位与处理。
本文详细介绍Python中读写CSV文件的两种主流方法。首先讲解使用内置csv库进行基础读写操作,包括列名解析与数据写入;随后介绍利用pandas库处理大规模数据的更高效方案,涵盖读取、列重命名及数据导出等高级功能。通过具体代码示例,帮助开发者掌握不同场景下的最佳实践。
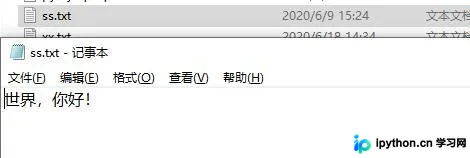
本文详细介绍Python中txt文件的读写操作,涵盖open函数的多种读写模式(r, w, a及其组合)及二进制文件处理技巧。重点解析使用open与with open的区别,强调手动关闭文件可能导致内存溢出的风险,并推荐自动化资源管理的最佳实践,帮助开发者高效、安全地处理文件I/O。
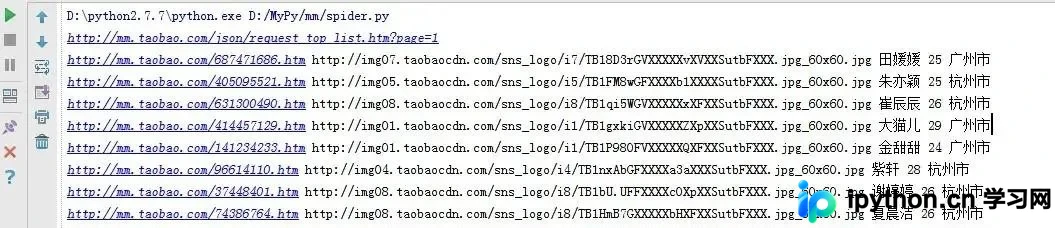
本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。
本文深入解析Python IO编程,涵盖文件读写的基本用法与最佳实践,重点介绍StringIO和BytesIO在内存中处理字符串与字节数据的方法,并详细讲解利用os和os.path模块进行环境变量获取、目录创建删除及路径管理的操作技巧,帮助开发者高效处理I/O任务。
本文介绍Python中覆盖文件内容的实现方法。通过open函数以'w'模式打开文件,写入新内容后关闭,即可覆盖原有数据。同时对比了'a'追加模式,展示两者在文件操作后的结果差异,帮助开发者根据需求选择正确的写入策略。
本文介绍如何使用Python脚本将包含多个子文件夹的目录中的文件,按顺序重命名并分类转移到新的目标文件夹中。通过复制源文件以保留原始数据,利用os和shutil模块创建新目录,并对文件名进行排序后执行重命名与移动操作,确保文件按1至56的顺序对应到各个子文件夹中。
本文介绍Python中shutil模块移动文件的方法,强调src和dst需为绝对路径。针对shutil.copyfile报错[WinError 3]系统找不到指定路径,分析发现是Windows下路径长度限制导致,建议简化路径或存放于根目录以解决。
本文详细介绍 Python 第三方库的安装方式,包括使用 pip 命令及源码安装方法,并说明如何离线复制 site-packages 目录以迁移库文件。同时深入解析 Python 标准库 shutil 的功能,涵盖文件与目录的复制、移动、删除操作及元数据处理的注意事项,帮助开发者高效管理 Python 环境。
本文详细介绍如何使用Python的os模块实现文件和文件夹的复制功能。通过封装copy_function,利用os.listdir、os.path.isdir及文件读写操作,实现了从简单文件复制到支持递归复制文件夹的完整方案。代码包含基础版与改进版,并提供了自定义mycopy函数的示例,帮助开发者掌握Python文件处理的核心技巧。
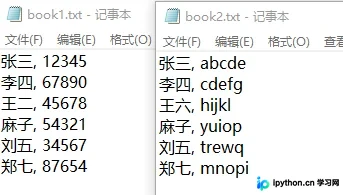
本文详细介绍Python中文件与目录的常用操作方法。通过两个实战案例,演示如何利用os模块递归遍历文件夹以计算总大小、查找最大及最小文件,以及如何读取并合并两个文本文件的内容。文章涵盖open、os.path.getsize、listfiles等核心函数的使用,提供完整代码示例与关键步骤解析,帮助开发者掌握Python文件处理技巧。