

Python3读取文件指定行的三种方法
本文深入探讨Python3中读取文件指定行的三种主流方案。针对大文件场景,对比了基于readline的逐行遍历、linecache模块以及调用系统sed命令的执行效率。测试显示,读取5000万行时,sed方案耗时仅约2.5秒,显著优于纯Python实现的10秒以上耗时,为高性能数据处理提供了实用参考。
2026-10-14
6

本文深入探讨Python3中读取文件指定行的三种主流方案。针对大文件场景,对比了基于readline的逐行遍历、linecache模块以及调用系统sed命令的执行效率。测试显示,读取5000万行时,sed方案耗时仅约2.5秒,显著优于纯Python实现的10秒以上耗时,为高性能数据处理提供了实用参考。
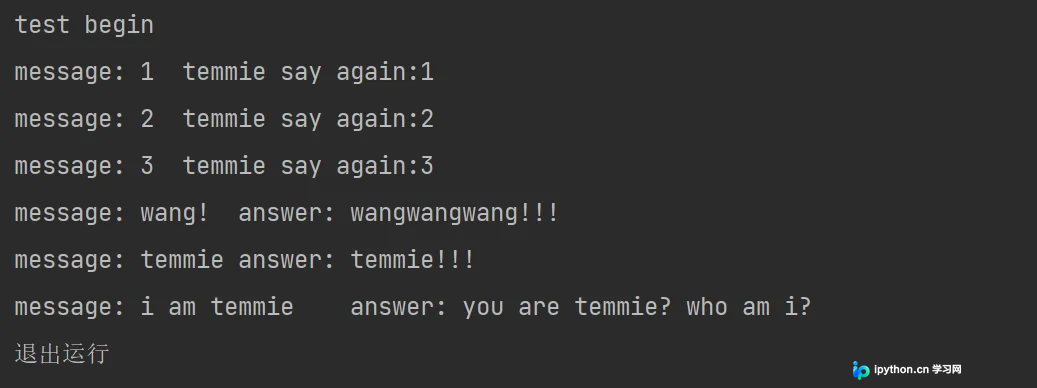
本文介绍如何利用Python的文件读写功能,结合字典匹配与定时轮询机制,开发一个简易的本地聊天机器人。通过监听指定文本文件的变化,程序可实现预设回复或复读功能,适合Python初学者理解IO操作与基础逻辑控制。
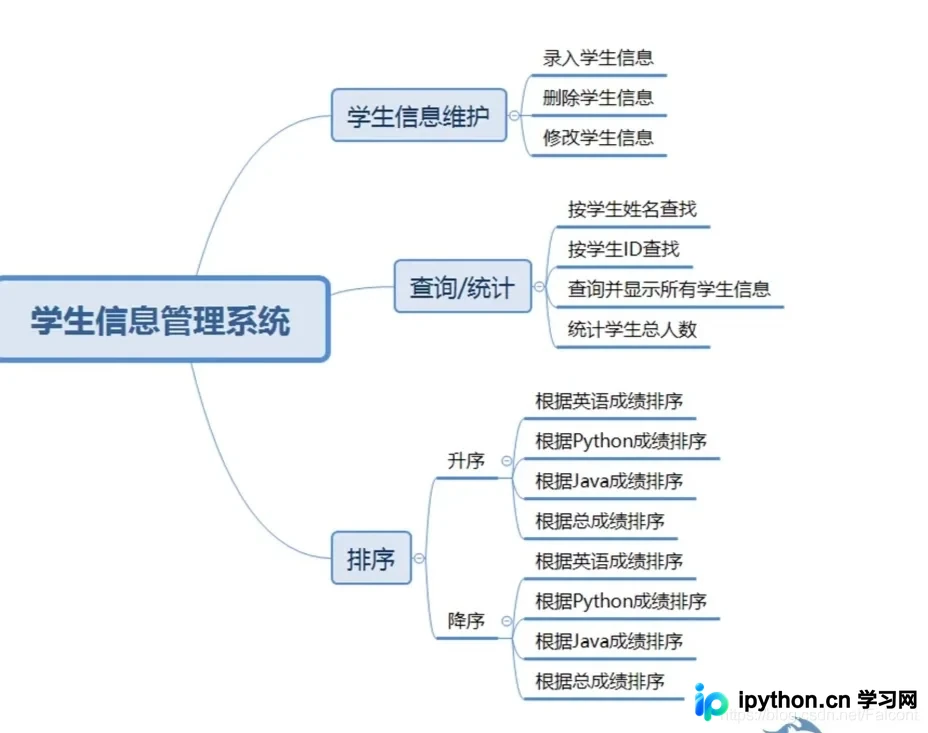
本文详细介绍如何使用Python构建简易学生信息管理系统。内容涵盖文件读写、字典列表操作、增删改查及按成绩排序等核心功能实现。重点解析sort()函数参数用法,并提供将Python脚本打包为独立EXE可执行文件的完整步骤,适合Python初学者巩固基础并提升工程实践能力。
本文详解Python中文件读取、写入及追加模式的使用方法,涵盖open、read、readlines等核心函数。深入解析try-except异常处理机制,包括ZeroDivisionError和FileNotFoundError的处理及静默失败技巧。最后介绍利用json模块进行数据持久化存储与重构的最佳实践,帮助开发者掌握文件IO与错误管理的核心技能。
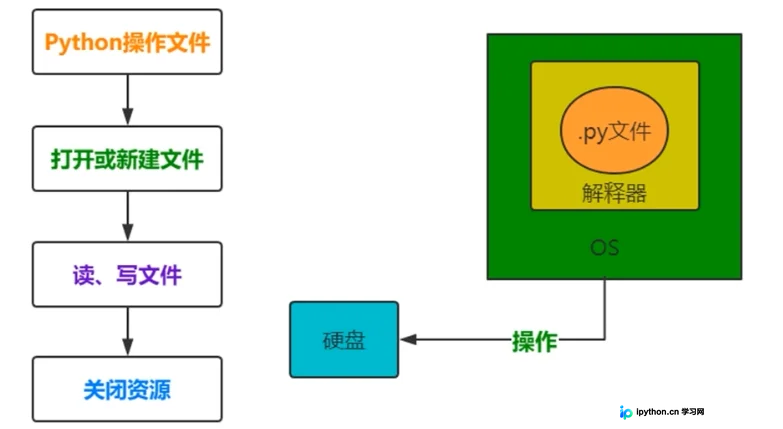
本文详细解析Python中的文件I/O操作原理,涵盖从打开、读写到关闭资源的完整流程。重点讲解open()函数的语法与默认编码,对比r、w、a等多种打开模式及二进制处理。同时介绍文件对象的常用方法,并系统梳理目录创建、复制、重命名、移动及删除等管理操作,帮助开发者掌握Python文件处理核心技能。
本文详细介绍Python中Num库对文本文件、CSV格式及二进制文件的读写操作。通过savetxt与loadtxt函数实现TXT/CSV数据的存取,利用save、savez及load函数处理.npy与.npz二进制格式,涵盖参数配置、编码设置及多数组存储等核心功能。
本文详细讲解Python3中json模块的四大核心功能:dumps、dump、loads和load。通过字典、列表及字符串的编码示例,展示如何将Python对象转换为JSON格式字符串;同时演示利用loads进行解码及参数sort_keys、indent的使用。最后介绍JSON文件的标准读写流程及类型对照关系,帮助开发者掌握日常数据交换需求。
本文详解使用pandas读取txt、csv、excel及pkl文件的具体命令。重点解析read_csv与read_table在处理非标准分隔符txt文件时的差异,通过sep参数解决列解析错误。同时提供线上部署模型时读取excel和pkl文件的完整Python代码示例,涵盖路径适配与测试流程。
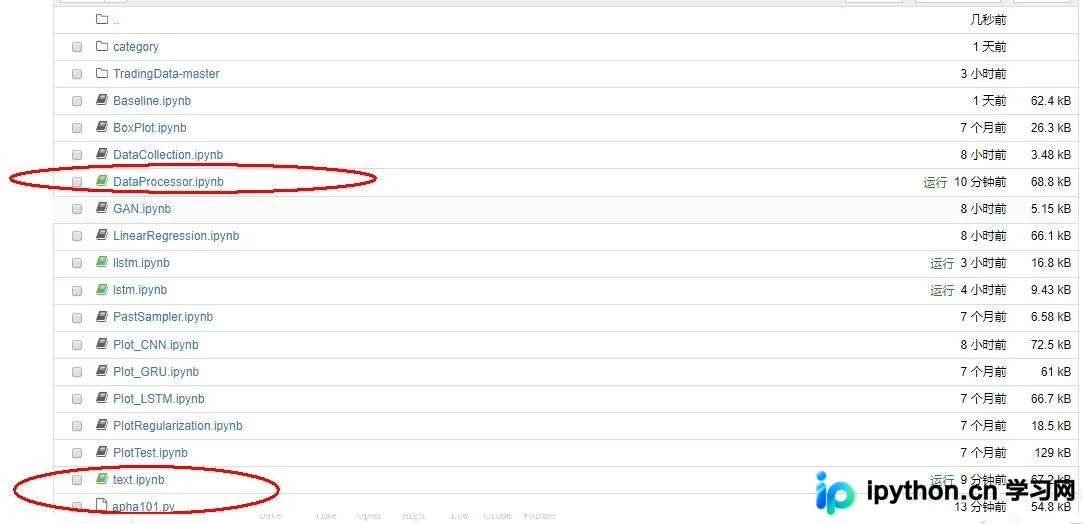
本文解决Jupyter Notebook中因路径包含特殊字符\v被错误翻译为\x0b导致的文件找不到问题,建议通过双斜杠修正路径。同时针对同目录.ipynb导入.py文件提示模块不存在的异常,提供重建Notebook实例的排查方法,帮助开发者快速恢复环境配置。
本文详细介绍Python中利用xml.etree.ElementTree模块处理XML文件的核心方法。内容涵盖从文件读取根节点、遍历子节点与属性,到精准查找特定标签数据。同时演示如何修改节点内容与属性、删除节点并保存文件,以及通过Element和makeelement两种方式构建新的XML文档结构,提供完整代码示例供参考。
本文详细介绍 Python 标准库 os.path 模块中 exists() 函数的用法,用于判断指定文件或目录路径是否存在。通过具体代码示例演示如何检测文件存在性,并补充结合 os.makedirs() 自动创建缺失目录及保存数据的完整操作流程,帮助开发者高效处理文件路径检查与目录管理任务。
本文介绍如何使用Python的xlrd库封装简单的Excel和TXT文件读写函数,实现数据到字典或列表的快速转换,并解决因Unicode与ASCII编码不兼容导致的中文乱码问题,提供可直接复用的代码示例。