

Python爬虫urllib库基础用法详解
本文详细介绍Python内置爬虫库urllib的核心模块。涵盖urllib.request的urlopen()与urlretrieve()方法,演示GET/POST请求及文件下载;解析urllib.parse的urlencode、urlparse等URL处理函数;并讲解urllib.error中URLError与HTTPError的区别及捕获规范。基于Python 3.7.4环境,提供完整代码示例与参数说明。
2026-10-12
6

本文详细介绍Python内置爬虫库urllib的核心模块。涵盖urllib.request的urlopen()与urlretrieve()方法,演示GET/POST请求及文件下载;解析urllib.parse的urlencode、urlparse等URL处理函数;并讲解urllib.error中URLError与HTTPError的区别及捕获规范。基于Python 3.7.4环境,提供完整代码示例与参数说明。
在Python中通过键获取字典值时,若键不存在会抛出KeyError导致程序中断。本文介绍两种健壮的处理方式:一是使用dict[key]配合in判断,二是利用dct.get(key, default)设置默认值。这两种方法能有效避免异常,确保程序稳定运行。
本文详细解析 Python PEP8 编码规范,涵盖代码布局、缩进、行宽、导入顺序、字符串使用、空格规范、注释、命名规则及编程建议。通过正误示例对比,帮助开发者编写整洁、高效且符合社区标准的 Python 代码,提升代码可读性与维护性。
本文详细解析Python中requests库的核心用法,涵盖安装配置、GET与POST请求参数传递、JSON解析、文件保存、Headers与代理设置、Cookie会话维持、证书验证及超时异常捕获等关键操作,帮助开发者高效构建稳定的网络爬虫程序。
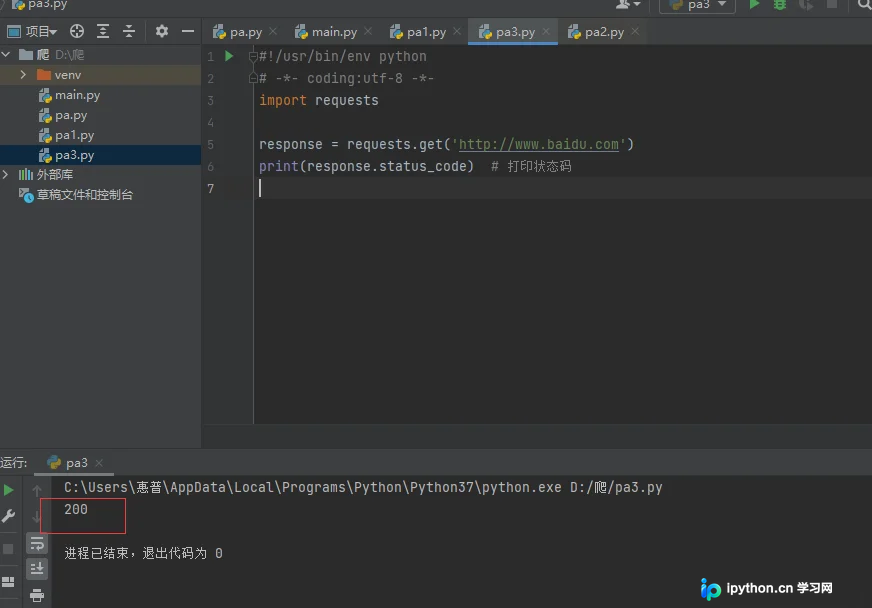
在读写文件前验证路径有效性是避免程序异常的关键。本文系统梳理Python中判断文件或文件夹是否存在的三种标准方案:基于os模块的路径与权限校验、利用try-except捕获异常直接尝试访问,以及现代标准的pathlib路径对象检测。结合完整代码示例说明适用场景与操作细节。
本文详细解析Python运行时报错的根本原因,系统梳理try/except、else与finally语句的实际用法,并演示如何通过raise主动抛出异常及利用assert进行环境或逻辑校验,帮助开发者编写更健壮的代码。
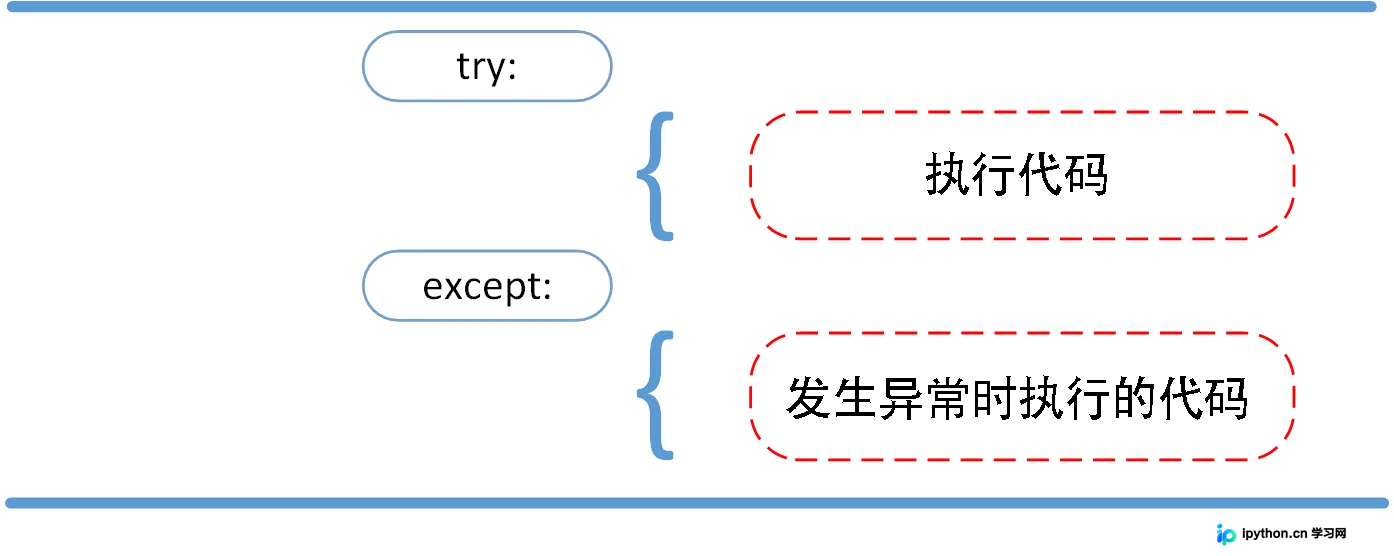
Python 内置的 urllib 库提供了处理 URL 和发送 HTTP 请求的标准能力。本文系统讲解 request、parse 与 error 三大核心模块,通过完整代码演示基础 GET/POST 请求发起、自定义 Header 突破简单反爬、URL 特殊字符编码、远程文件直存以及网络异常安全捕获等高频场景,助力开发者高效编写轻量级网络脚本。
本文系统讲解Python中的异常处理机制。通过对比语法错误与运行异常,详细说明try-except语句的捕获逻辑、多分支匹配顺序及继承关系。结合raise主动抛出、finally资源清理以及自定义异常类实战,提供可直接复用的代码模板,帮助开发者提升程序健壮性与调试效率。
简述传统类模拟枚举的缺陷,引入标准库 enum 模块。说明如何继承 Enum 或 IntEnum 创建枚举,掌握成员访问、值获取、唯一性校验及禁止外部修改等核心用法,帮助开发者安全规范地定义业务常量。
本文详解 Python 异常处理机制,重点介绍如何利用 traceback 模块获取错误堆栈信息,并通过 logging 模块将其持久化写入日志文件。通过具体代码示例,演示了手动写入文件和使用 logging.exception() 两种方案,帮助开发者在捕获异常时保留完整的调试上下文,同时保持程序继续运行。
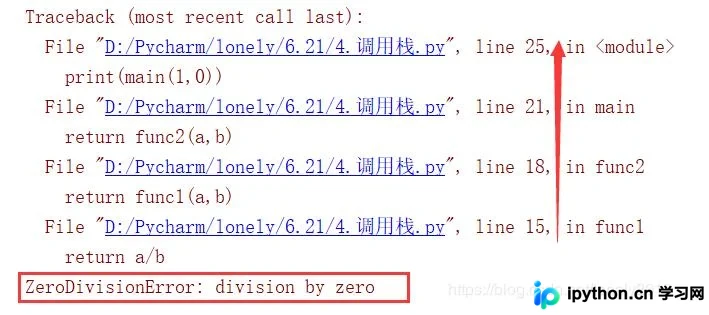
本文深入解析Python中with语句的工作原理及其在上下文管理器中的应用。通过对比传统open()与with open()的区别,详细阐述__enter__和__exit__方法的执行时机。结合自定义类示例,展示如何在异常发生时利用__exit__参数进行错误处理与资源清理,确保代码的健壮性与资源安全。
本文详细讲解如何使用Python内置的zipfile模块处理ZIP文件,涵盖基础文件打包、目录递归压缩、数据解压提取、元数据读取及添加注释的方法。同时介绍针对敏感文件的AES加密方案与BadZipFile异常拦截技巧,帮助开发者高效安全地管理归档任务。