

Python3使用requests获取网页并处理编码问题
本文介绍在Python3中使用requests库获取网页内容时,如何正确处理编码问题。通过设置r.encoding或r.apparent_encoding属性,可以有效解决网页乱码问题,并演示了将网页内容保存为本地文件的完整流程。
2026-10-11
6

本文介绍在Python3中使用requests库获取网页内容时,如何正确处理编码问题。通过设置r.encoding或r.apparent_encoding属性,可以有效解决网页乱码问题,并演示了将网页内容保存为本地文件的完整流程。
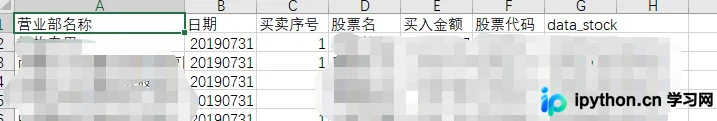
本文详细介绍如何使用pandas库高效处理CSV文件。涵盖指定编码(如GBK)读取数据、日期字段类型转换、多列字符串拼接、基于符号的数值计算、数据分组聚合以及去重保存等核心操作步骤,帮助开发者快速完成数据清洗任务。
本文解决PHP通过exec调用Python3脚本时返回中文乱码的问题。核心在于统一编码处理:PHP端使用urlencode对参数进行转码,Python端通过urllib.parse.unquote解码,并配置sys.stdout为UTF-8编码输出。确保跨语言调用时字符编码一致,避免乱码。
在 Python 中将包含 UTF-8 BOM 的文件内容转换为列表时,首个元素常出现不可见的 \ufeff 字符。本文通过读取文件、分割字符串并展示问题,随后介绍使用 `encode('utf-8').decode('utf-8-sig')` 方法去除 BOM 的正确操作,确保数据清洗的准确性。
本文详解Python网络爬虫中常见的乱码问题,涵盖中文、日文等多语言编码处理。通过解析HTTP Header、Meta标签及Document定义确定源编码,并介绍使用chardet库自动检测编码的方法。结合Python 2.7实例,演示如何正确进行字符串解码与编码转换,确保数据准确存储。