
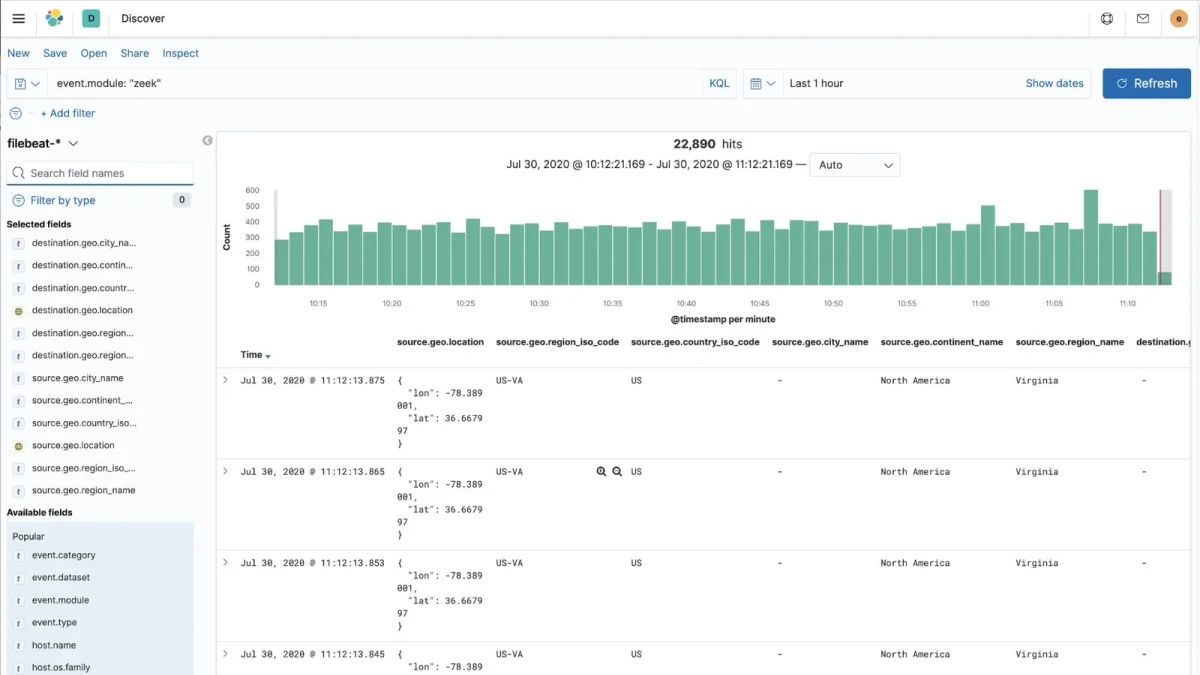
ELK日志栈:Filebeat模块配置与多行过滤
介绍如何使用 Filebeat 模块采集常见服务日志,并通过多行过滤正确合并堆栈跟踪等跨行日志,完成从配置、采集到 Elasticsearch/Kibana 验证的完整流程。
2026-09-09
6


介绍如何使用 Filebeat 模块采集常见服务日志,并通过多行过滤正确合并堆栈跟踪等跨行日志,完成从配置、采集到 Elasticsearch/Kibana 验证的完整流程。
本文介绍一种使用Python将MySQL数据同步至Elasticsearch的轻量级方案。针对Logstash-input-jdbc同步频率低的问题,该方案通过读取MySQL更新字段的时间戳进行增量查询,并设定10秒同步间隔。通过对比上次同步时间与当前时间解决服务器时间差,利用MySQL ID作为ES ID避免重复,确保数据同步的实时性与完整性。
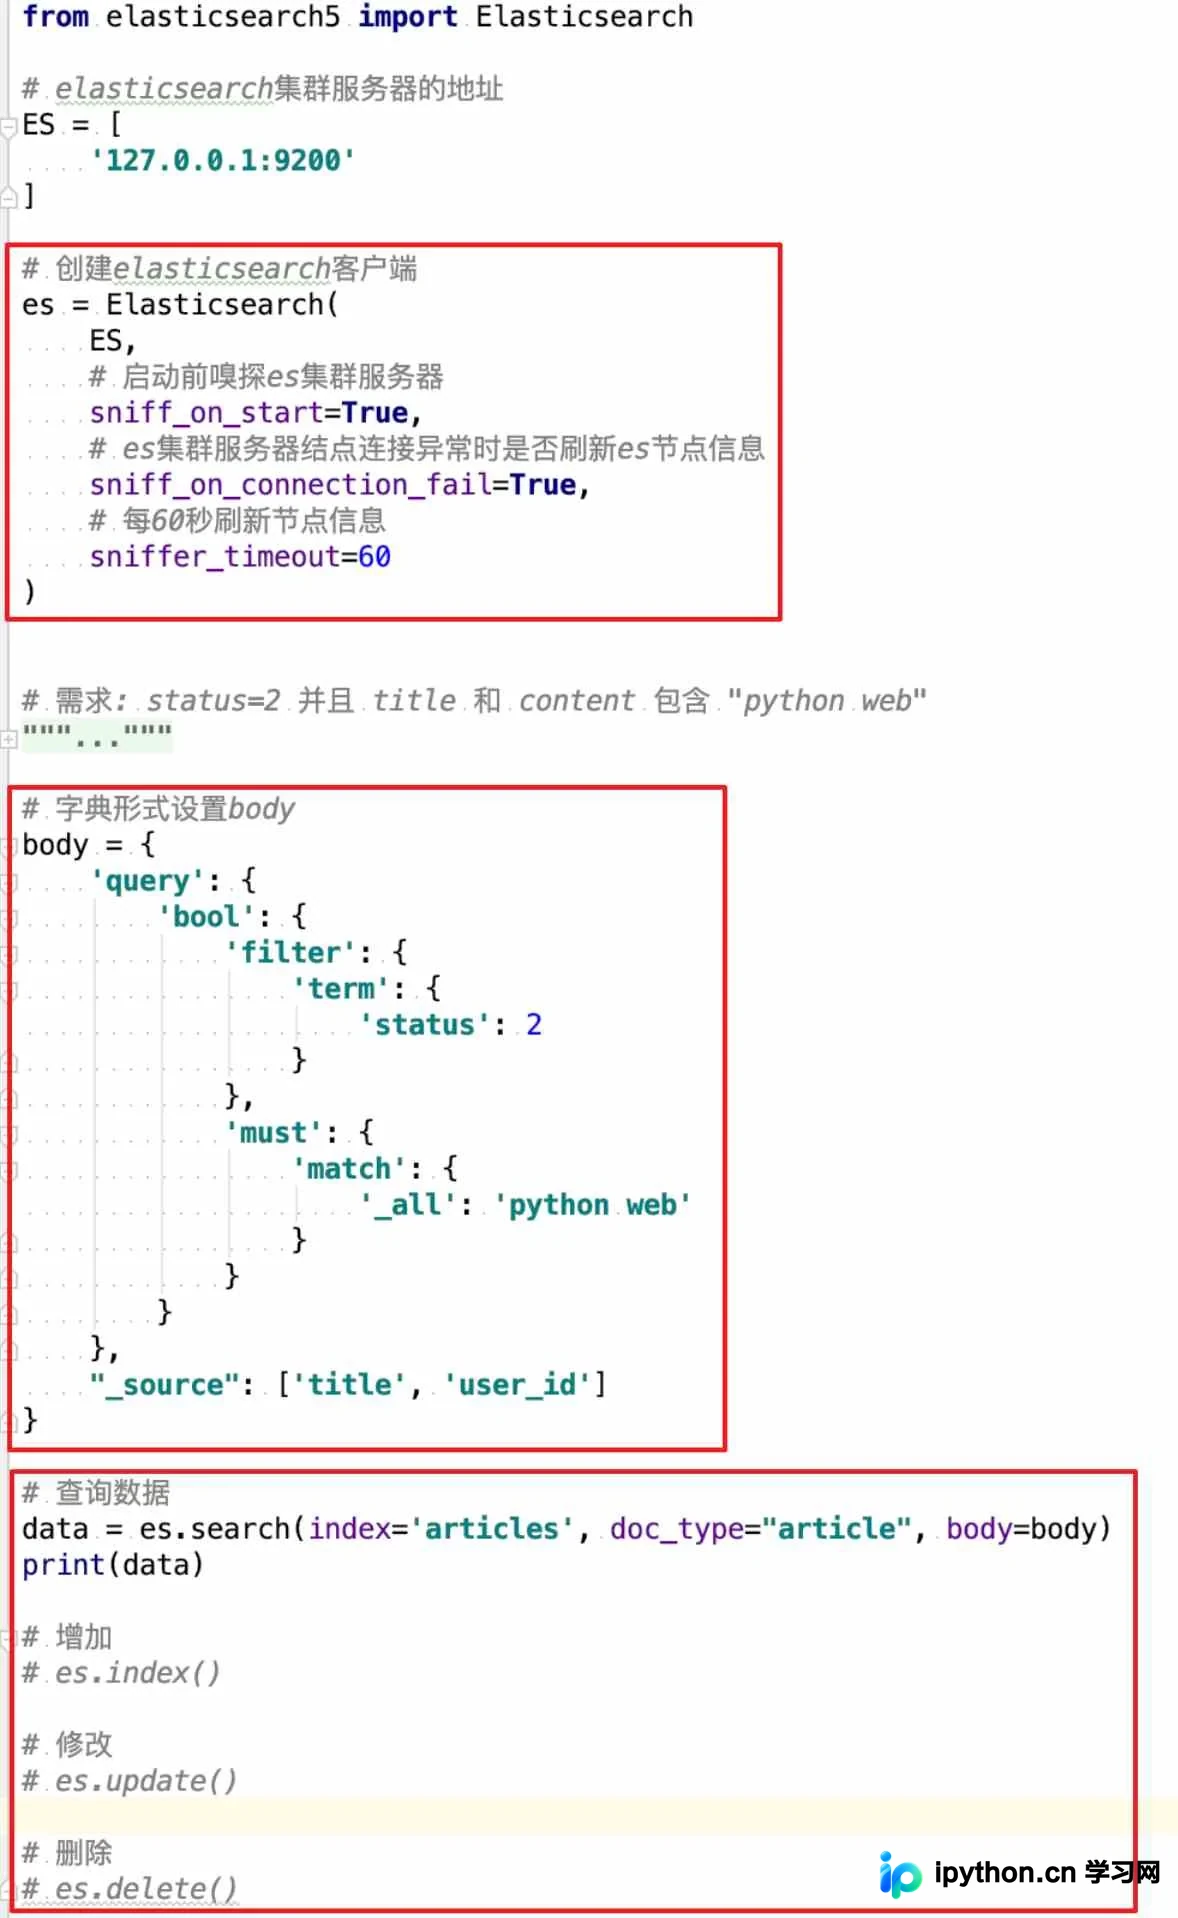
本文详细介绍如何使用Python操作Elasticsearch。内容涵盖模块安装、ES客户端对象的创建配置,以及具体的数据搜索和添加示例。通过代码演示,帮助开发者快速掌握基于Python进行ES交互的核心步骤,适用于需要集成搜索引擎功能的项目场景。
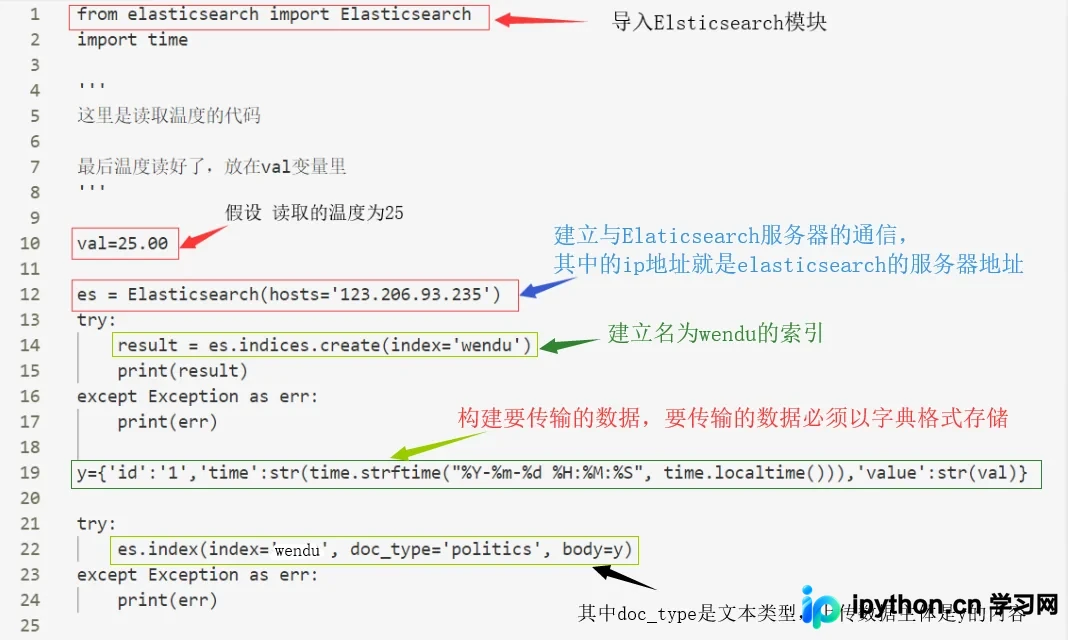
本文详解如何使用Python与Elasticsearch进行索引创建及数据上传。Elasticsearch是基于Lucene的分布式搜索引擎,Python通过官方库可高效管理索引与文档。文章通过温度传感器数据示例,演示从连接服务器到上传数据的完整流程,帮助开发者掌握ES基础操作。
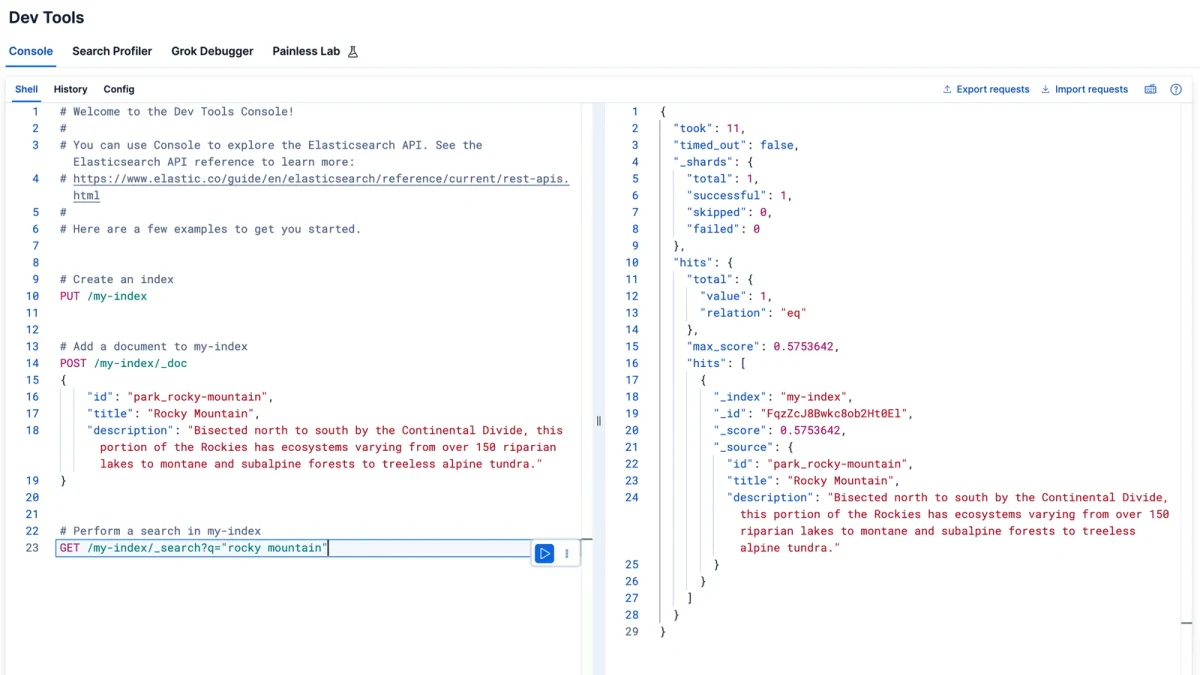
对比 Elasticsearch 与 MySQL FULLTEXT 的核心原理、适用场景、基础操作和效果验证,帮助读者根据数据规模、查询复杂度与运维成本选择合适的全文检索方案,并避开常见配置与性能陷阱。
本文介绍纯Python开发的轻量级ETL框架pyetl。通过pip3安装后,可实现关系型数据库、Hive及Elasticsearch间的数据同步。支持字段映射与字段级UDF进行数据清洗和标准化,并可继承Task类灵活扩展ETL任务逻辑。