

使用Scrapy框架爬取虎扑网页数据并存储至MySQL实战
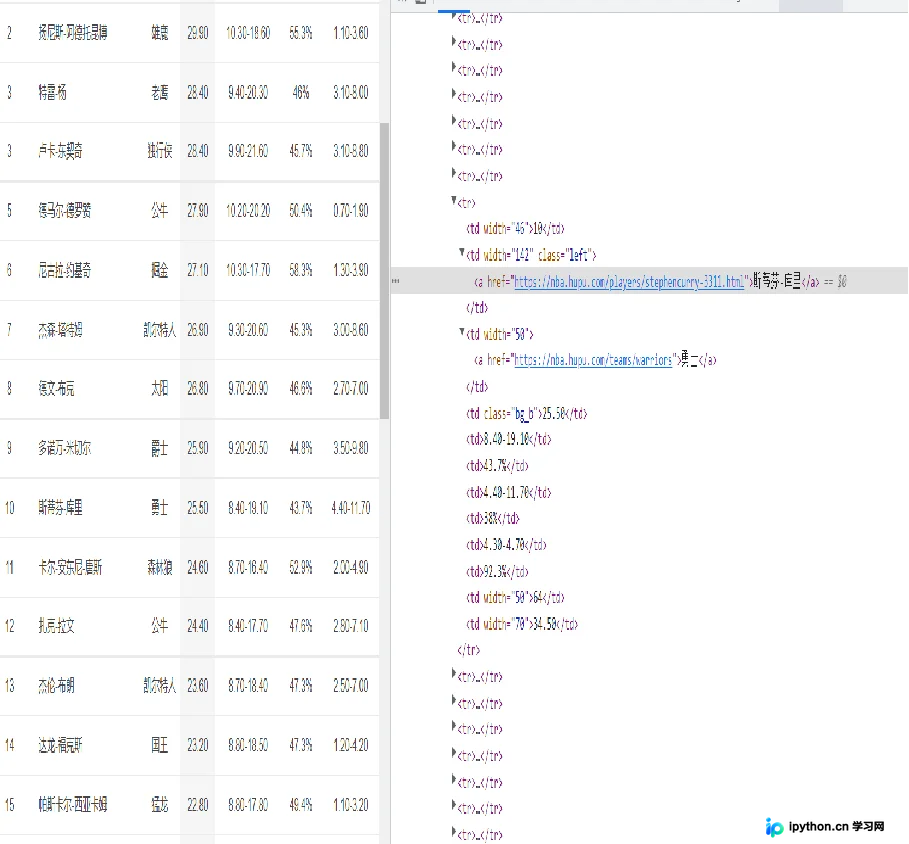
本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
2026-10-12
4

本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
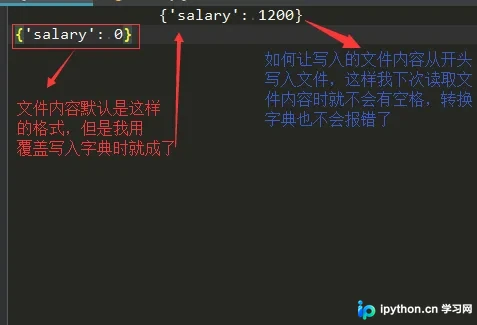
本文介绍在Python中将字典数据写入文件时,因格式问题导致首行出现空格进而引发读取报错的情况。通过示例模拟购物车薪资记录场景,分析使用json模块直接写入字符串产生的空格现象,并提供避免该问题的具体代码实现方案,确保数据读取的准确性。
本文介绍Python中变量从内存到磁盘的序列化(pickling)及反序列化过程。通过对比cPickle与pickle模块的性能差异,演示如何使用dumps、dump、loads和load方法实现对象的持久化存储与读取,并指出pickle仅限Python使用的局限性。
本文深入解析Python标准库pickle模块,介绍其用于对象序列化的核心功能。通过具体代码示例,演示如何将列表等数据结构转换为二进制格式并保存至文件,以及如何从文件中恢复数据。文章同时涵盖pickle.dump、load、dumps及loads函数的用法,并针对Python版本差异带来的安全风险提供必要的操作建议。
本文介绍如何使用Python合并LMDB数据库文件。首先通过pip安装lmdb库,随后提供完整的Python脚本,演示如何打开源数据库、遍历游标并将键值对写入新的目标数据库。代码包含事务提交机制,确保数据持久化,最后验证合并结果。