

使用pandas将numpy数组保存为CSV文件的完整示例
本文介绍了如何使用pandas库将numpy数组高效转换为DataFrame并保存为CSV文件。通过示例代码展示了从迭代处理数据、构建numpy数组到最终调用to_csv方法保存文件的完整流程,适用于需要批量导出结构化数据的Python开发场景。
2026-10-13
6

本文介绍了如何使用pandas库将numpy数组高效转换为DataFrame并保存为CSV文件。通过示例代码展示了从迭代处理数据、构建numpy数组到最终调用to_csv方法保存文件的完整流程,适用于需要批量导出结构化数据的Python开发场景。
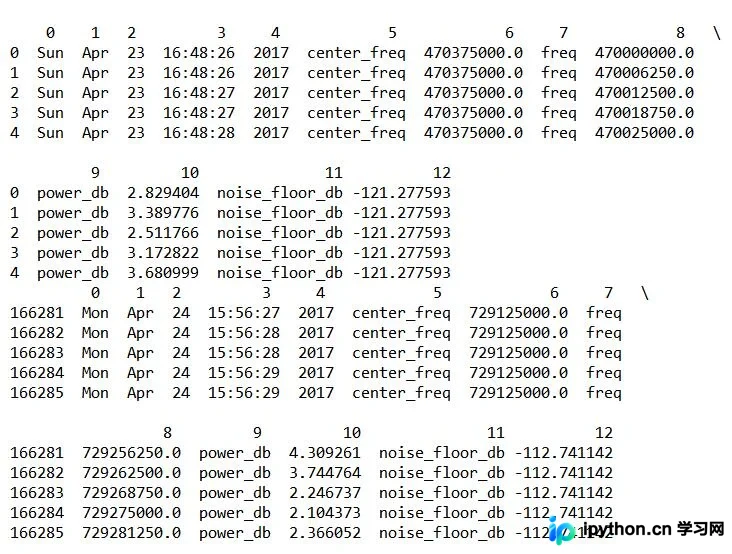
本文介绍如何利用Python的Pandas库高效处理大型CSV文件。通过实例演示从Linux终端数据重定向保存,到使用pandas.read_csv读取、查看前后行数据,以及自定义列索引的全过程。涵盖分隔符设置、header参数及names重命名技巧,帮助开发者快速掌握大数据量下的CSV处理方案。
本文探讨Python2环境下使用csv模块写入数据时产生多余空白行的现象。核心原因在于文件打开模式的选择:二进制模式('wb')与文本模式('w')对换行符的处理机制不同。通过对比两种模式下的代码实现,解析换行符转换差异,帮助开发者避免此类数据格式错误。
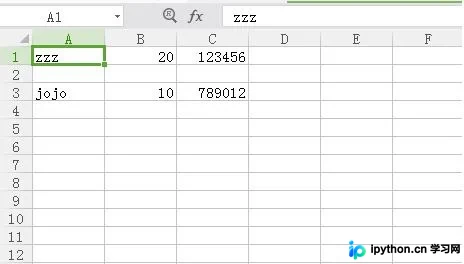
本文介绍如何使用Python将CSV文件中的数据读取并转换为List和Dictionary类型的变量。通过示例代码展示了从文件读取到数据格式化的完整过程,适用于需要将CSV数据用于JSON处理或进一步分析的场景。
本文介绍如何利用pandas库中的usecols参数,在读取CSV文件时仅提取指定的列数据。通过对比全量读取与指定列读取的输出结果,展示了该方法在清理无效列、简化数据展示及提升终端界面清爽度方面的实际应用价值。
本文介绍Python及Pandas在处理文件读写时遇到的编码问题。通过记事本另存为UTF-8,或在Pandas中指定encoding参数(如gb2312),可有效解决Excel打开或写入时的中文乱码现象。
本文介绍如何利用Python pandas库中的read_csv函数及nrows参数,高效读取大型CSV文件的前几行数据。通过具体代码示例,展示如何指定行数限制,避免加载全部数据,从而优化内存使用和处理速度。
在使用Pandas处理CSV文件时,Excel中的空白单元格可能被解析为空字符串而非NaN,导致dropna()或fillna()失效。本文介绍通过正则替换空字符串为NULL,并在read_csv中指定na_values参数将其识别为缺失值,从而正确执行缺失值处理的操作流程。
本文介绍在Python中利用内置csv模块提取CSV文件特定行或列数据的两种实现方式。通过csv.reader按索引获取数据,以及使用csv.DictReader按列名查询字典结构,帮助开发者灵活处理表格数据。
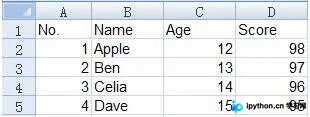
本文介绍Python 3.x读写CSV文件中数字的方法,包括将字符串列表转换为整数、处理换行符、检查并创建目录、指定UTF-8编码写入JSON文件避免乱码,以及使用enumerate和int函数的具体示例与注意事项。
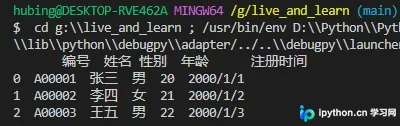
本文介绍如何使用Python的pandas库导入CSV文件。涵盖默认导入、指定分隔符(sep)、限制读取行数(nrows)以及处理编码格式(encoding)等关键参数。同时提供解决中文列标题对齐问题的set_option方法,帮助开发者高效处理不同格式的CSV数据。
本文介绍如何利用Pandas的skiprows和nrows参数高效读取CSV文件中特定范围的行,避免全量加载导致内存溢出。同时提供根据列值筛选并获取对应索引的方法,适用于大规模数据处理场景。