Java 泛型不变性引发的类型转换问题及解决方案

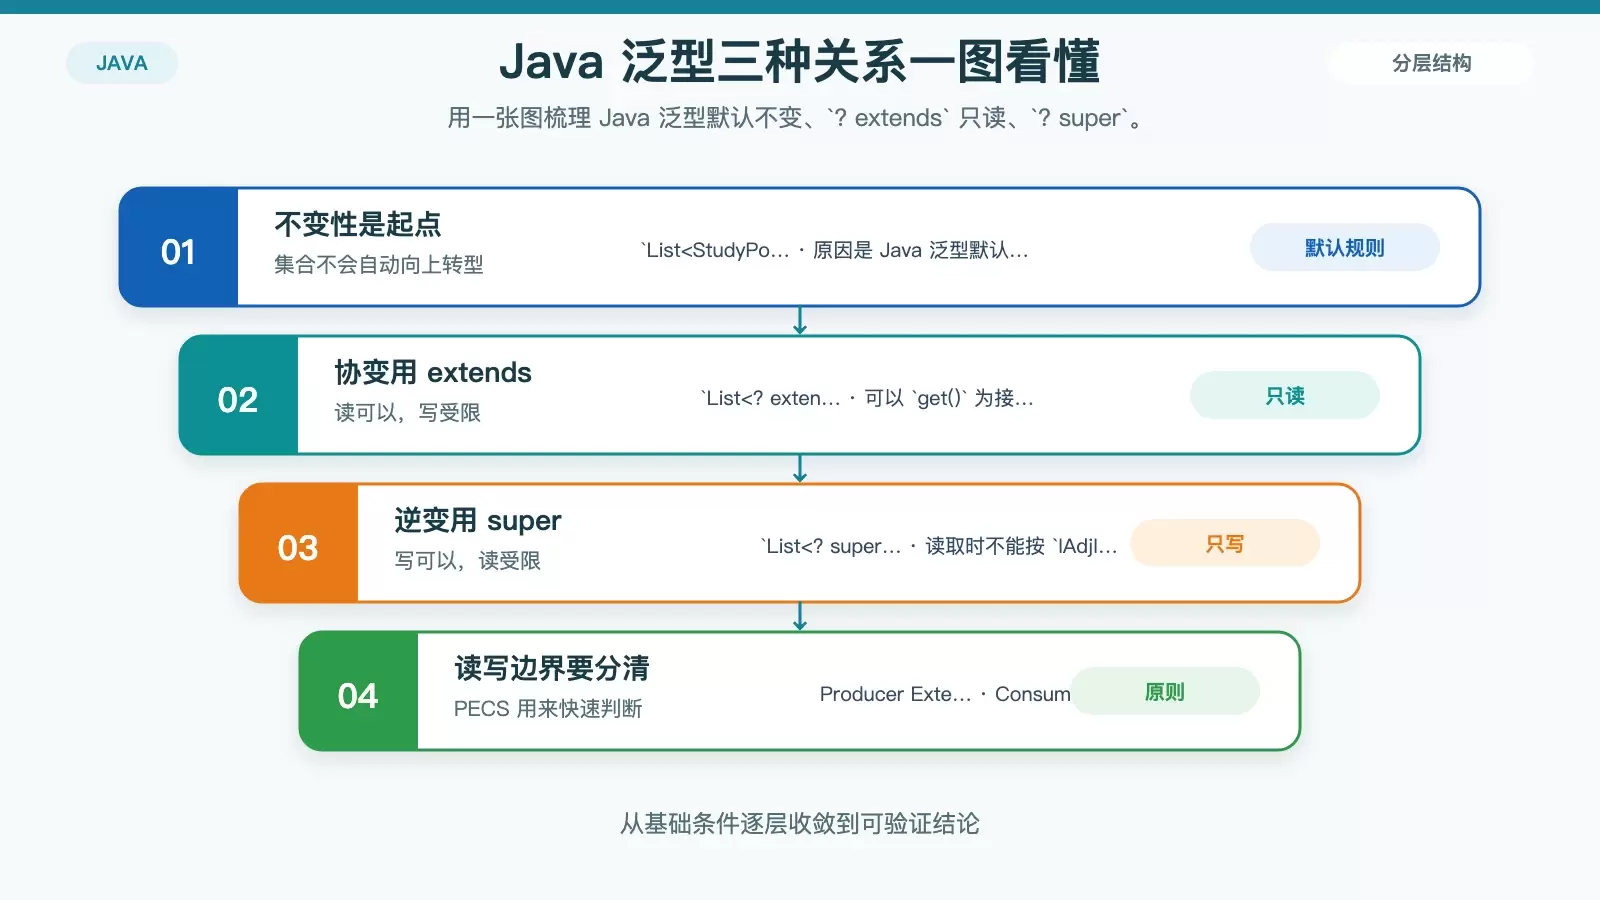
文章围绕 Java 中最常见的一类泛型报错展开:为什么 `StudyPoint implements IAdjIniPoint`,却仍然不能把 `List ` 直接当成 `List ` 使用。文中会拆开不变性、`? extends`、`? super` 与 PECS 的实际含义,并补充和 C# 在协变支持上的关键差异。 在 Java 里,`StudyPoint` 实现了 `IAdjIniPoint`,但 `List ` 依然不能赋给 `List `,根因是泛型默认不变。处理这类问题时,先区分读还是写:只读用 `? extends`,只写用 `? super`,需要真正的接口类型列表就用 `new ArrayList(studyPoints)`,如果还在设。

Java 泛型不变性引发的类型转换问题及解决方案

C#异常概念与try-catch入门:从运行时错误到正确捕获姿势

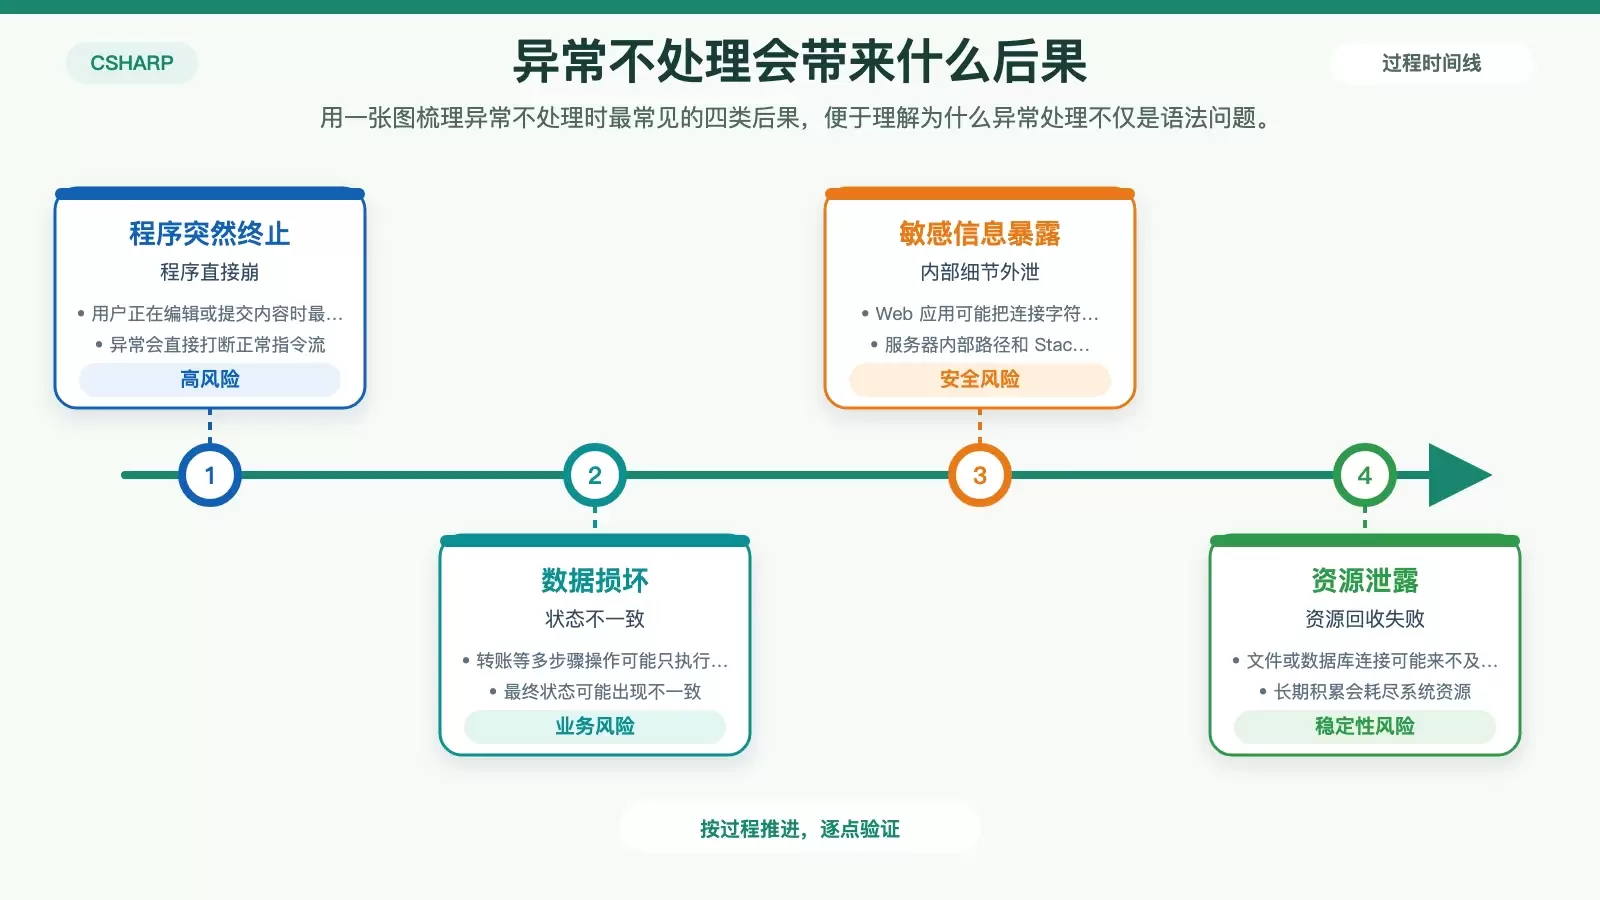
本文围绕 C# 中最常见的异常处理入门场景,梳理异常与语法错误、逻辑错误的区别,说明 `try-catch` 的执行机制、多 `catch` 的匹配顺序,以及为什么空 `catch` 和用异常控制流程都会带来维护风险。读完后,你可以判断什么时候该捕获异常,什么时候应优先使用 `TryParse`。

C#异常概念与try-catch入门:从运行时错误到正确捕获姿势

Word 图表自动化:用 C# 批量生成数据可视化文档

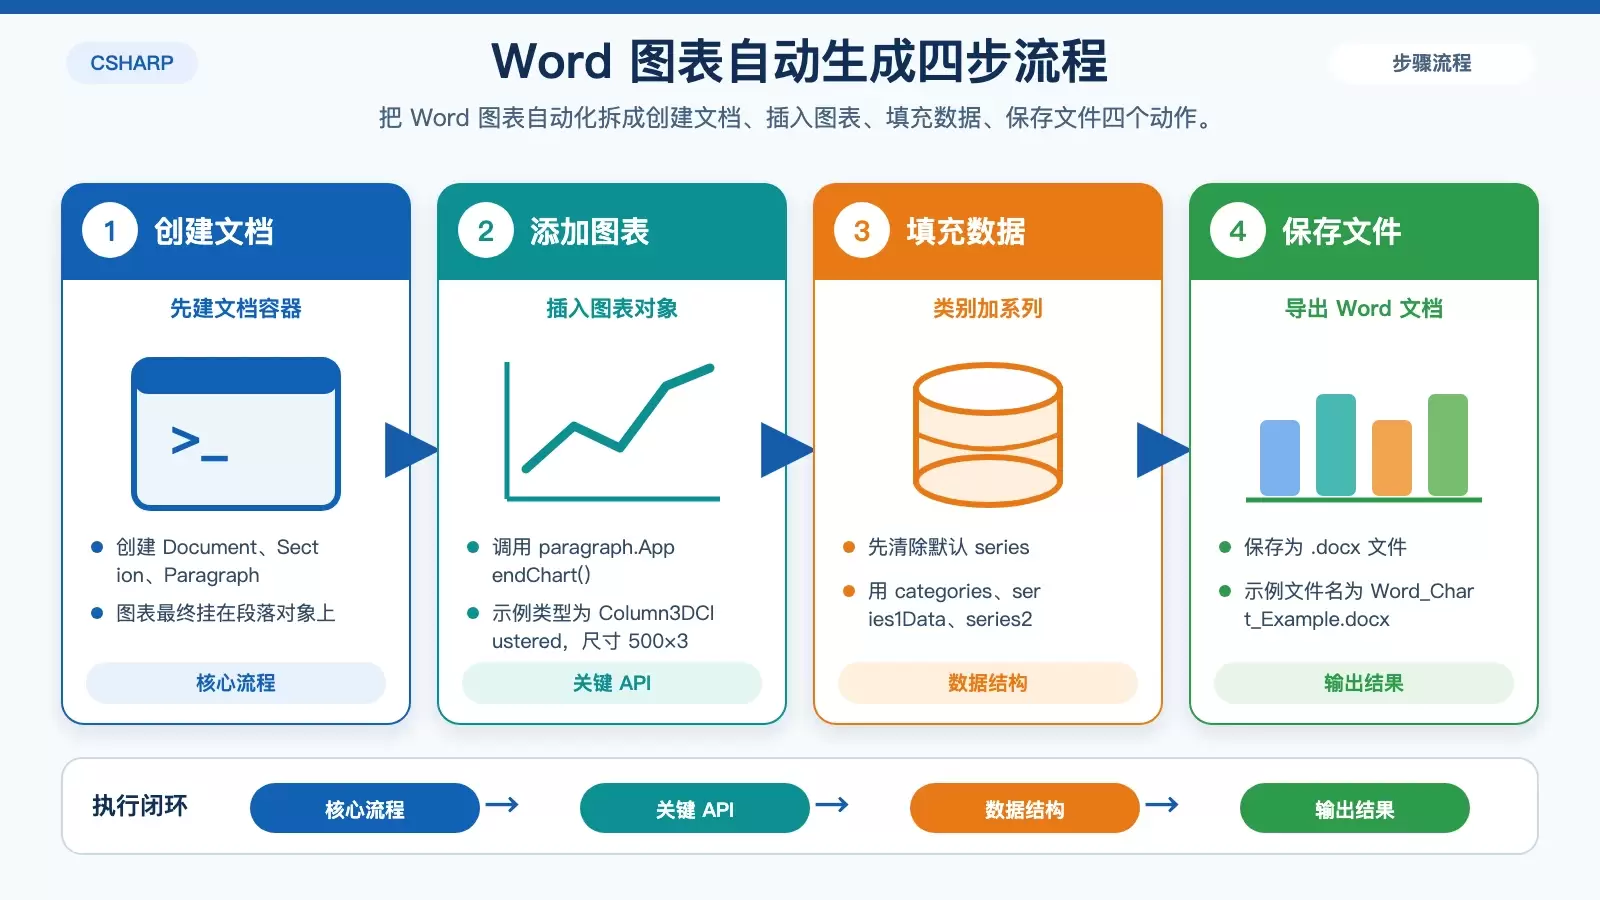
这篇文章梳理了如何用 C# 配合 Spire.Doc for .NET,在不安装 Microsoft Office 的前提下,自动为 Word 文档生成图表。内容覆盖安装、基础建图、样式控制以及动态数据与多图表报告的实现路径,适合作为报告自动化的入门方案。

Word 图表自动化:用 C# 批量生成数据可视化文档

代码的“病历本”:深入解读 C# 常见异常

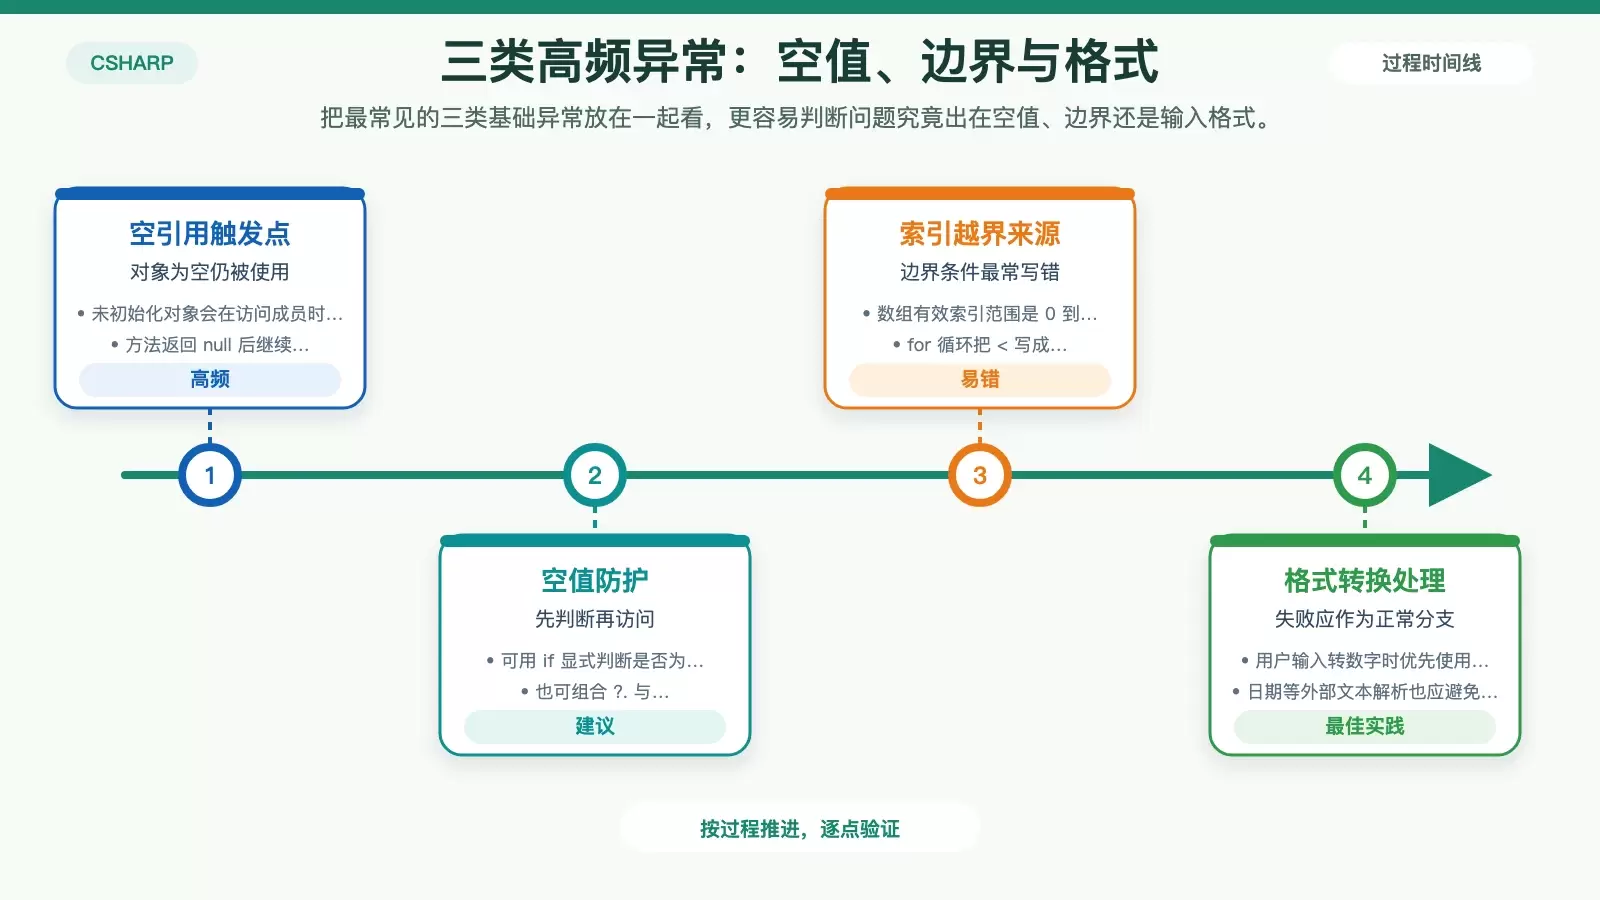
这篇文章按开发中最常见的触发场景,梳理了 C# 里几类高频异常:空引用、索引越界、格式错误、参数错误、类型转换、对象状态错误和 I/O 异常。重点不是背定义,而是判断哪些问题该靠前置校验避免,哪些必须用 `try-catch` 在运行时兜住。

代码的“病历本”:深入解读 C# 常见异常

LINQ 新时代:CountBy、AggregateBy 深度解析(含对比 GroupBy)

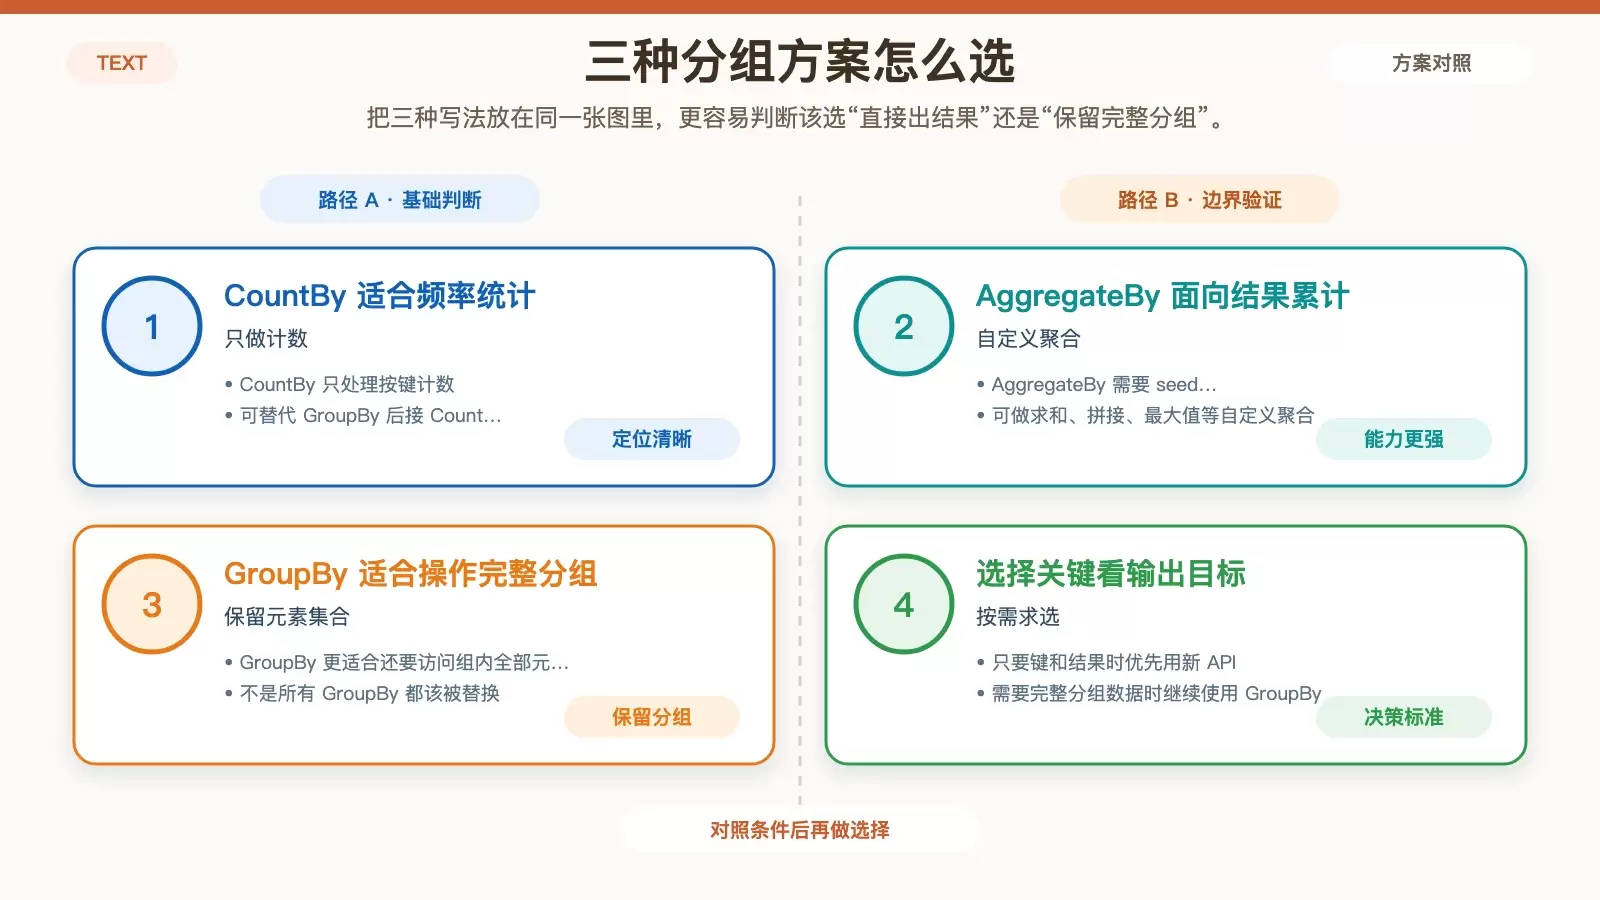
在 .NET 9(C# 13)里,LINQ 新增 `CountBy` 和 `AggregateBy`,把常见的按键计数、分组聚合从 `GroupBy` 链式写法里拆了出来。它们更适合直接产出键值对结果,代码更短,也能减少中间 `IGrouping` 对象带来的开销。 在很多 LINQ 代码里,开发者明明只想拿到“每组几个”或“每组累计多少”,最后还是得先写一段 GroupBy 。 .NET 9(C# 13) 新增的 CountBy 和 AggregateBy ,就是专门为这类结果型统计准备的。

LINQ 新时代:CountBy、AggregateBy 深度解析(含对比 GroupBy)

C# 实现 XML 转 Excel:从解析到生成 XLSX 的完整步骤

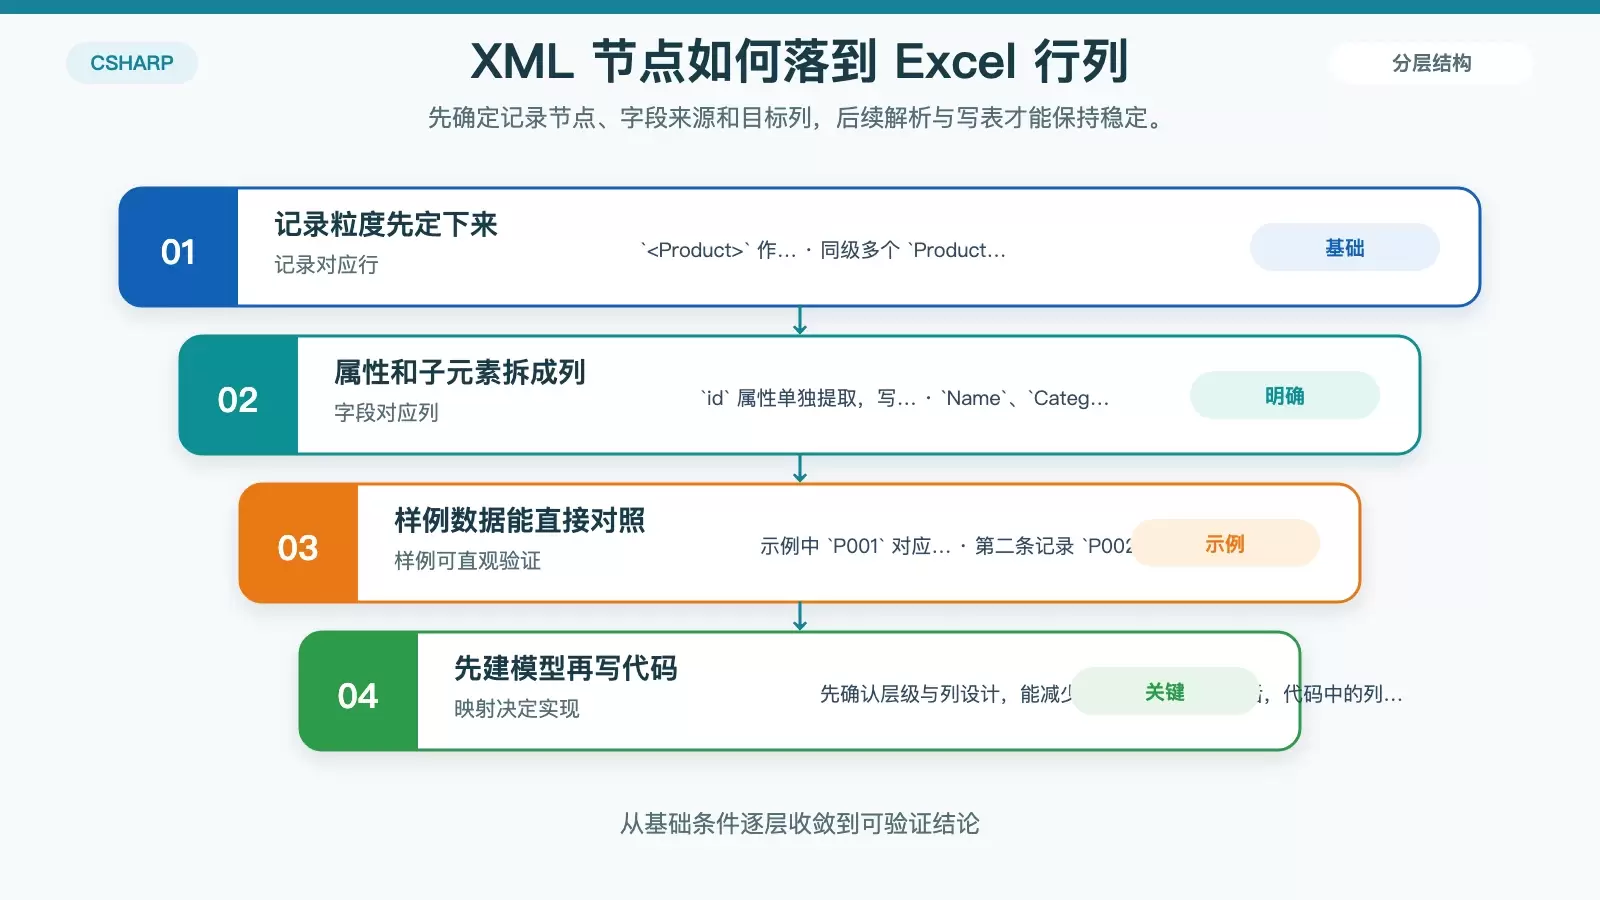
这篇文章用一个产品库存示例,梳理了 C# 将 XML 自动导出为 Excel 的完整做法:先确定 XML 节点与表格列的映射,再用 `XDocument` 解析数据,结合 `Spire.XLS` 写入工作表、处理数值类型并保存为 `.xlsx`。如果你要评估这类方案是否适合现有 .NET 项目,文中也给出了依赖安装、关键 API 和可扩展方向。

C# 实现 XML 转 Excel:从解析到生成 XLSX 的完整步骤

如何在 C# 中创建、读取和更新 Excel 文档

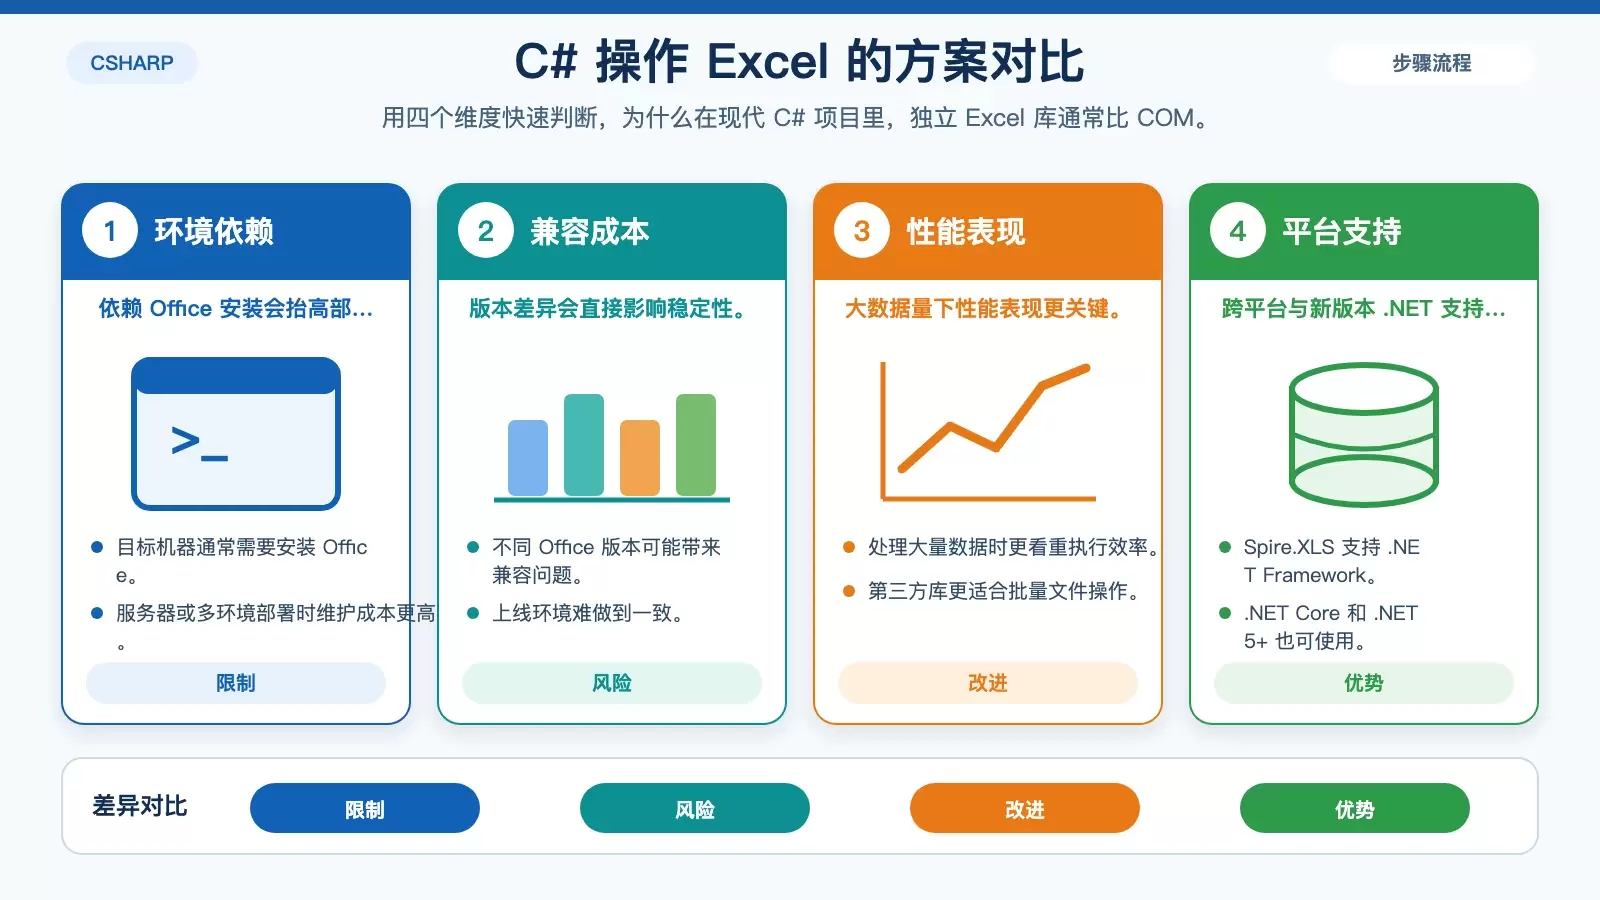
这篇文章围绕 C# 中常见的 Excel 增删改查需求,整理了使用 Spire.XLS for .NET 的实际做法。相比依赖 Office 的 COM Interop,它在部署、性能和跨平台支持上更省事,适合做导入导出、报表生成和批量数据处理。 在 C# 项目里处理 Excel,看似只是文件读写,实际往往牵扯部署环境、性能表现和后续维护成本。

如何在 C# 中创建、读取和更新 Excel 文档

C# Dictionary 入门:用键值对告别低效遍历

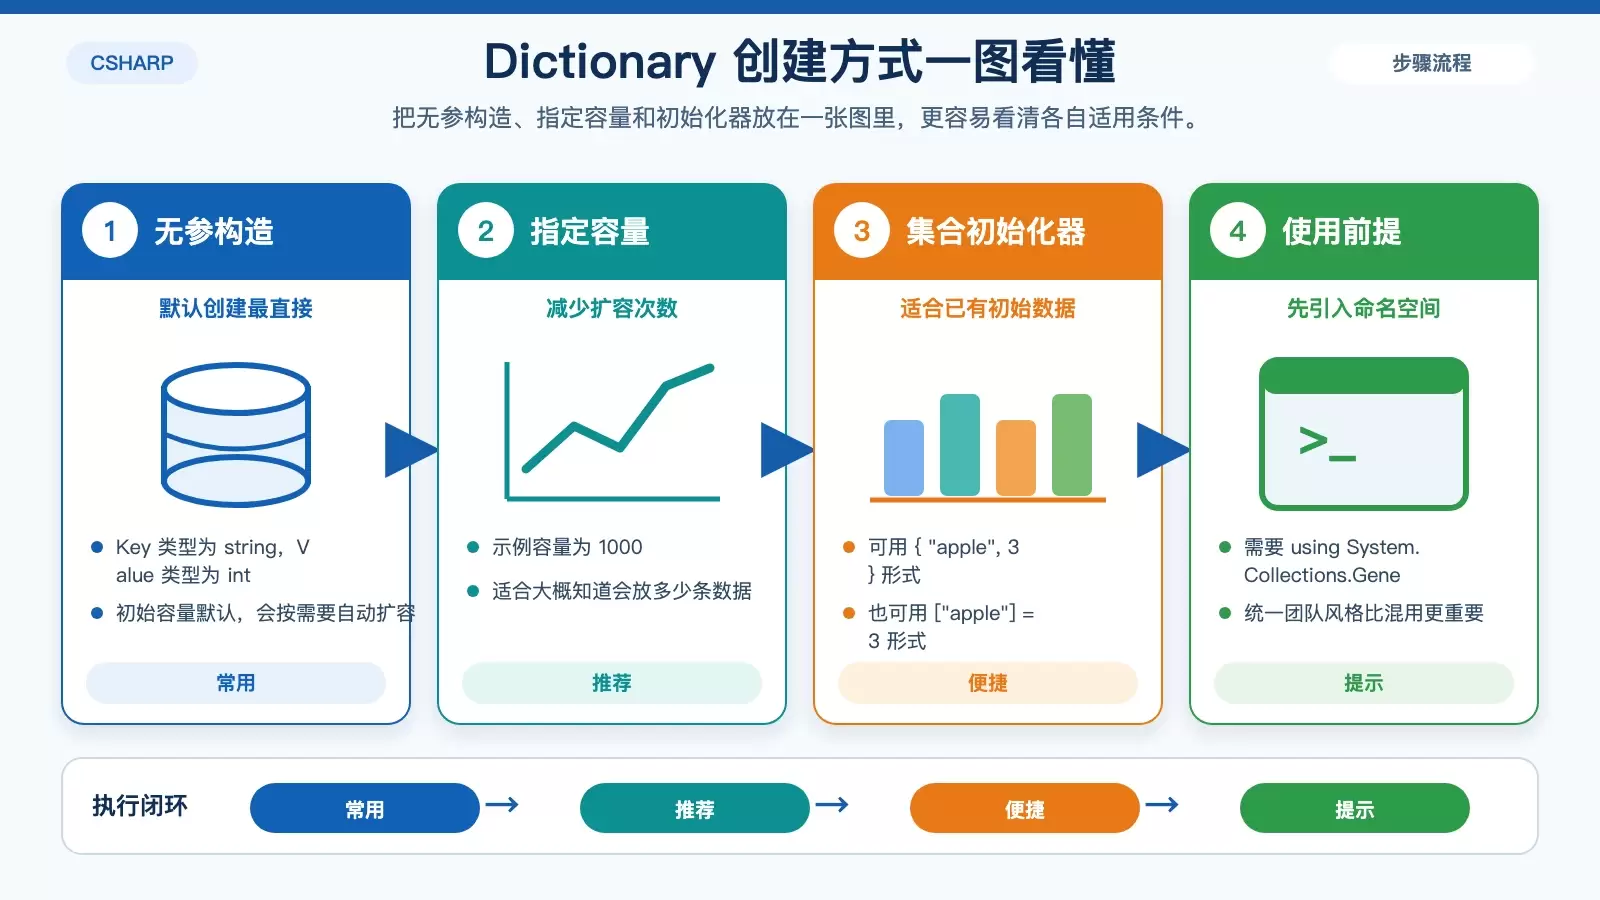
这篇文章用库存示例梳理 C# `Dictionary ` 的核心用法,包括创建、增删改查、遍历方式,以及 `Add`、索引器、`TryGetValue`、`ContainsKey` 等常见方法的适用场景,帮助你判断什么时候该用它替代低效遍历。 C# 初学者很容易把很多“按条件找数据”的逻辑写成循环遍历,但只要数据天然带有唯一标识, Dictionary 往往就是更高效的选择。

C# Dictionary 入门:用键值对告别低效遍历

C# 如何从 URL 下载 Word 文档:用 Spire.Doc 打通下载与处理链路

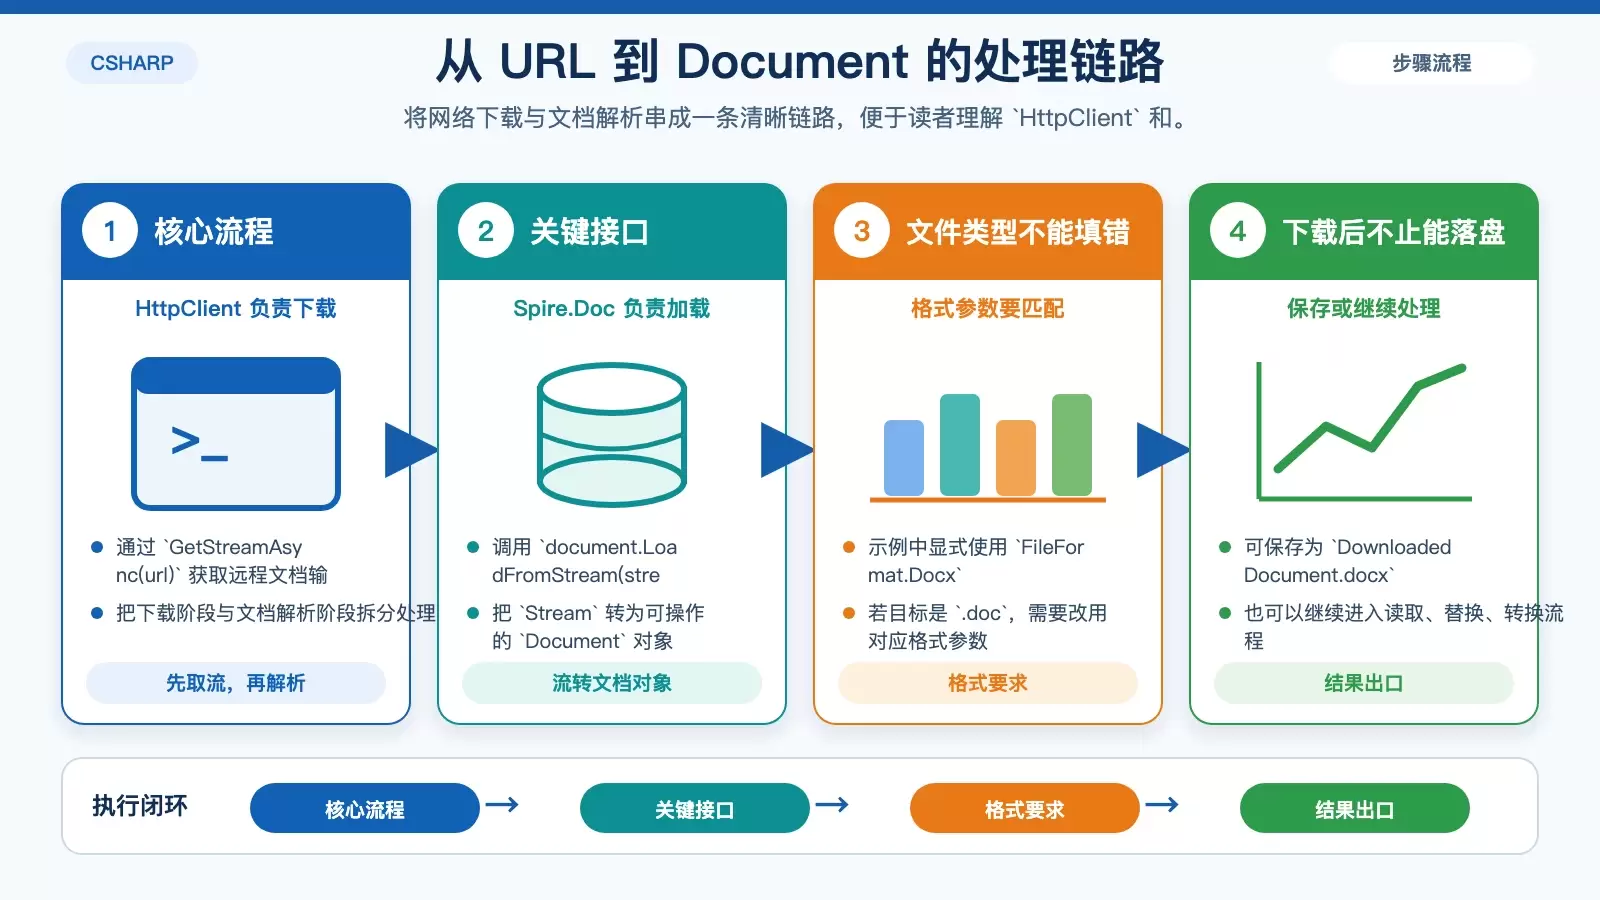
本文梳理了在 C# 中从 URL 下载 Word 文档的常见做法,并说明为什么仅拿到字节流还不够。结合 `HttpClient` 与 `Spire.Doc for .NET` 的流加载能力,可以在不安装 Microsoft Word 的前提下完成下载、解析、保存以及后续编辑与转换。 在很多 .NET 项目里,开发者真正需要的不是“把 Word 文件下到本地”,而是把远程文档接入后续的读取、编辑和转换流程。

C# 如何从 URL 下载 Word 文档:用 Spire.Doc 打通下载与处理链路

C# .NET struct 全解析:什么时候该用值类型?

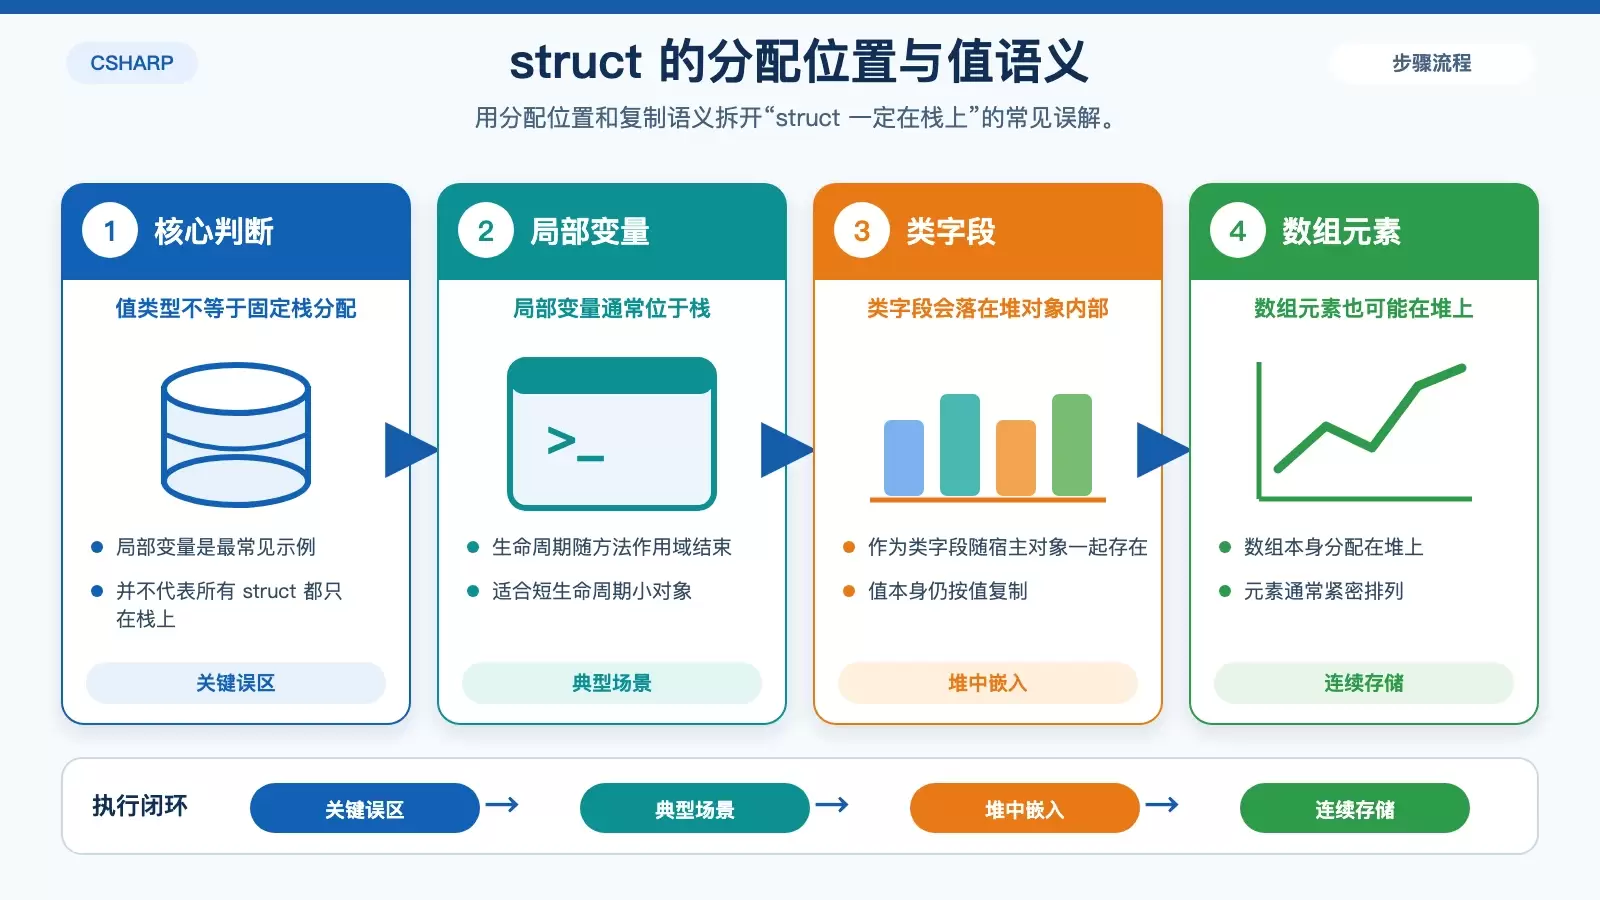
C# 里的 `struct` 常被简单概括为“轻量、快、放栈上”,但真正决定是否该用它的,是值语义、复制成本、装箱行为和类型设计方式。本文结合示例、内存分配场景与新特性,梳理 `struct` 与 `class` 的边界。 很多人把 C# 的 struct 简化理解成“更轻、更快、放在栈上”,但真正影响选型的,其实是值语义、复制成本和装箱行为。

C# .NET struct 全解析:什么时候该用值类型?

使用 C# 设置 Word 段落对齐样式

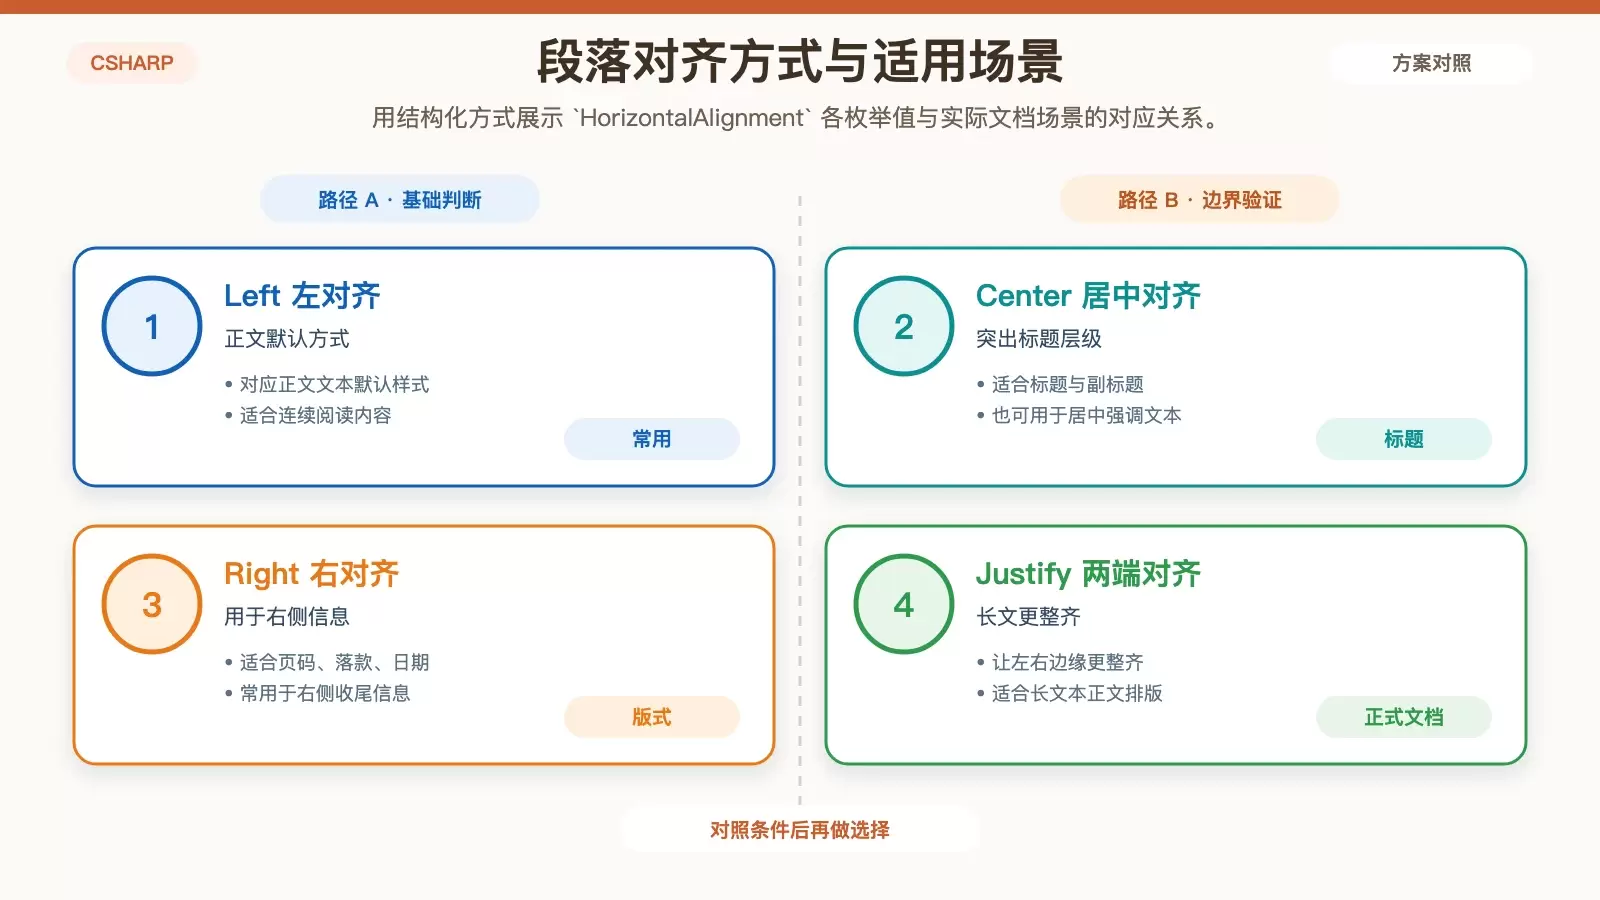
这篇文章介绍如何在 C# 中借助 Free Spire.Doc for .NET 设置 Word 段落对齐方式,涵盖库安装、`HorizontalAlignment` 枚举含义、新建文档示例、批量修改现有文档的方法,以及免费版限制和兼容性注意事项。 在自动生成合同、报告或通知文档时,段落对齐往往决定了最终成品看起来是否规范。本文围绕 Free Spire.Doc for .NET 的 `HorizontalAlignment` 枚举展开,分别说明新建文档和修改现有文档。

使用 C# 设置 Word 段落对齐样式