

10个Python数据处理核心技巧:从入门到精通
本文介绍10个Python中pandas库的高效使用技巧,涵盖数据读取、类型选择、深拷贝、映射转换、apply性能优化、值计数、缺失值处理、ID筛选、分箱及CSV导出等核心场景,帮助开发者提升数据处理效率。
2026-10-13
6

本文介绍10个Python中pandas库的高效使用技巧,涵盖数据读取、类型选择、深拷贝、映射转换、apply性能优化、值计数、缺失值处理、ID筛选、分箱及CSV导出等核心场景,帮助开发者提升数据处理效率。
本文深入解析Python中Lambda匿名函数的定义与特性,重点演示其作为参数传递的应用场景。通过自定义函数调用及列表排序实例,展示如何利用Lambda简化代码逻辑,适用于需要简洁表达式的编程场景。
本文详细介绍PHP中用于暂停脚本执行的sleep()和usleep()函数。sleep()以秒为单位,返回0或false;usleep()以微秒为单位,无返回值。通过对比两者在参数、返回值及错误处理上的差异,帮助开发者根据精度需求选择合适的延迟方案,并补充了针对更高精度时间控制的替代函数。
本文对比C#等语言的传统数组遍历方式,指出Python中直接遍历序列无法获取索引的问题。通过引入range和len的组合方案后,重点讲解内置enumerate函数的使用方法,展示其如何同时返回索引和元素,从而简化代码并提升可读性。

本文介绍Python中通过元组解包实现多变量交换的简洁语法,并结合冒泡排序算法展示其在实际编程中的应用。通过具体代码示例,解析如何利用Python特性简化排序逻辑,帮助开发者提升代码可读性与执行效率。
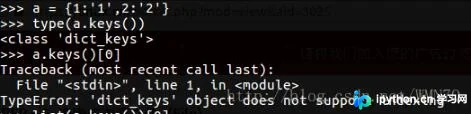
本文详解Python3中dict.keys()返回值由list变为dict_keys对象的现象,指出其不支持索引的问题。通过示例代码展示使用list()函数将其转换为标准列表类型的方法,从而恢复索引功能,帮助开发者解决兼容性与操作便利性问题。
本文介绍在Python的for循环中获取元素索引的常用方法。通过演示enumerate函数的使用,展示如何同时遍历列表中的索引和值,并附带代码示例与输出结果。
本文介绍如何在Python中通过构造列表并使用writelines()方法,实现一次性向文件写入多行内容。该方法能显著提升文件I/O效率,适用于需要批量处理文本数据的场景。
本文详解Python中浮点数精度误差的成因,并重点介绍如何使用decimal模块进行精确的小数运算。通过对比float与Decimal的行为,演示了字符串参数的重要性、localcontext与getcontext的精度控制用法,以及math.fsum处理大数累加误差的技巧,帮助开发者在金融或科学计算中避免精度丢失。
本文详解如何在Python中通过exec函数结合循环动态定义多个变量。利用字符串占位符与exec执行特性,可解决变量名数量不固定的场景。文章提供基础示例及多参数替换方法,帮助开发者掌握这一高级技巧,适用于需要灵活生成变量名的编程需求。
本文介绍在Python中遍历小写英文字母的方法。与C/C++不同,Python不能直接对字符加1,但可通过导入string模块并使用lowercase属性,配合for循环简洁地实现26个字母的遍历输出。
本文介绍了在 Python 中生成小写字母表的三种常用方法。第一种利用列表推导式结合 chr 函数生成字符列表;第二种通过 join 方法将列表拼接为完整字符串;第三种借助 string 模块获取标准字母表,并进一步演示如何将其初始化为值全为 0 的字典。这些技巧涵盖了基础数据处理与标准库应用的常见场景。