

Python中使用haystack实现django全文检索搜索引擎功能
本文介绍如何在Django项目中通过Haystack框架集成Whoosh搜索引擎,实现高效的全文检索功能。内容涵盖环境配置、中文分词器(jieba)的定制与替换、索引文件的创建以及搜索结果的自定义渲染。此外,还讲解了如何重写SearchView以扩展搜索逻辑,并利用高亮标签优化搜索结果展示,帮助开发者快速搭建具备中文支持的专业级搜索服务。
2026-10-13
5

本文介绍如何在Django项目中通过Haystack框架集成Whoosh搜索引擎,实现高效的全文检索功能。内容涵盖环境配置、中文分词器(jieba)的定制与替换、索引文件的创建以及搜索结果的自定义渲染。此外,还讲解了如何重写SearchView以扩展搜索逻辑,并利用高亮标签优化搜索结果展示,帮助开发者快速搭建具备中文支持的专业级搜索服务。
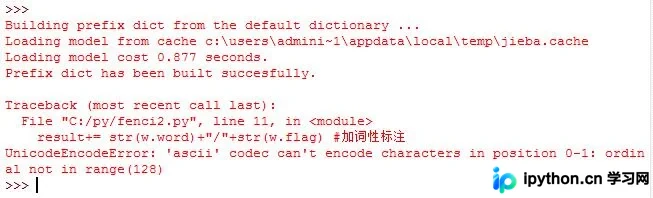
本文详细介绍Python中使用结巴分词库进行中文文本分词及词性标注的完整流程。通过读取文本文件、调用pseg.cut进行分词,并将结果保存至新文件。针对Python 2.7环境下常见的编码报错问题,提供了添加sys.setdefaultencoding("utf-8")的解决方案,附带完整代码示例及运行结果分析,帮助开发者快速掌握该工具的实际应用。
本文详解Python jieba库的安装配置及三种分词模式(精确、全、搜索引擎)的特点。通过荷塘月色案例,展示如何结合中文虚词列表进行词频统计,提供完整代码与运行结果分析,帮助开发者快速掌握中文文本处理技巧。
本文详细解析Python jieba模块的安装配置与核心用法,涵盖精确/全/搜索引擎三种分词模式、自定义词典加载、TF-IDF与TextRank关键词抽取、词性标注及词位置获取等实战操作。提供完整代码示例与性能对比,指导开发者针对NLP场景优化文本处理流程。
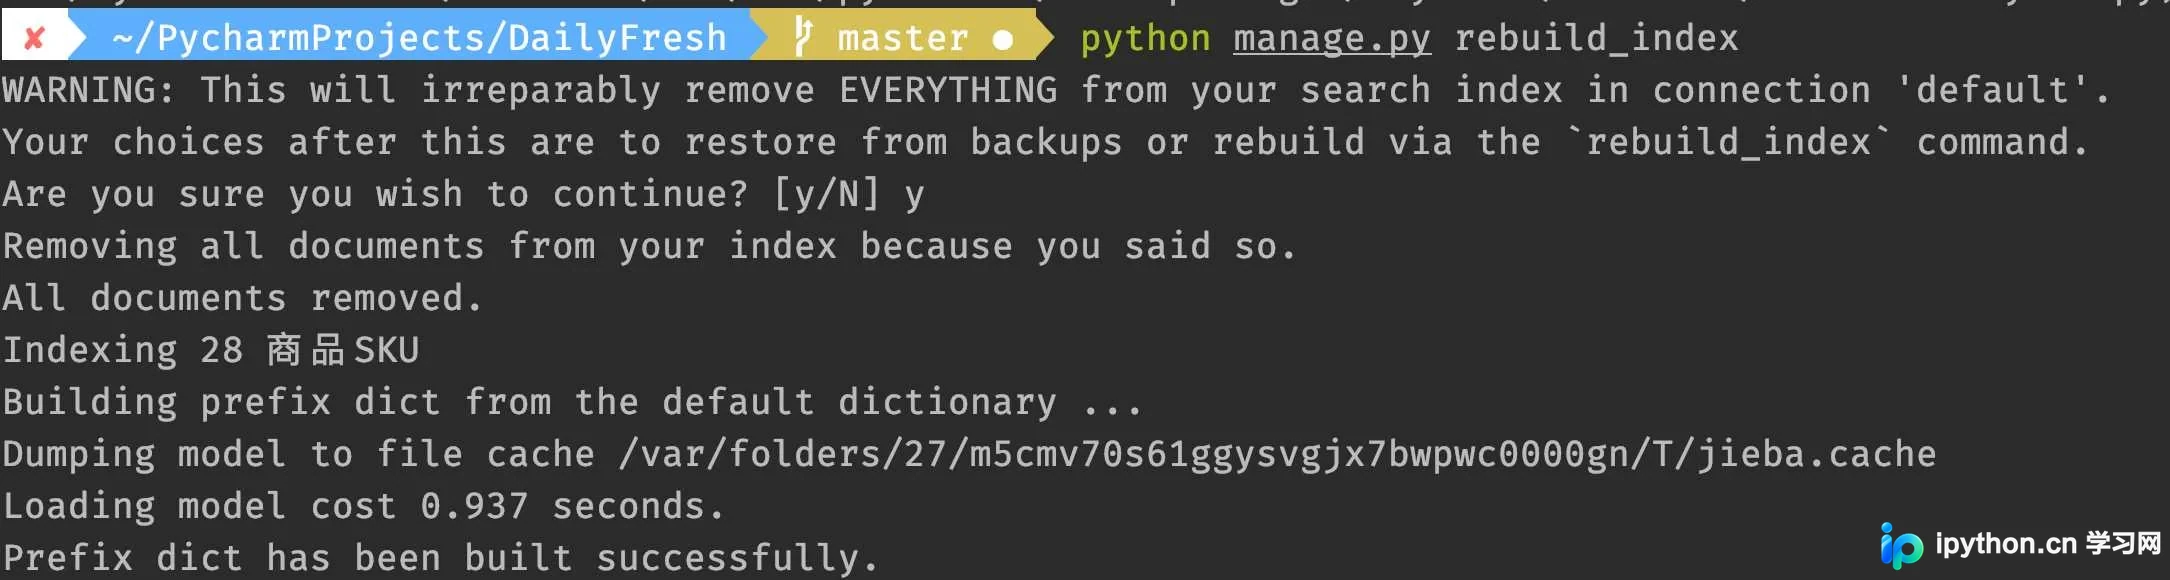
本文介绍如何在Django项目中集成Whoosh搜索引擎,并通过修改haystack源码实现Jieba中文分词。步骤包括安装依赖、创建ChineseAnalyzer、替换后端配置及重建索引,解决Django默认Whoosh不支持中文的问题。
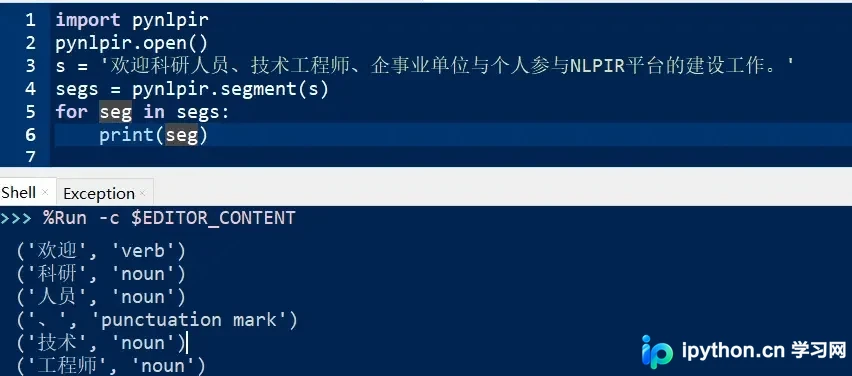
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
SnowNLP 是一款专注于中文文本处理的 Python 第三方库,提供分词、词性标注、情感评分、繁简转换、关键词抽取与自动摘要等功能。本文详解安装流程与核心 API 调用方法,附带完整代码与结果对照,助力快速搭建基础文本分析管线。