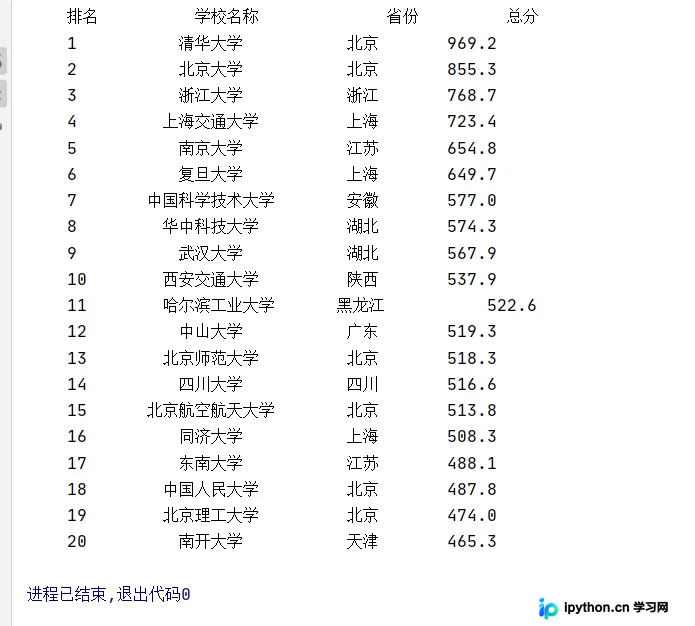
C++实现最大公约数与最小公倍数计算
本文介绍在C++中利用辗转相除法(欧几里得算法)计算两个整数的最大公约数(GCD)的原理,并推导基于 GCD 求解最小公倍数(LCM)的公式。提供完整的 C++ 代码示例,涵盖函数定义、输入输出及运行结果分析。
2026-10-15
9

本文介绍在C++中利用辗转相除法(欧几里得算法)计算两个整数的最大公约数(GCD)的原理,并推导基于 GCD 求解最小公倍数(LCM)的公式。提供完整的 C++ 代码示例,涵盖函数定义、输入输出及运行结果分析。
本文以Go语言ORM库worm为例,详细演示了如何通过链式API高效构造各类数据库查询条件。文章涵盖了基于ID查找、Where基础与模糊查询、条件分支If语句、In/Not In集合查询、嵌套表达式以及分页与排序等核心场景,通过Go代码对照原生SQL的方式,帮助开发者快速掌握worm的常用查询技巧并提升开发效率。
本文系统讲解Python中的流程控制与分支结构,涵盖顺序、分支及循环三大结构。重点解析if单分支、双分支、多分支及巢状分支的语法与运行机制,通过具体代码示例演示条件判断逻辑,帮助开发者掌握Python核心控制流用法。
本文系统梳理Python中的七类核心运算符。涵盖算术、比较、赋值、成员、身份、逻辑及位运算的定义与实例,深入解析取余规则、逻辑短路机制及位运算二进制转换原理。重点阐述运算符优先级顺序,帮助开发者避免常见计算错误,提升代码编写效率与准确性。
本文系统梳理了Python的内置数据类型,涵盖文本、数值、序列、映射、集合、布尔及二进制类型。重点演示如何利用type()函数检测变量类型,并通过str、int、float等转换函数实现数据类型的相互转换,附带完整代码示例,帮助开发者掌握Python数据类型的核心用法。
本文深入解析Golang中reflect包易犯的类型判断缺失、值不可变误修改及无效对象操作等核心问题。结合具体代码示例,提供CanConvert、IsValid、CanSet等安全校验方法,帮助开发者在动态反射场景下精准排查运行时崩溃,确保代码健壮性。
针对 MySQL 在百万至千万级数据量下的分页性能瓶颈,文章通过实验对比了传统 LIMIT 偏移与复合索引结合的优化方案。核心策略是利用覆盖索引仅查询主键 ID,大幅减少回表操作,再结合 IN 子句获取完整记录。该方法可将深分页响应时间从数秒降至毫秒级,适用于无需复杂框架封装的轻量级开发场景。
本文基于MySQL InnoDB存储引擎,介绍如何通过information_schema下的innodb_trx、innodb_lock_waits和innodb_locks三张视图快速定位锁阻塞源。结合具体测试场景,解析各字段含义,通过线程ID关联当前进程,最终利用kill命令或pt-kill工具终止阻塞会话,恢复数据库正常运行。
本文详解Python中处理数据异常值与缺失值的完整流程。首先利用箱型图法(IQR)识别并剔除位移数据中的异常点,随后采用拉格朗日插值法对缺失数据进行填补,并通过最小二乘法进行多项式数据拟合。最后结合Matplotlib可视化展示原始曲线、插值结果及拟合效果,为科学数据处理提供可复用的代码示例。
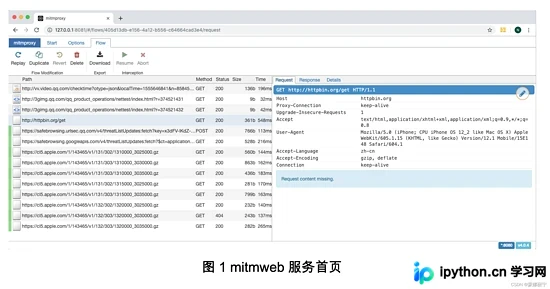
本文介绍如何利用mitmweb这一Web版可视化工具监听移动App的网络请求与响应。通过启动服务并访问默认端口8081,用户可以在浏览器界面中查看URL列表、请求详情及响应数据。文章还演示了如何编辑响应信息、使用Replay功能重发请求以及查看详细信息,并对比了mitmweb与mitmdump结合Python处理的适用场景,为移动App数据抓取提供可视化分析方案。
本文深入解析C/C++中字符数组与字符串指针的区别,阐明字符串以`\0`结尾的本质。通过代码对比char[]初始化规则、char*内存模型,以及指针数组的应用场景,帮助开发者清晰理解底层存储机制。
本文介绍如何使用Python编写网络爬虫,自动获取中国大学排名网站的前20所大学信息。通过requests库请求网页,利用BeautifulSoup解析HTML结构,提取学校名称、省份及总分等关键字段,并将结果格式化输出至控制台及本地文本文件,实现数据的自动化采集与持久化存储。