Java Arrays.sort() 底层实现逻辑解析
本文深入解析 Java Arrays.sort(int[]) 的底层实现机制。该算法采用混合排序策略:当数组长度小于47时优先使用插入排序,介于47至286之间时使用双轴快速排序(DualPivotQuicksort),超过阈值则切换至归并排序。这种多级自适应机制旨在平衡不同数据规模下的性能表现。
2026-10-15
9

本文深入解析 Java Arrays.sort(int[]) 的底层实现机制。该算法采用混合排序策略:当数组长度小于47时优先使用插入排序,介于47至286之间时使用双轴快速排序(DualPivotQuicksort),超过阈值则切换至归并排序。这种多级自适应机制旨在平衡不同数据规模下的性能表现。
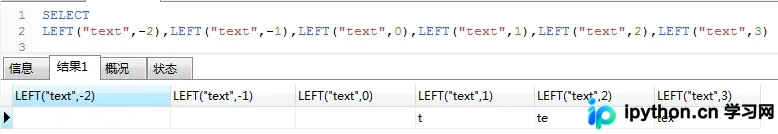
本文系统梳理MySQL中用于字符串截取的核心函数,包括LEFT、RIGHT、SUBSTRING及SUBSTRING_INDEX。详细解释各函数的参数含义、索引从1开始的规则以及正负数对截取方向的影响,并通过具体SQL查询截图展示不同场景下的返回结果,帮助开发者精准处理文本数据。
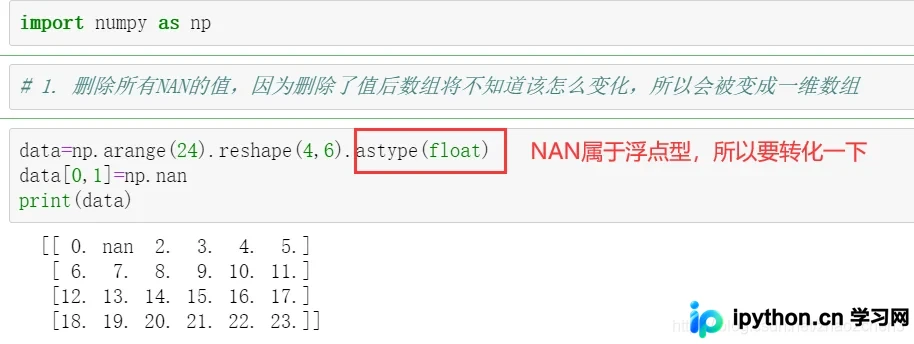
本文详解Python中NAN(非数字)与INF(无穷大)的定义及特性,重点讲解数据分析中缺失值的两种处理策略:直接删除与使用特定值(如0或均值)进行填充,并提供基于NumPy的代码示例与注意事项。
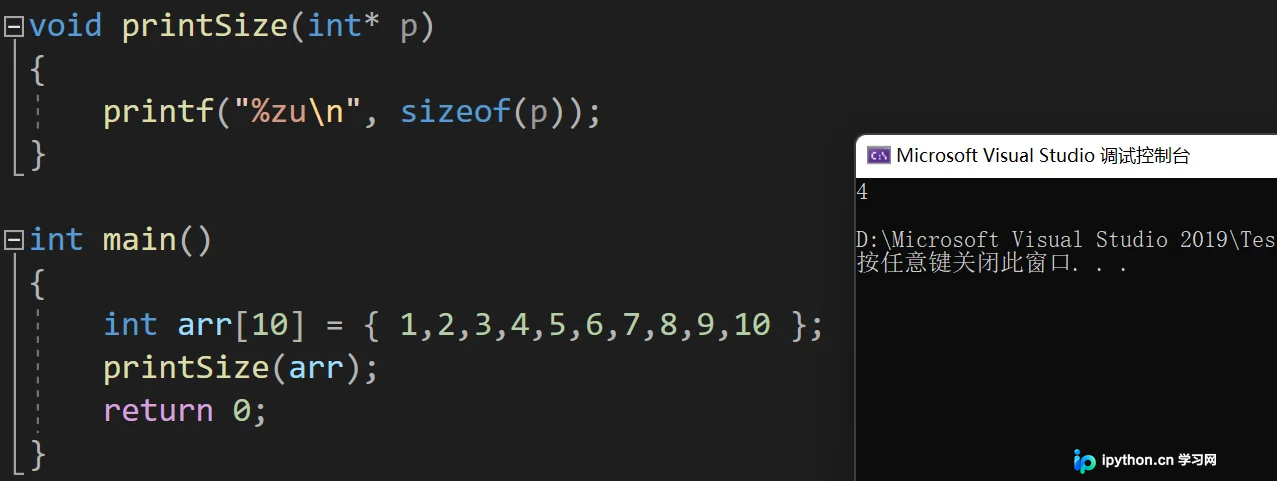
本文深入解析C语言中指针与数组的核心机制。涵盖一维及二维数组传参时的降维规则、一级与二级指针的参数传递原理;详解函数指针的定义、函数指针数组的构建及其在实现加减乘除转移表中的应用;最后通过回调函数原理及复杂指针面试题进行实战演练,帮助开发者彻底理解内存地址操作与函数调用机制。
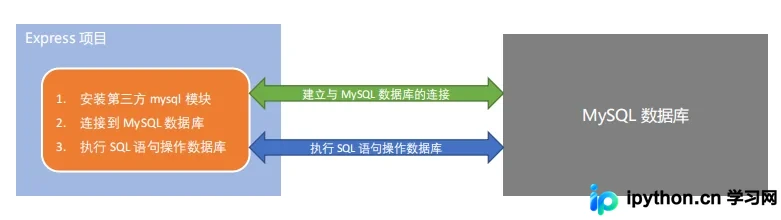
本文介绍如何在 Node.js 项目中通过 mysql 模块连接并操作 MySQL 数据库。涵盖环境安装、连接池配置及完整的 CRUD(增删改查)流程,提供占位符安全更新与便捷对象映射等实用技巧,帮助开发者快速掌握后端数据交互方法。
本文深入解析Java中String.split()方法的机制,重点讲解正则表达式在分隔符中的应用。详细说明需转义的字符(如.*+?^$等)及其正确写法,演示多分隔符组合用法,并指出split默认丢弃尾部空值的特性及通过limit参数-1保留空值的解决方案。
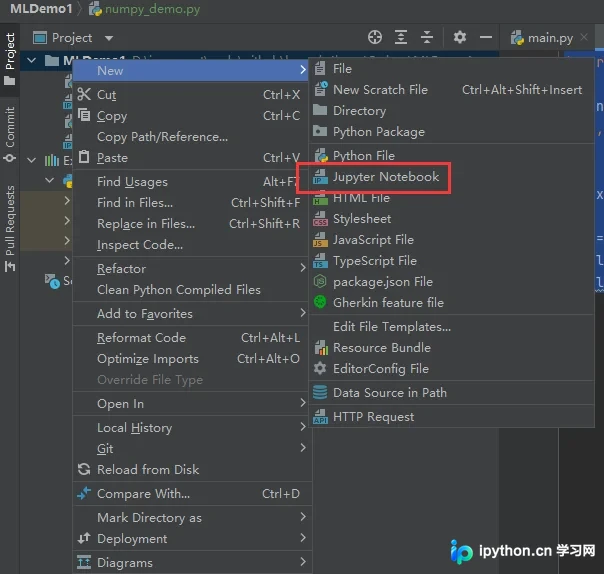
本文详细介绍如何在PyCharm中配置远程Jupyter Notebook环境。通过创建.ipynb文件并配置远程服务器URL与Token,可解决CreateProcess失败等常见报错。文章还分享了密钥拼接注意事项、后台启动命令及无Token模式的备用方案,帮助开发者高效搭建远程Python开发环境。
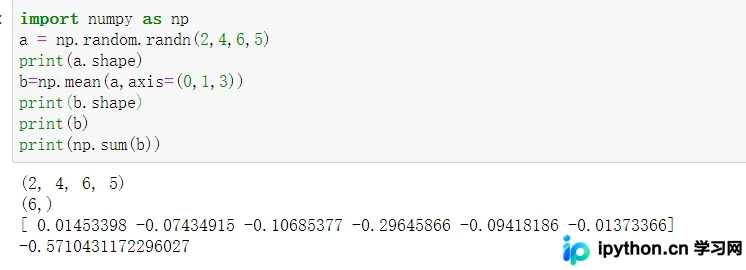
本文介绍如何在Numpy中对3x2x2矩阵进行通道间求均值,得到2x2结果。对比两种方法:直接使用np.mean指定axis参数,以及先reshape再求均值。虽然结果数值不同,但三种均值的总和相同。建议统一使用一种方法,出错时再尝试另一种。
本文详细解析MySQL中Locate函数的用途,包括判断子串存在性及返回首次出现位置。通过具体SQL示例展示其在普通查询和MyBatis中的用法,并对比Instr、Like等实现模糊查询的方法,帮助开发者选择高效的数据检索方案。
本文介绍C#中匿名方法与委托的紧密关系。通过代码示例展示如何将命名方法赋值给委托,以及使用anonymous delegate简化代码结构。同时指出在Stopwatch性能测试中,匿名方法具有较高效率,帮助开发者理解其灵活性与适用场景。
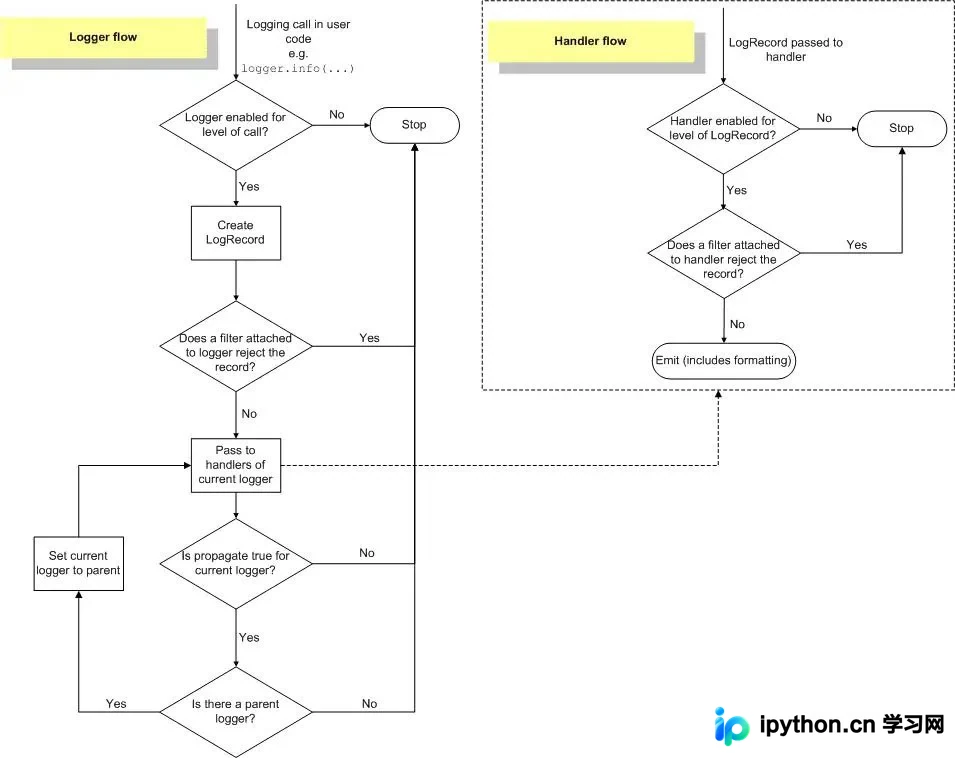
本文深入解析Python标准库logging的工作机制,涵盖六种日志级别、核心组件(Logger、Handler、Formatter等)及执行流程。详细演示如何配置基本日志输出、自定义Logger对象、处理异常信息,以及通过字典或配置文件进行灵活部署。此外,还解决了中文乱码、日志轮转和多进程日志隔离等实战常见问题,帮助开发者构建健壮的日志系统。
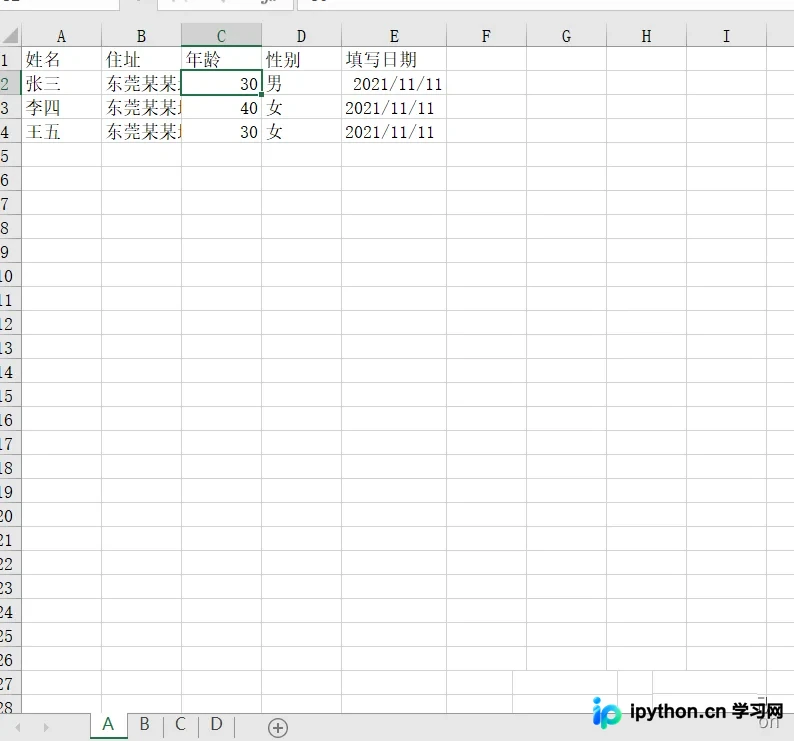
本文详解如何利用Python的Pandas库高效处理包含多个Sheet的Excel文件。通过sheet_name=None参数一次性读取所有工作表,遍历字典对象进行数据清洗(如新增列),并使用ExcelWriter将处理后的多份数据批量写入新Excel文件的对应Sheet中,实现自动化数据处理流程。