

使用Python实现解析HTML的方法总结
本文系统梳理了Python解析HTML的核心方案,横向对比正则表达式、BeautifulSoup与lxml的运行差异与代码实现,提供动态渲染应对、表格转换与编码排错等实战技巧,助力开发者稳定高效地完成网页数据抽取任务。
2026-10-12
24

本文系统梳理了Python解析HTML的核心方案,横向对比正则表达式、BeautifulSoup与lxml的运行差异与代码实现,提供动态渲染应对、表格转换与编码排错等实战技巧,助力开发者稳定高效地完成网页数据抽取任务。
本文介绍在Python中利用datetime和time模块获取当前时间戳及格式化时间的具体方法。通过对比两种模块的使用,展示如何生成年月日、精确到秒的时间字符串,并演示横杠与斜杠等不同分隔符的应用。
本文介绍Python3中math.log10()函数的基本用法。该函数用于计算以10为底的对数,需通过导入math模块调用。参数x必须为正数,函数返回对应的对数值。文章包含代码示例及运行结果分析,帮助开发者快速掌握该函数的应用。
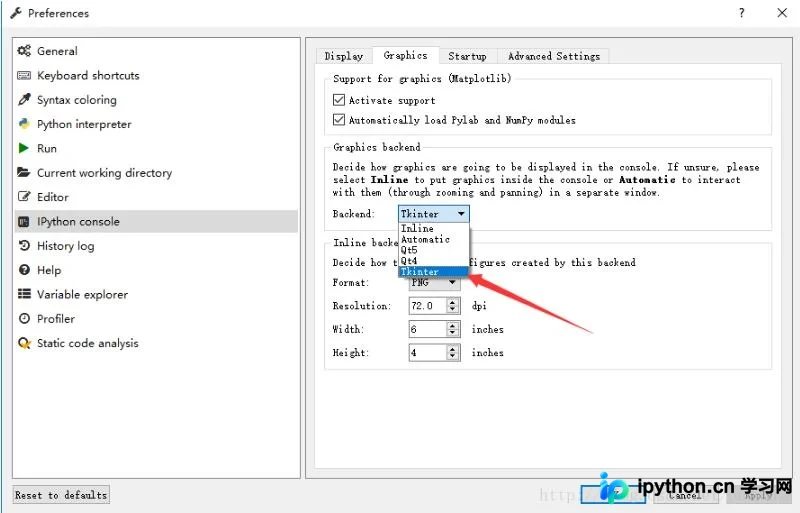
在Python3环境中,使用PyQt5时Mayavi常因Qt API版本不匹配报错。本文详细解析了PyQt5与Mayavi的冲突原因,并提供了在Spyder、IPython QtConsole及IEP等不同开发环境下的具体解决步骤,包括配置PySide、修改后端及设置环境变量。
本文深入解析Python中的桥接模式,通过手机品牌与软件分类的实例,展示如何将抽象部分与实现部分分离。桥接模式允许两者独立变化,有效降低系统耦合度。文章提供完整的Python代码实现,涵盖抽象类定义、具体实现及桥接逻辑,帮助开发者理解并应用该设计模式解决复杂的多维变化问题。
Python通过引用计数与分代算法自动拦截无效内存块。本文拆解底层回收逻辑,演示如何利用生成器惰性计算、显式清理大对象、引入弱引用以及调用性能分析工具进行实操,帮助开发者有效压低运行时内存峰值并杜绝资源泄漏。
本文介绍在 Python 中同时运行多个程序的几种核心方法。通过对比 subprocess 模块、threading 线程库及 multiprocessing 多进程库,详细解析如何控制程序并发执行、等待子进程结束以及处理返回值。重点讲解同步阻塞与异步非阻塞的执行差异,帮助开发者根据实际需求选择最高效的并发方案。
本文介绍在 Python 中获取图片分辨率的两种主流方式:使用 Pillow (PIL) 库和 OpenCV 库。通过具体代码示例,展示如何读取图片文件并提取其宽高尺寸及通道数,帮助开发者快速实现图像尺寸检测功能。
本文介绍如何使用Python正则表达式匹配中括号及其内部的任意字符。通过示例代码展示利用re.search函数配合特定正则模式,实现对包含中括号内容的精准提取与匹配操作。
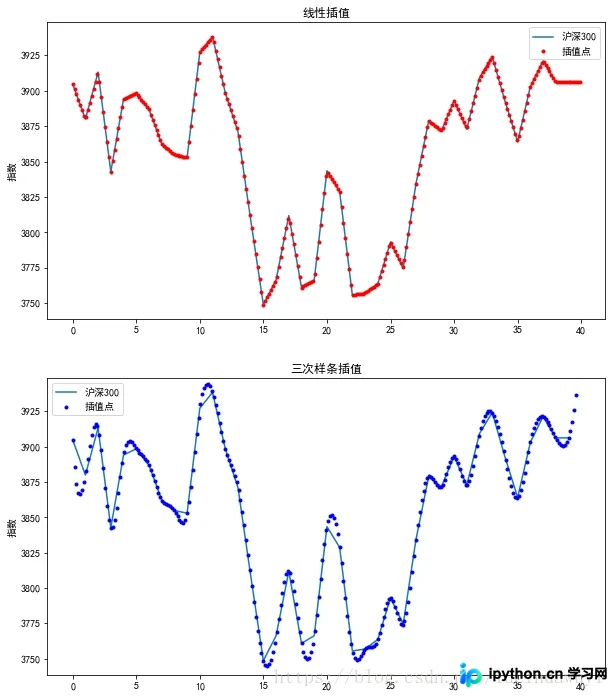
本文介绍如何使用Python的scipy库进行样条插值。通过读取CSV数据,利用splrep生成参数,并使用splev计算插值结果。代码演示了线性(k=1)与三次(k=3)样条的实现,并包含使用matplotlib进行可视化对比的完整步骤。
本文详细解析 Python 中 __new__ 与 __init__ 的核心差异与协同工作流程。通过明确两者在内存分配与属性初始化中的分工,对比函数签名、调用时机与返回值特征,并结合标准类定义示例,阐明如何正确重写这两个特殊方法以实现自定义对象构造及进阶控制。
本文介绍如何利用Python脚本自动抓取MeterSphere平台的场景执行报告数据。通过遍历场景ID调用API接口,结合正则表达式过滤特殊字符与提取关键字段(如投保单号、报价单号、断言结果),最终将解析出的成功状态与详细报文按规则写入Excel报表,实现测试报告的自动化汇总与归档。