

Python3读写文件时newline参数的换行符处理详解
本文详解Python3中open函数的newline参数在读写文件时的行为差异。读取时,None将统一转为\n,空字符串保留原样;写入时,None自动转换为系统默认换行符,其他值控制具体转换逻辑。结合GBK与UTF-8编码异常处理及Makefile修改案例,提供实用的文件操作方案。
2026-10-13
21

本文详解Python3中open函数的newline参数在读写文件时的行为差异。读取时,None将统一转为\n,空字符串保留原样;写入时,None自动转换为系统默认换行符,其他值控制具体转换逻辑。结合GBK与UTF-8编码异常处理及Makefile修改案例,提供实用的文件操作方案。
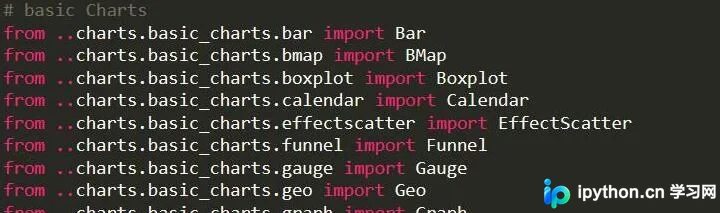
本文针对在Jupyter Notebook中使用pyecharts时遇到的ImportError: cannot import name 'Bar'报错问题进行解析。通过检查源码发现,不同版本的pyecharts对Bar类的导入路径存在差异。文章提供了将导入语句从'from pyecharts.charts import Bar'修改为'from pyecharts.charts.basic_charts.bar import Bar'的具体解决步骤,适用于版本兼容性问题导致的导入失败场景。
本文介绍在pandas中一次性删除DataFrame多个列的方法。通过对比使用index直接删除的错误尝试,引出利用df.drop结合df.columns索引的正确做法,演示如何指定axis=1并应用inplace=True参数,确保输出结果符合预期,帮助开发者避免常见误区。
本文介绍如何使用Pandas对DataFrame进行排序操作。通过示例演示如何对单列(如user_id)进行默认升序排序,以及如何基于多列(如user_id和sku_id)进行复合排序。掌握sort_index方法的使用,提升数据清洗与处理效率。
本文介绍如何使用pandas库中的set_index方法将DataFrame的指定列转换为行索引,支持单列及多列层次化索引。同时讲解reset_index方法,用于将层次化索引级别还原为普通列,并展示索引与列名的变化细节。
本文介绍如何在 Python 的 Pandas 库中调整 DataFrame 的列顺序。通过提取目标列、删除原列并使用 insert 方法插入至指定位置,实现将特定列(如 id)移至最前的操作。该方法简洁有效,适用于需要重新排列数据表结构的场景。
本文介绍Python网络爬虫的三种常见网页抓取方法:正则表达式、Beautiful Soup和Lxml。重点对比了各模块的性能与适用场景,指出Lxml因基于C语言实现而兼具速度与健壮性。文章提供了Lxml及其依赖模块cssselect的详细安装命令,并附带完整的Python代码示例,演示如何利用urllib和lxml下载网页、解析HTML并批量保存图片。
本文详解Pandas中处理重复记录的两种核心方法:duplicated用于标记重复行,drop_duplicates用于直接删除。通过解析subset、keep及inplace等关键参数,结合DataFrame与Series的具体代码示例,帮助开发者高效完成数据去重与清洗工作。
本文介绍如何在Python中利用numpy库的RandomState类生成指定范围和精度的随机数。通过设置种子、定义均匀分布范围及控制输出小数位数,可灵活生成满足特定需求的随机数据,适用于需要固定随机序列或精确控制精度的场景。
本文介绍在Python中修改列表所有元素类型的三种实用方法。通过传统for循环、列表推导式以及map函数,分别演示如何将字符串列表转换为整数列表。每种方法均附带代码示例,帮助开发者根据实际需求选择最合适的实现方式,提升代码可读性与执行效率。
本文探讨Python中字符串转换为整型的常见情况。虽然int()函数能自动处理字符串前后的空格,但若字符串包含小数点,直接转换会引发ValueError。相比之下,转换为float则支持小数格式。本文通过具体代码示例说明这些行为差异,帮助开发者避免类型转换错误。
本文系统介绍Python中Pandas库DataFrame的核心操作方法。涵盖数据查看、属性获取、行列切片、数据替换、条件筛选(含模糊匹配)、数据转换、读取存储、聚合统计及数据集合并等关键功能。通过Excel读取、排序、去重等具体代码实例,帮助开发者快速掌握数据预处理与清洗技巧。