

Python 2.7 中导入自定义类的正确方法
本文介绍在 Python 2.7 环境下,如何在不同文件中导入自定义类。通过定义包含 __init__ 方法的类,并使用 from 语句指定正确的包路径进行导入,实现代码复用。适用于使用 PyCharm 等 IDE 进行开发的场景,帮助开发者解决模块引用问题。
2026-10-13
32

本文介绍在 Python 2.7 环境下,如何在不同文件中导入自定义类。通过定义包含 __init__ 方法的类,并使用 from 语句指定正确的包路径进行导入,实现代码复用。适用于使用 PyCharm 等 IDE 进行开发的场景,帮助开发者解决模块引用问题。
本文介绍在Python中如何实现不同文件内类的方法互相调用。通过将ALL实例作为参数传递给SON类,实现跨文件的方法访问。利用from son import *或import son进行模块导入,结合动态实例化技术,完成类间逻辑交互。
本文介绍如何使用Python的xlwt库将TXT文件中的每行数据逐行写入Excel文件。通过示例代码展示如何创建Workbook、添加Sheet,并处理多段TXT数据的连续写入操作,最终保存为xls格式文件。
本文介绍如何使用Python将Excel表格中的数据导出为TXT文件。通过xlrd库打开工作簿,遍历指定Sheet的行与列,提取单元格内容并编码为UTF-8格式,最终逐行写入目标TXT文件。文中提供了完整的Python代码示例,适用于简单的数据格式转换需求。
本文详细介绍在Windows系统中配置Python环境变量的两种方法,包括直接修改Path变量及通过系统属性设置。同时解析PYTHONPATH、PYTHONSTARTUP等关键环境变量作用,并演示交互式解释器与命令行脚本的三种运行方式及常用参数,帮助用户快速上手Python开发环境搭建。
本文介绍如何使用Python Pandas库读取空格分隔的TXT表格文件。通过设置header、encoding、delim_whitespace和index_col等参数,可正确处理无列名、中文编码及索引列,适用于多种数据格式场景。
本文介绍使用Python脚本将指定文件夹内的多个PDF文件合并为一个完整文件的实现方法。通过遍历目录获取所有PDF路径,利用pyPdf库读取并写入页面,最终生成合并后的PDF文档。文中包含完整代码示例及运行输出结果,适用于批量处理分散的PDF资料场景。
本文介绍了在Windows环境下使用Python打开并读取TXT文件的具体实例。通过演示open函数用于建立文件连接,以及readlines方法用于获取文件内容,帮助开发者快速掌握基础的文件读写操作,适合Python初学者参考。
本文介绍如何使用 Python 的 logbook 库进行标准化的日志管理。通过配置 logbook.more.ColorizedStderrHandler 实现控制台彩色输出,并结合 TimedRotatingFileHandler 实现按日期自动轮转的文件日志记录。示例代码展示了如何封装 get_logger 函数以简化调用,并包含邮件发送逻辑,适用于需要同时监控本地日志和远程告警的应用场景。
本文解析Python多线程编程中Thread.join()与Lock的常见误区。指出在循环中混用start和join会导致并发退化为串行,强调应将start与join分置于两个独立循环。同时通过实验验证单核CPU下非原子操作count=count+1的线程不安全,演示正确加锁方式及全局锁共享的重要性,避免在子类内部创建锁导致并发失效。
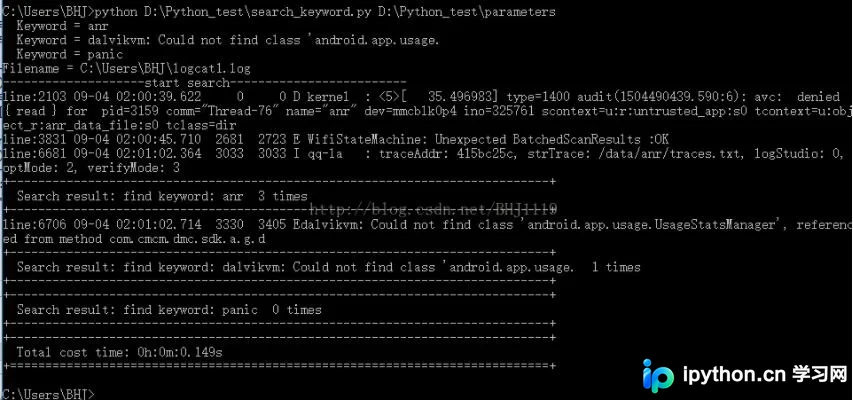
本文介绍如何利用Python脚本在压力测试产生的大量日志中快速定位关键信息。通过读取包含关键字和日志路径的配置文件,程序自动遍历指定文件进行正则匹配,并统计匹配次数与耗时。示例基于Windows 10及Python 2.7.14环境,提供了完整的参数解析、文件检查及时间格式化代码,适用于需要高效日志分析的运维场景。
本文详细介绍在Python中利用jieba库进行关键词提取的三步流程:首先通过jieba.cut进行分词,接着加载停用词表过滤无效词汇,最后调用jieba.analyse.extract_tags结合TF-IDF算法提取高权重关键词。文章提供完整代码示例及运行结果解析,适用于基础文本挖掘场景。