

Hive Transform 快速配置 Python 环境:无需集群预装
本文介绍在 Hive 中使用 Transform 进行数据开发时,如何快速配置独立的 Python 运行环境。通过 virtualenv 创建包含依赖包的虚拟环境,打包后上传至 HDFS,并在 Hive SQL 中引用。该方法解决了集群 Python 版本不一致、部分节点未安装 Python 或依赖包缺失的问题,实现无需集群预装即可快速开发 UDF。
2026-10-13
24

本文介绍在 Hive 中使用 Transform 进行数据开发时,如何快速配置独立的 Python 运行环境。通过 virtualenv 创建包含依赖包的虚拟环境,打包后上传至 HDFS,并在 Hive SQL 中引用。该方法解决了集群 Python 版本不一致、部分节点未安装 Python 或依赖包缺失的问题,实现无需集群预装即可快速开发 UDF。
本文详解Python解决八皇后问题的方法,通过回溯算法在N*N棋盘上放置N个皇后,确保任意两个皇后不同行、同列或同斜线。文章提供基于定义的代码实现,解析冲突检测逻辑,并探讨解的数量与数论的关系,适合Python初学者理解递归与约束满足问题。
本文介绍在Flask开发RESTful后端时解决前端跨域问题的三种方法。包括使用flask-cors库进行独立路由装饰、全局CORS实例化以及通过请求钩子手动添加Response header。文章提供了具体代码示例,帮助开发者根据安全需求选择合适的跨域策略。
本文整理了Python开发中的10个实用技巧与常见错误,涵盖列表推导式、元组解包、字典安全访问、字符串格式化及切片步进等核心概念。通过对比初学者易犯错误与更优雅的Pythonic写法,帮助开发者提升代码简洁性与执行效率,避免浅拷贝陷阱与性能损耗,适用于Python 3环境。
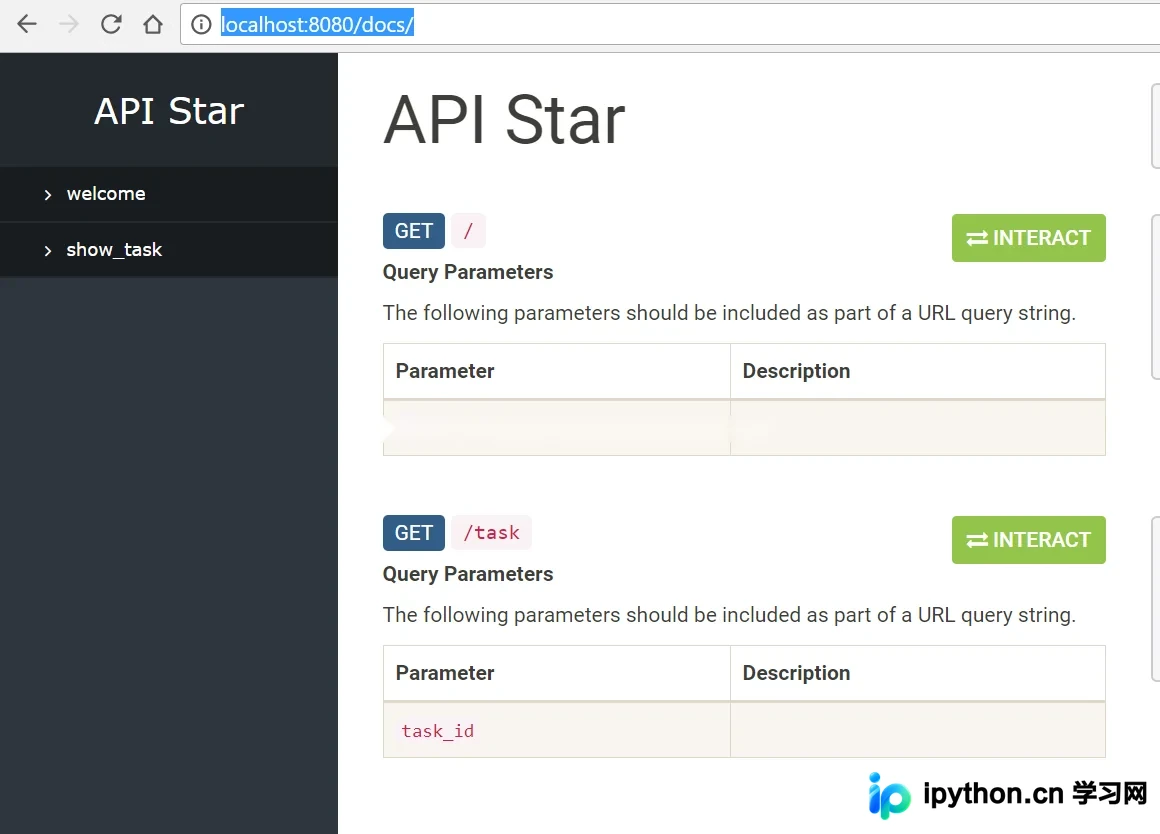
本文介绍基于Python 3的APIStar框架,支持asyncio异步与WSGI同步模式。通过类型提示实现智能路由匹配与数据验证,自动生成API文档。涵盖项目创建、路由配置、路径参数、查询字符串处理及自定义响应对象的使用,帮助开发者高效构建RESTful API。
本文介绍Python中汉诺塔问题的递归解法,并深入探讨进阶场景:给定圆盘位置数组,判断当前状态是否为最优解的第几步。通过分析最大圆盘的移动逻辑,从右向左遍历数组,验证每一步是否符合最少移动原则,若发现多余移动则返回-1,否则计算具体步数。
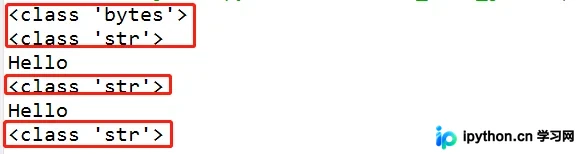
本文详解Python3中bytes类型转换为str类型的两种常用方法。针对URL解析中因类型混用导致的TypeError,分别介绍了利用str()函数和bytes.decode()进行解码的操作步骤。通过完整测试代码展示转换过程,帮助开发者正确处理文本与二进制数据的区分问题。
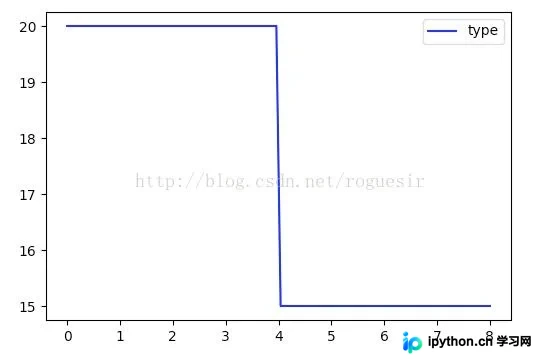
本文介绍了在Python3和Mac OS环境下,利用Matplotlib库绘制分段函数的具体实现方法。通过定义符号函数并结合numpy生成数据,展示了如何绘制分段线性图像,为相关学习提供参考。
本文针对Python初学者梳理了从Python 2到3的关键语法变更,包括print函数、输入方法及比较符号的调整。同时详细解析了列表、元组、集合和字典四种核心数据结构的声明、常用方法及遍历技巧,帮助新手避开常见环境配置与编码陷阱,快速掌握Python编程基础。
本文介绍在Python中求解数组内两个指定字符串最小距离的两种方法。第一种为暴力遍历法,时间复杂度为O(n^2);第二种利用Python内置dict构建哈希表预计算距离,将查询复杂度降至O(1),但空间复杂度升至O(n^2)。文章提供了完整代码示例及适用场景分析,帮助开发者根据查询频率选择最优方案。
本文详细介绍Python中的基本数据类型,包括整型(int)在不同位数机器上的取值范围及Python3中long类型的移除;字符串(str)的单双多引号使用场景与拼接规则,强调类型一致性;以及布尔类型(bool)在逻辑判断中的应用。内容涵盖代码示例与常见错误分析,适合Python初学者快速掌握核心概念。
本文详细解析Python中的四种基础数据类型。首先介绍整数及其十六进制表示,接着探讨浮点数的科学计数法与精度问题,随后讲解字符串的定义与转义字符的使用,最后补充布尔值与空值的概念,帮助开发者掌握Python数据处理的核心基础。