Python中sys.stdout作为默认函数参数的风险与最佳实践
本文探讨在Python函数定义中将sys.stdout设为默认参数的潜在风险。由于默认参数在定义时求值,直接引用sys.stdout可能导致后续重定向失效。文章推荐将默认值设为None并在函数内部动态获取sys.stdout,同时介绍了通过sys.__stdout__恢复原始标准输出的方法,确保程序在日志记录和控制台输出间灵活切换。
2026-10-13
13

本文探讨在Python函数定义中将sys.stdout设为默认参数的潜在风险。由于默认参数在定义时求值,直接引用sys.stdout可能导致后续重定向失效。文章推荐将默认值设为None并在函数内部动态获取sys.stdout,同时介绍了通过sys.__stdout__恢复原始标准输出的方法,确保程序在日志记录和控制台输出间灵活切换。
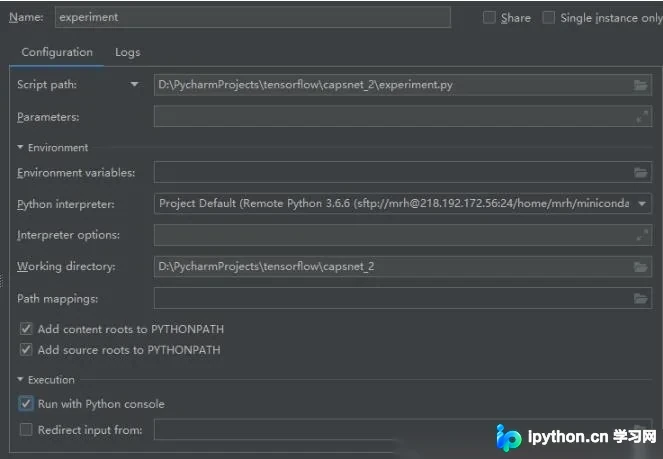
本文介绍PyCharm运行程序时不显示结果的两种常见原因及解决方法。一是误勾选“Run with python console”,需在Edit Configurations中取消;二是函数结果未通过print语句输出,需显式调用print。掌握这两点可快速恢复正常的结果查看。
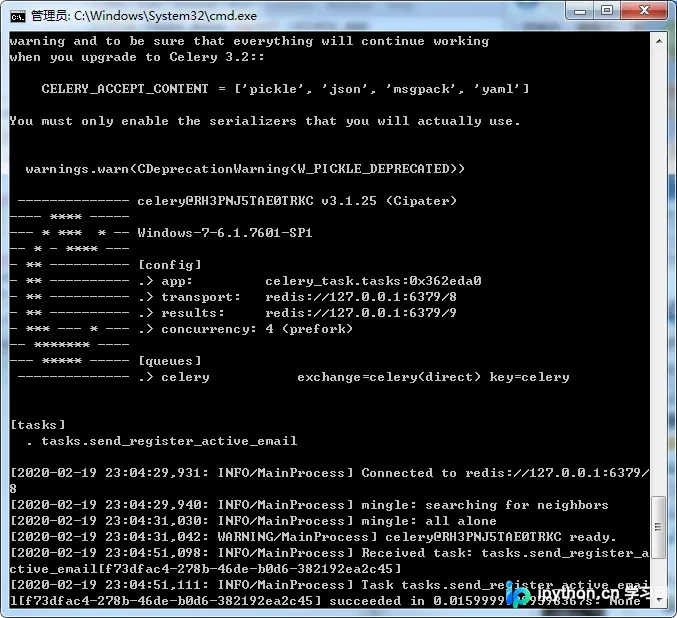
本文详细介绍如何在Django项目中集成Celery和Redis以执行异步任务。内容涵盖环境安装、Celery实例配置、任务函数定义、任务调用触发以及Worker启动步骤,通过具体代码示例演示从定义到执行的全过程,帮助开发者实现后台任务的异步处理。
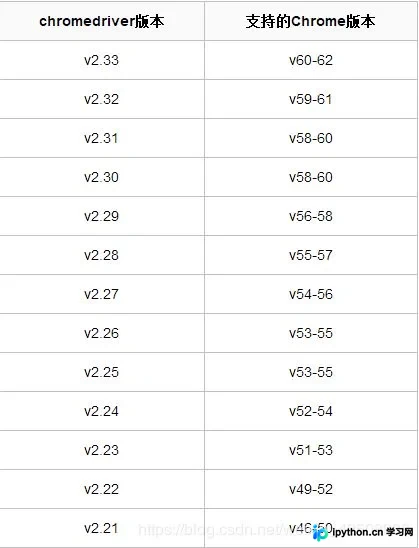
本文详解Selenium自动化测试中ChromeDriver找不到的常见原因及解决方案。重点介绍如何根据浏览器版本下载匹配的驱动,通过配置系统环境变量或直接在代码中指定executable_path路径来解决报错。针对即使配置环境变量仍报“cannot find Chrome binary”的情况,提供了具体的代码级路径指定方法,确保自动化脚本稳定运行。
本文深入解析Python中利用NumPy库进行多项式拟合的核心方法。详细讲解np.polyfit函数的最小二乘法原理及参数设置,以及np.poly1d类在构建多项式、求值、求根和系数提取中的应用。通过正弦函数拟合示例,展示从数据生成、模型拟合到可视化绘图的完整流程,帮助开发者高效实现数据趋势分析与函数逼近。
本文介绍在 TensorFlow 中通过固定随机数种子来确保神经网络训练结果可复现的方法。针对参数初始化和数据读取中的随机操作,使用 tf.set_random_seed 函数设置统一种子,从而在输入数据相同的情况下获得一致的训练输出。
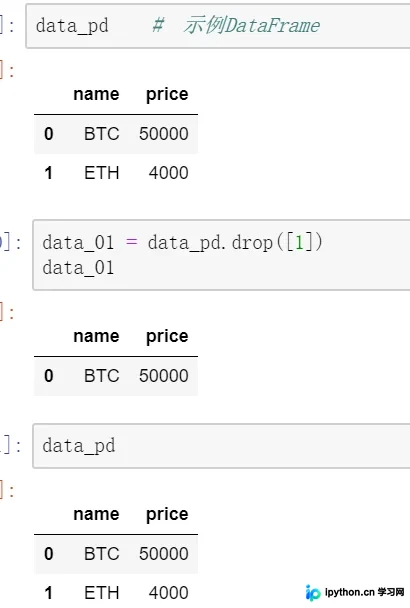
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
本文详解Python中利用time模块进行标准时间与Unix时间戳的相互转换。通过strptime与mktime实现正向转换,利用localtime与strftime完成逆向转换,并附带完整可运行代码示例,帮助开发者快速掌握两种时间格式的处理技巧。
本文分析Python中多个模块共用logging模块时,因调用logging.info()触发root logger的basicConfig()机制,导致日志同时输出到文件和控制台的常见问题。通过解析源码发现root.handlers为空时会自动添加StreamHandler,建议主模块避免直接调用logging基础函数,以精确控制日志流向。
本文详细介绍Python内置uuid模块的用法,涵盖基于MAC地址和时间戳的uuid1、基于随机数的uuid4以及基于命名空间和名称的uuid3/uuid5。通过官方示例代码演示如何生成32位哈希值及标准UUID字符串,帮助开发者在项目中快速实现唯一ID生成。
本文对比Python中print()与pprint()模块的输出差异。pprint(Data pretty printer)专为复杂长数据结构设计,通过分行缩进提升可读性。文章提供代码示例展示两者在列表打印时的不同表现,并介绍pprint模块的pformat、isreadable等扩展方法,帮助开发者优化调试体验。
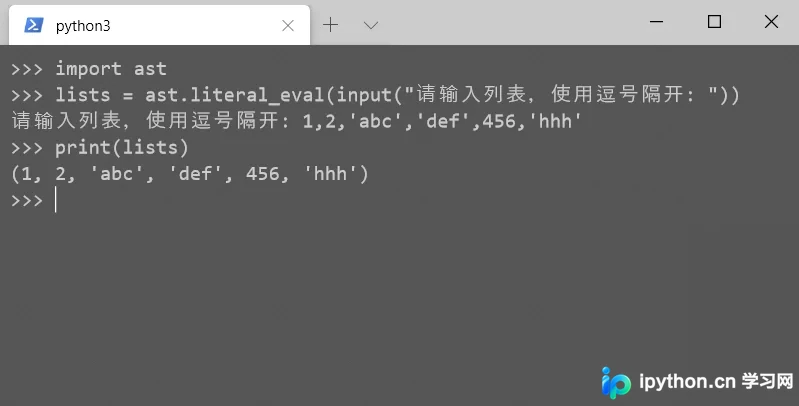
本文介绍在 Python 中如何通过 input 函数接收用户输入的列表数据。重点讲解使用 ast.literal_eval() 将逗号分隔的字符串安全转换为列表的方法,并对比 eval() 函数的潜在风险,强调 ast.literal_eval 在判断数据类型合法性方面的安全性优势,推荐作为标准实践。