Python列表添加元素的四种方法详解
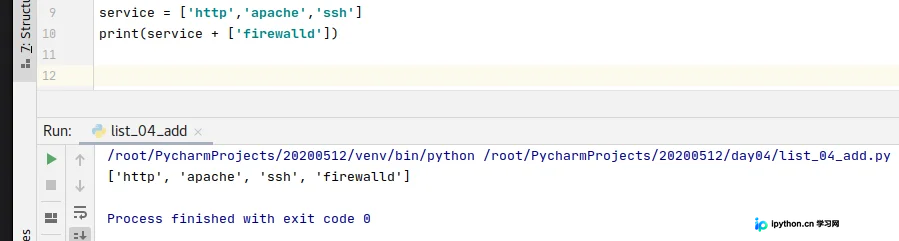
本文总结了Python中向列表添加元素的四种常用方法:使用加号运算符、append()、extend()和insert()。详细解析了各方法的适用场景、语法结构及具体示例,重点对比了append与extend在添加单个或多元素时的区别,以及insert在指定位置插入元素的操作,帮助开发者根据实际需求选择最优方案。
2026-10-15
11

本文总结了Python中向列表添加元素的四种常用方法:使用加号运算符、append()、extend()和insert()。详细解析了各方法的适用场景、语法结构及具体示例,重点对比了append与extend在添加单个或多元素时的区别,以及insert在指定位置插入元素的操作,帮助开发者根据实际需求选择最优方案。
本文详解Python在运维场景下的实用脚本编写,重点讲解subprocess模块调用外部程序、处理超时与返回值,以及shutil模块进行文件命名、删除、拷贝、移动和归档的高级操作。通过具体代码示例,展示如何高效处理进程状态与复杂目录结构。
本文汇总了13个提升Pandas数据分析效率的实用技巧,涵盖计算变量缺失率、获取分组最大值所在行、多列合并、特定字符串行删除、组内排序、类型列选择、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等核心场景,帮助开发者更高效地处理数据。
本文介绍如何利用Python的subprocess模块安全调用外部程序,包括处理返回值、超时机制及捕获输出。同时详解shutil模块在文件复制、移动、目录遍历及归档创建中的高级用法,涵盖符号链接处理、忽略模式及错误处理,为运维自动化提供实用代码示例。
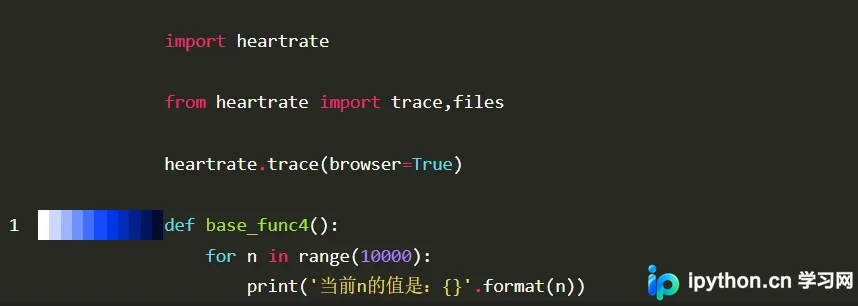
本文汇总了五款实用的Python性能检测工具,涵盖内存占用、运行耗时及代码行级分析。通过memory_profiler、timeit、line_profiler及heartrate等工具,结合具体代码示例,展示如何精准定位程序瓶颈,帮助开发者优化Python应用效率。
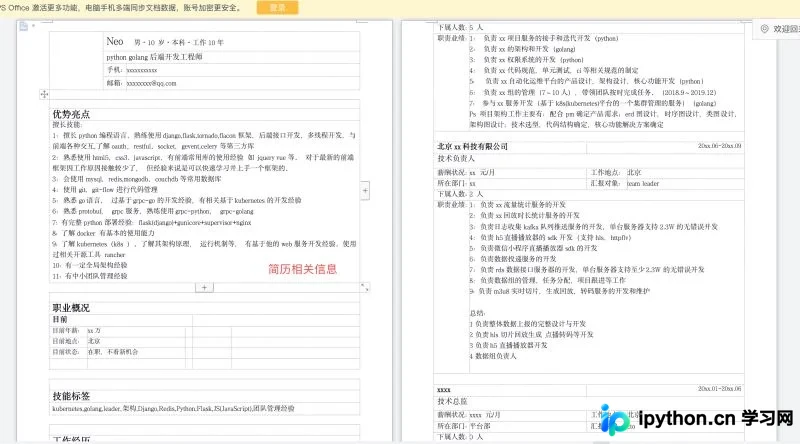
本文介绍利用Python的docx库实现Word文件自动化处理,重点演示如何从不同格式(段落或表格)的简历中读取内容,并通过关键字匹配筛选符合招聘条件的候选人文件。
本文详解如何使用pandas将单行数据按分隔符拆分为多行,涵盖单列与多列拆分场景。同时介绍两种将多行数据合并回单行的方法,包括使用stack/join与explode结合groupby的方式,提供完整代码示例与效果展示。
本文深入解析Python多个内置函数的C语言底层实现。通过分析abs、all、any、dir、id、locals、globals、hash及sum等函数的源码,揭示其内部调用机制,如PyNumber_Absolute、PyObject_Dir及迭代器处理逻辑。重点讲解sum函数中start参数的作用及类型限制,帮助开发者理解Python内置函数的性能优势与使用注意事项。
本文详细介绍如何使用Python的Pandas库对CSV文件进行创建、读取和修改操作。通过具体代码示例,演示如何从Numpy数组生成DataFrame并保存为CSV,以及如何读取CSV文件并转换为数组。此外,还涵盖了列与行的增删改操作及索引重置,帮助开发者高效处理结构化数据。
本文详解Python中利用NumPy创建结构体数组的方法,涵盖通过字典定义字段类型、字节序控制及内存对齐设置。重点解析如何与C语言结构体二进制数据无缝交互,包括读写、字段访问及视图操作,并提供Python类模拟结构体的替代方案,适用于高性能数据处理场景。
本文详细介绍Python字典的常用操作,涵盖初始化、合并、推导式及collections标准库的使用。重点讲解defaultdict和Counter的高级用法,以及字典与JSON、Pandas DataFrame/Series之间的转换方法,帮助开发者高效处理数据结构。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。