

Python 文件操作删除指定行的实现方法
本文介绍在 Python 中如何读取文件内容并删除包含特定字符串的行。通过遍历文件行列表,利用 continue 语句跳过目标行,再将剩余内容写入新文件,从而实现行删除功能。
2026-10-13
10

本文介绍在 Python 中如何读取文件内容并删除包含特定字符串的行。通过遍历文件行列表,利用 continue 语句跳过目标行,再将剩余内容写入新文件,从而实现行删除功能。
本文详解Python中利用pandas进行数据查询的多种方法。涵盖通过head/tail查看前后数据、利用ix索引选取指定行与列,以及结合布尔索引实现多条件组合查询。重点解析多条件查询中括号与逻辑运算符的正确使用,帮助读者掌握高效的数据子集提取技巧。
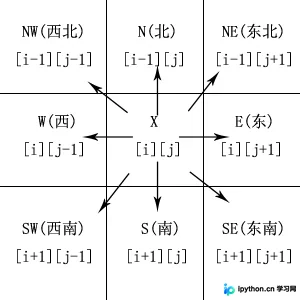
本文详解Python如何利用回溯法与子集树模板解决迷宫寻路问题。通过定义北、东北等八个移动方向,代码遍历所有状态寻找从入口到出口的路径。示例包含完整的迷宫矩阵定义、冲突检测及路径可视化逻辑,适合学习Python算法与数据结构进阶。
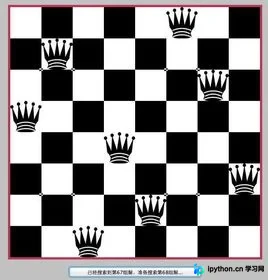
本文介绍利用Python回溯法子集树模板解决8皇后问题的方法。核心思路是将每行皇后的列位置视为8种状态,通过遍历和剪枝避免冲突。文章提供完整代码,包含冲突检测函数与递归求解逻辑,并展示结果输出方式,适合Python算法学习者参考。
本文深入解析Python三大核心数据结构:元组、字典与集合。详细阐述元组的不可变性与内部可变性,字典的无序键值对操作及增删改查方法,以及集合的去重、交集并集等关系运算。通过具体代码示例,帮助开发者掌握各类型的适用场景与高效操作技巧。
本文详解如何使用Python3结合Selenium库解决urllib无法抓取JavaScript动态生成内容的问题。通过实例演示Firefox浏览器自动化操作,包括页面加载、元素查找及模拟按键,帮助开发者高效获取动态网页数据。
本文详解Python中的序列化与反序列化概念,阐述其将对象状态转换为可存储或传输格式的目的。重点介绍使用Pickle和JSON模块进行数据处理的代码示例,涵盖自定义对象持久化、跨环境传递及程序维护性提升等核心应用场景。
本文介绍使用 Python 的 requests 库和 lxml 解析器,通过保持 Session 状态和处理 CSRF Token,实现登录 Bitbucket 并爬取受保护页面内容的完整流程。代码展示了从获取登录页、提取令牌、提交凭证到抓取目标数据的标准操作步骤,适用于需要身份验证的网页数据抓取场景。
本文介绍如何利用Python的numpy库灵活定义神经网络结构。通过设置dtype=object,可动态管理不同层级的节点数、权重及偏置。文中提供了三层及五层网络的定义示例,并展示了基于斯坦福教程的完整实现代码,涵盖初始化、拟合及预测流程,适用于希望深入理解神经网络底层逻辑的开发者。
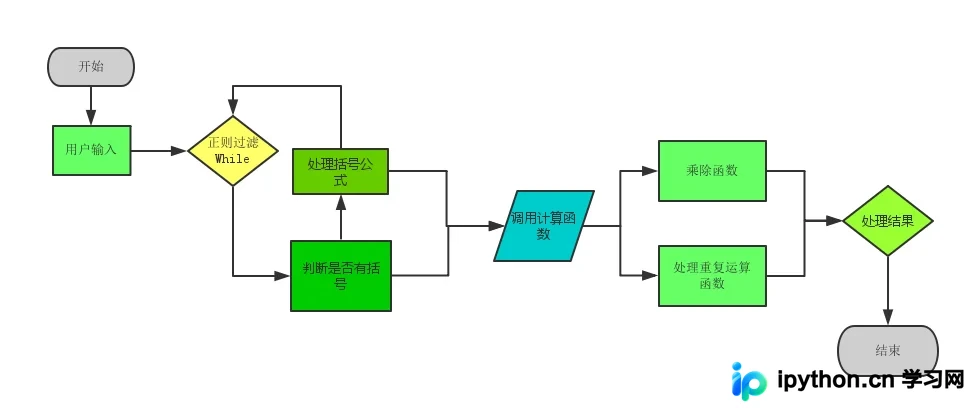
本文介绍使用Python正则表达式实现计算器功能的完整实例。核心逻辑通过正则匹配最内层括号,递归处理直到无括号。重点解决重复运算符合并、负号识别及乘除优先计算问题,最终实现包含复杂嵌套公式的准确计算。
本文深入解析Python multiprocessing模块的核心用法,涵盖进程创建、命名与状态跟踪、守护进程配置及终止机制。重点讲解利用Queue实现进程间数据传递,以及Event同步对象在状态共享中的应用,配合代码实例展示多进程编程的最佳实践。
本文详解 Python 中 Virtualenv 的安装与使用,重点讲解如何通过 --no-site-packages 创建纯净虚拟环境,以及利用 pip freeze 和 install -r 实现依赖的批量导出与一键部署,解决多项目版本冲突问题。