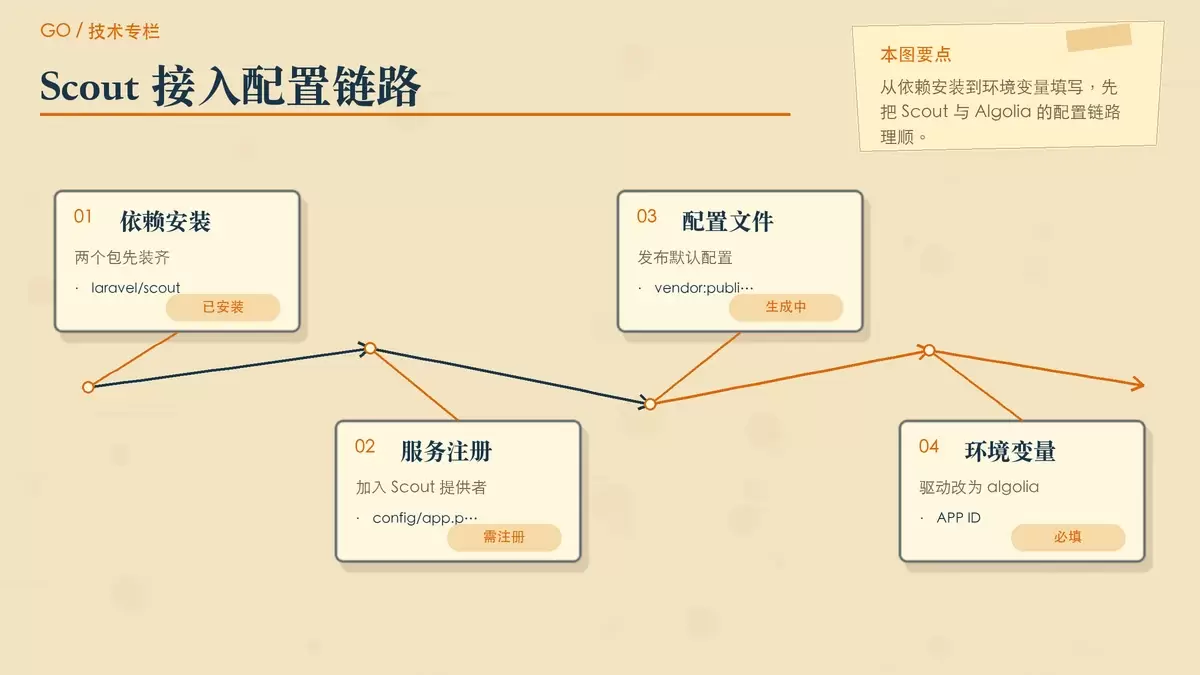
如何使用 SQL SELECT 查询重复数据?
SQL 查重常见分成两类:先找出哪些值重复,再定位到具体重复行。本文按查询目标和数据库版本拆开说明,分别给出 GROUP BY + HAVING、ROW_NUMBER() 以及 MySQL 5.7 自连接方案,并补上删除前最容易忽略的保留策略与复核要点。
2026-08-25
142

SQL 查重常见分成两类:先找出哪些值重复,再定位到具体重复行。本文按查询目标和数据库版本拆开说明,分别给出 GROUP BY + HAVING、ROW_NUMBER() 以及 MySQL 5.7 自连接方案,并补上删除前最容易忽略的保留策略与复核要点。
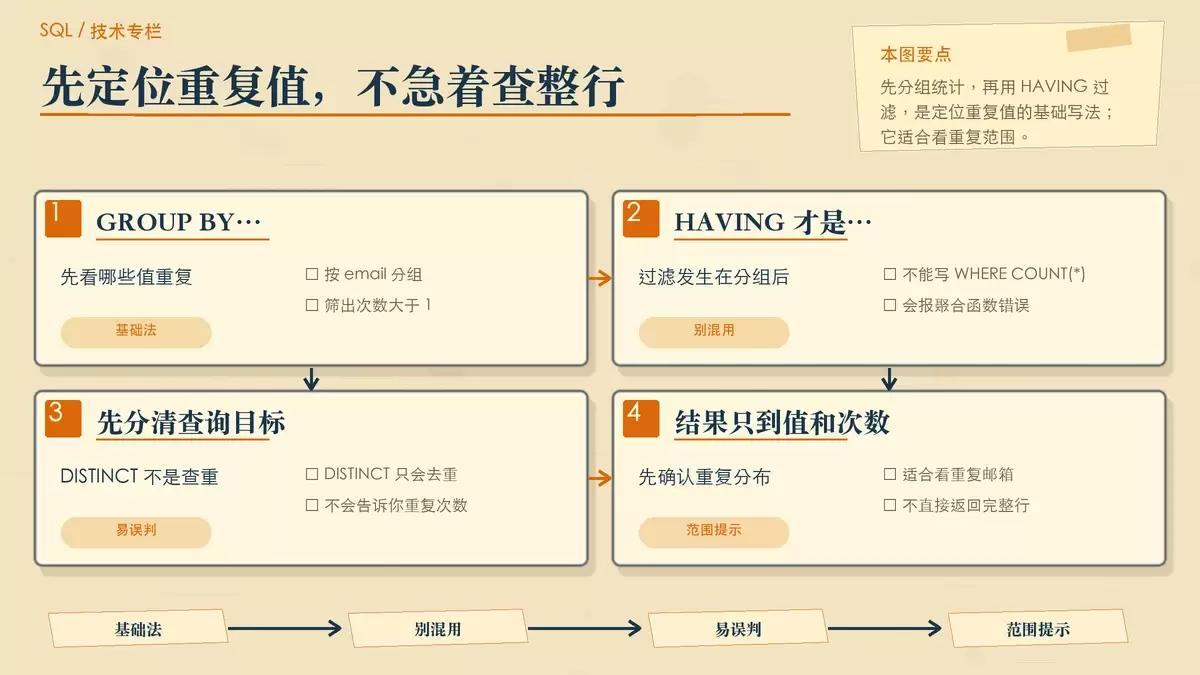
在 Go 的致命错误处理里,`log.Panic` 和 `log.Fatal` 看起来都会打日志并中断程序,但退出路径完全不同。关键区别在于是否触发 `panic()`、是否执行 `defer`、以及调用方还有没有恢复机会。把这几点想清楚,才能在初始化、清理和线上排障时做出稳妥选择。
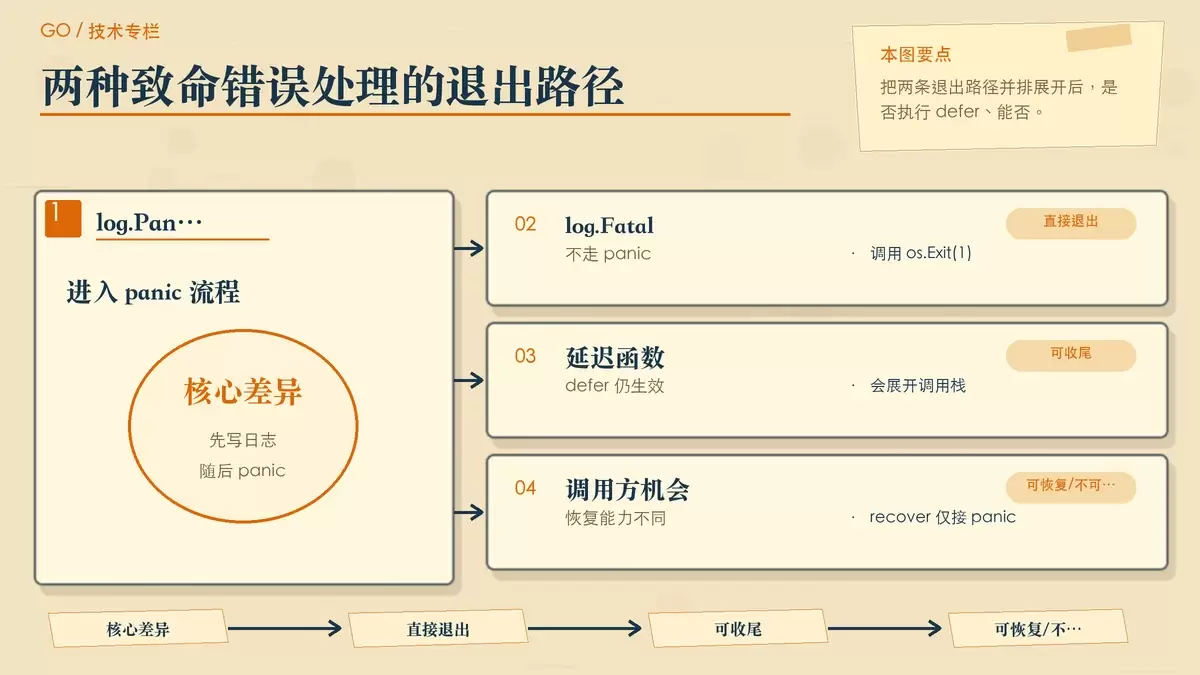
Go 开发里最耗时间的往往不是写代码,而是改一行就中断进程、重新编译、再等服务起来。本文梳理 Air、Reflex、CompileDaemon、Fresh 和 Realize 的定位、优缺点与适用场景,帮助你按项目规模、维护状态和配置复杂度选出更顺手的热更新工具。
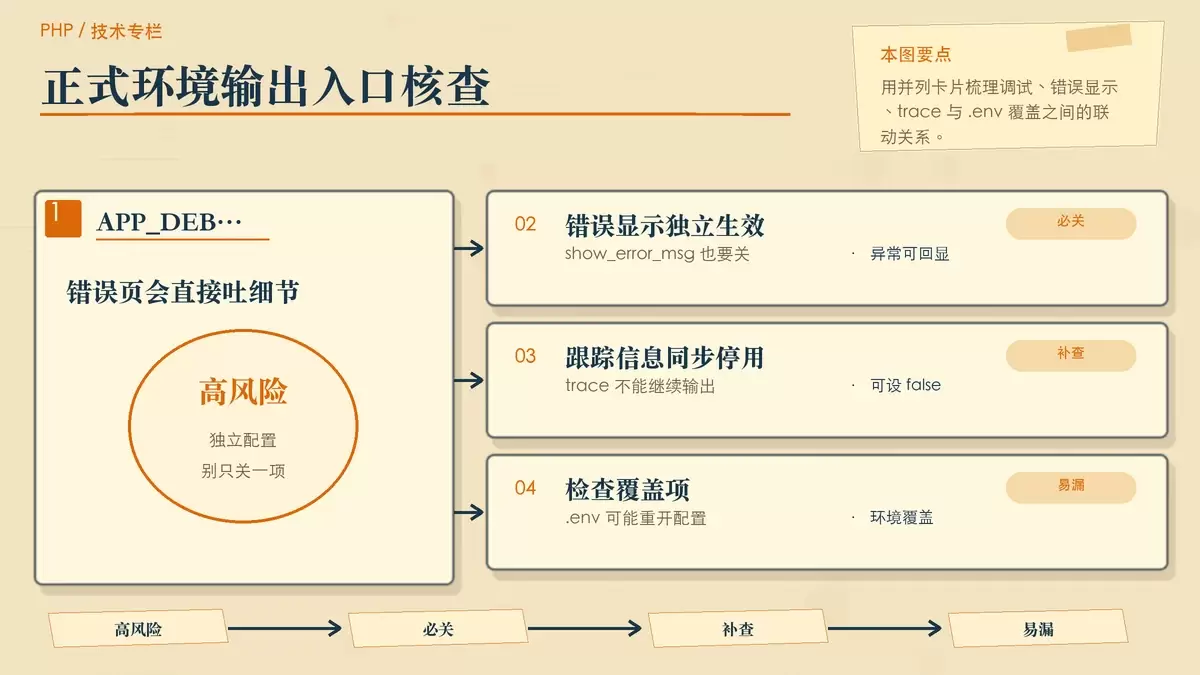
ThinkPHP 的敏感信息泄露通常不是单个开关失效,而是调试、错误显示、日志、运行时目录和代码写法叠加造成。本文按实际排查顺序梳理高风险暴露点,并给出可直接落地的关闭项、权限检查和代码修正要点。
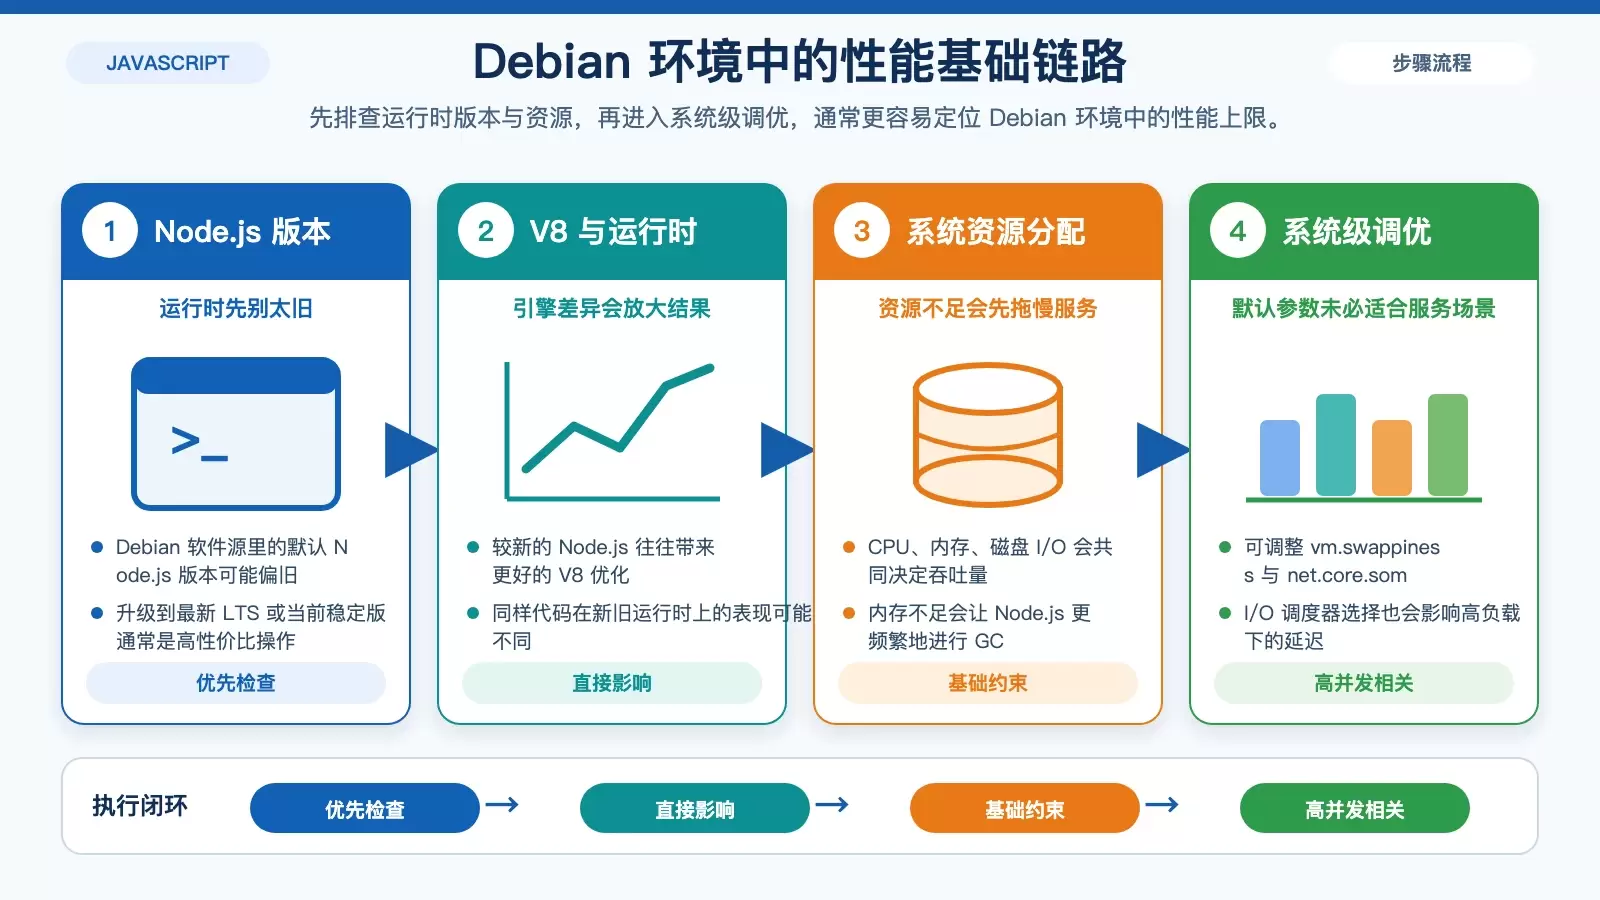
Debian 不会直接决定 JavaScript 的执行效率,但它会通过 Node.js 版本、系统资源、内核参数和网络路径影响应用上限。判断性能问题时,先分清系统环境瓶颈和代码层瓶颈,优化方向才不会跑偏。 很多人会把 Debian 和 JavaScript 性能看成两条互不相干的线,但真正上线部署时,操作系统环境往往决定了应用能不能稳定跑出预期表现。
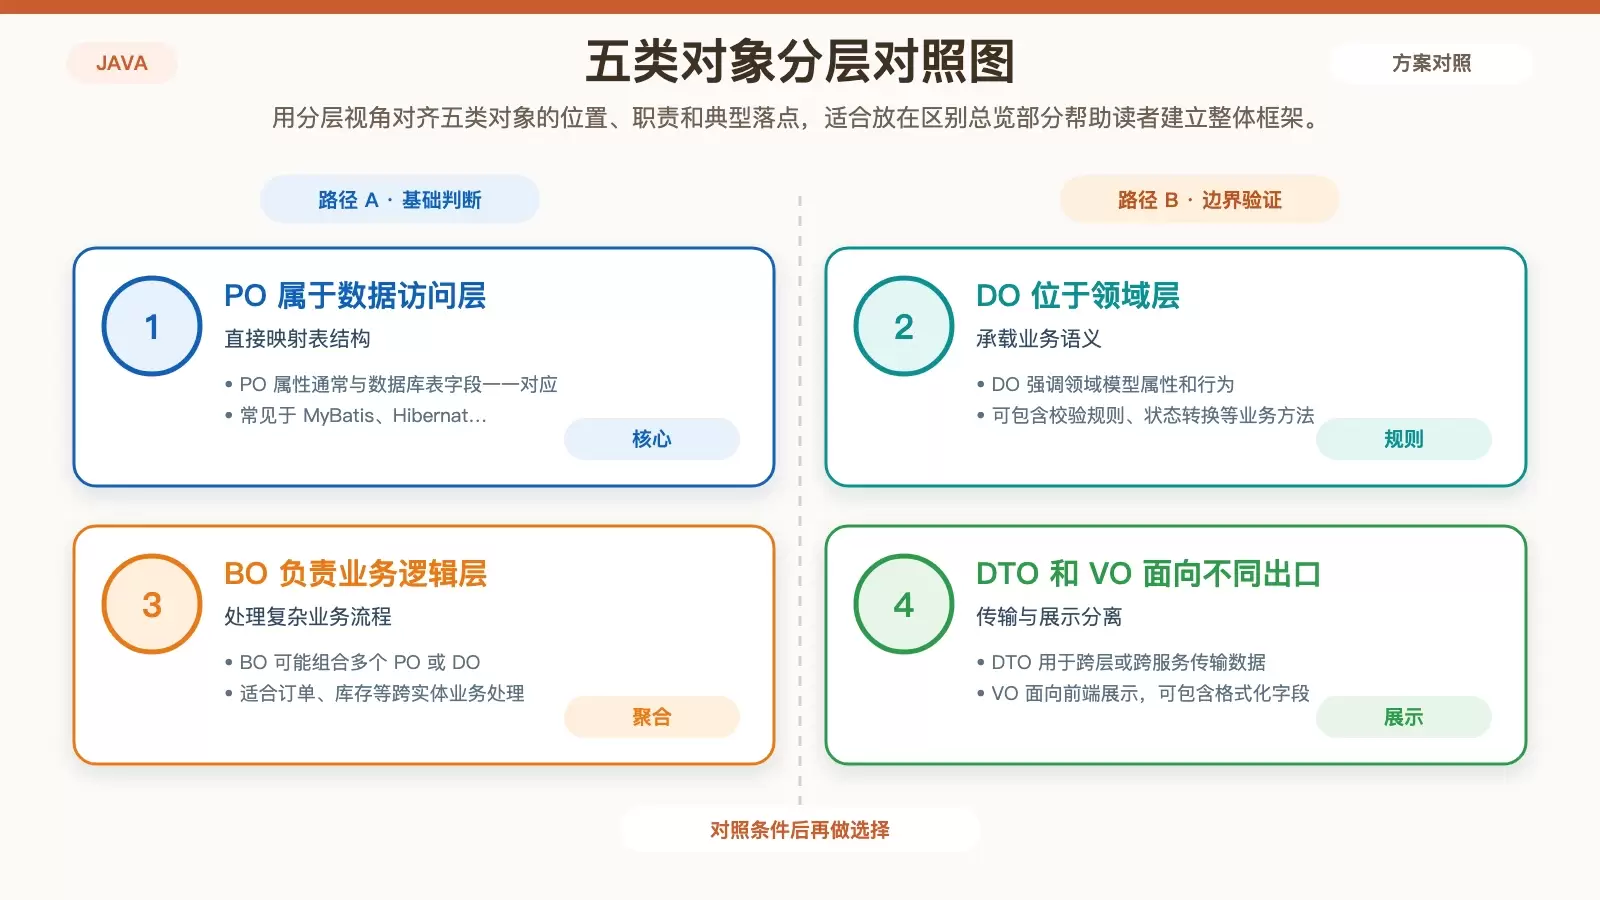
PO、DO、BO、DTO、VO 经常一起出现,但很多团队对它们的边界并不统一。本文按分层职责、典型场景和常见混用问题重新梳理 5 类对象,保留 Java 示例代码,并给出在小型项目和中大型项目中的实际取舍建议。
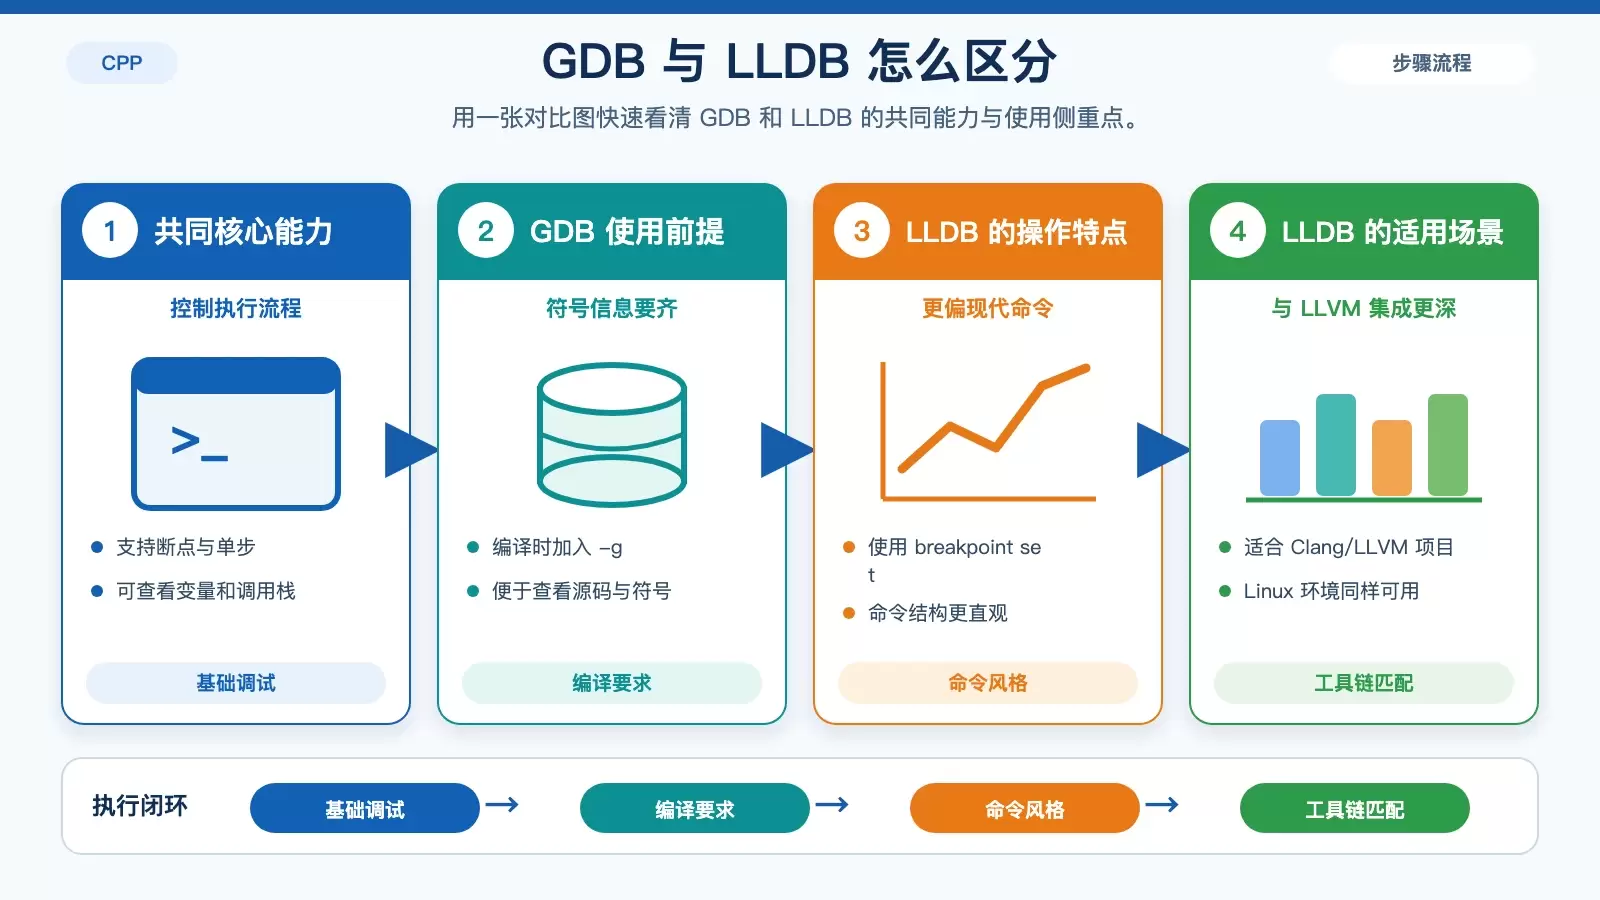
Linux 下调试 C++ 程序并不只有 GDB 一条路。命令行调试器、内存检查器、线程竞争检测器,再到 VS Code、CLion 这类图形界面工具,各自解决的问题不同。选对工具,往往比一味增加调试步骤更重要。 在 Linux 环境里调试 C++,真正麻烦的往往不是工具太少,而是不同错误该交给谁处理:崩溃排查、内存越界、线程竞争和日常断点调试,方法并。
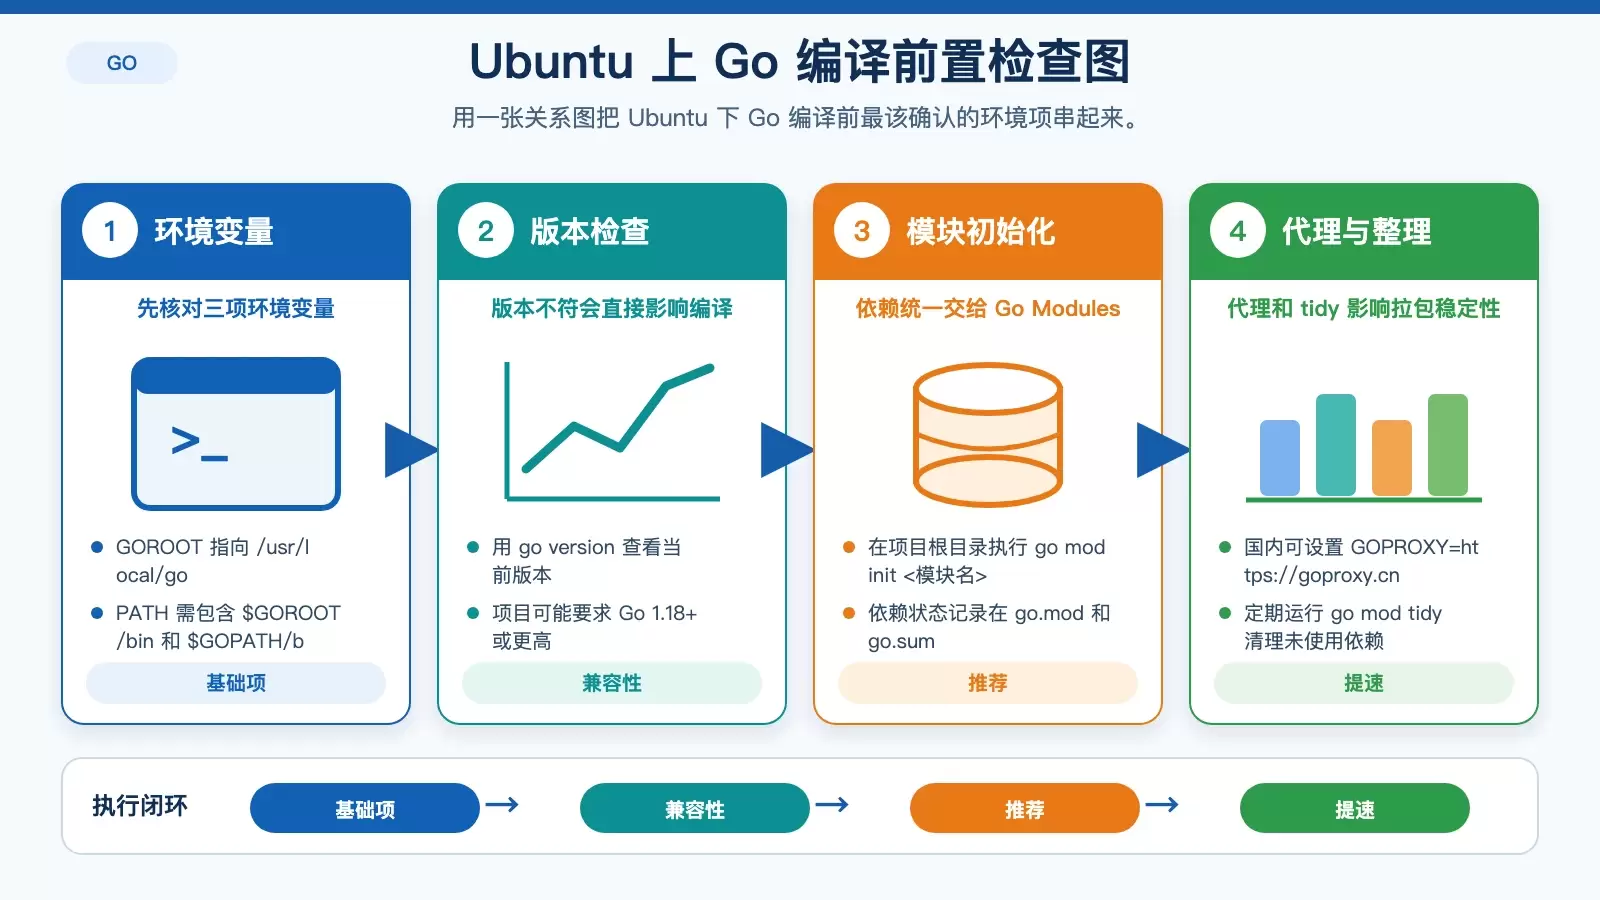
在 Ubuntu 上编译 Go 程序,真正容易出问题的往往不是 `go build` 本身,而是环境变量、依赖、交叉编译和缓存状态。本文按实际排查顺序梳理配置、构建优化与常见报错处理,方便你快速判断问题出在哪一层。
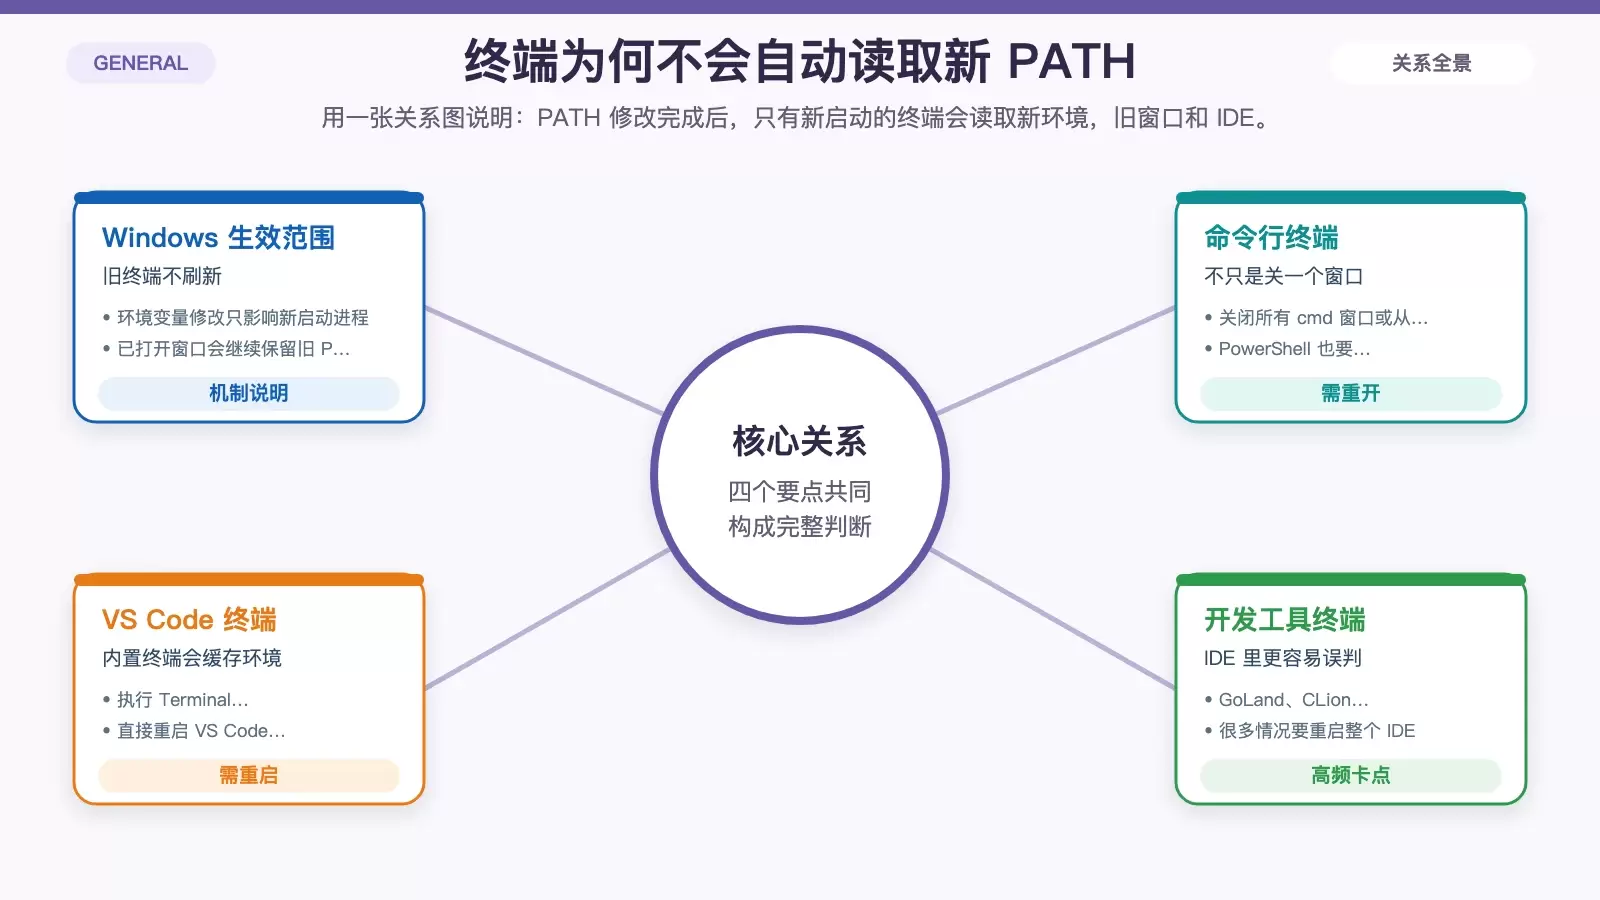
Windows 里改完 GCC 的 PATH 后,`cmd` 仍然提示找不到 `gcc`,多数情况下不是路径没配好,而是终端还在使用旧环境。本文按“为什么没生效、哪些终端必须重开、怎样验证、哪些路径细节容易出错”四步梳理,帮你快速判断问题到底出在终端缓存还是 PATH 写法。
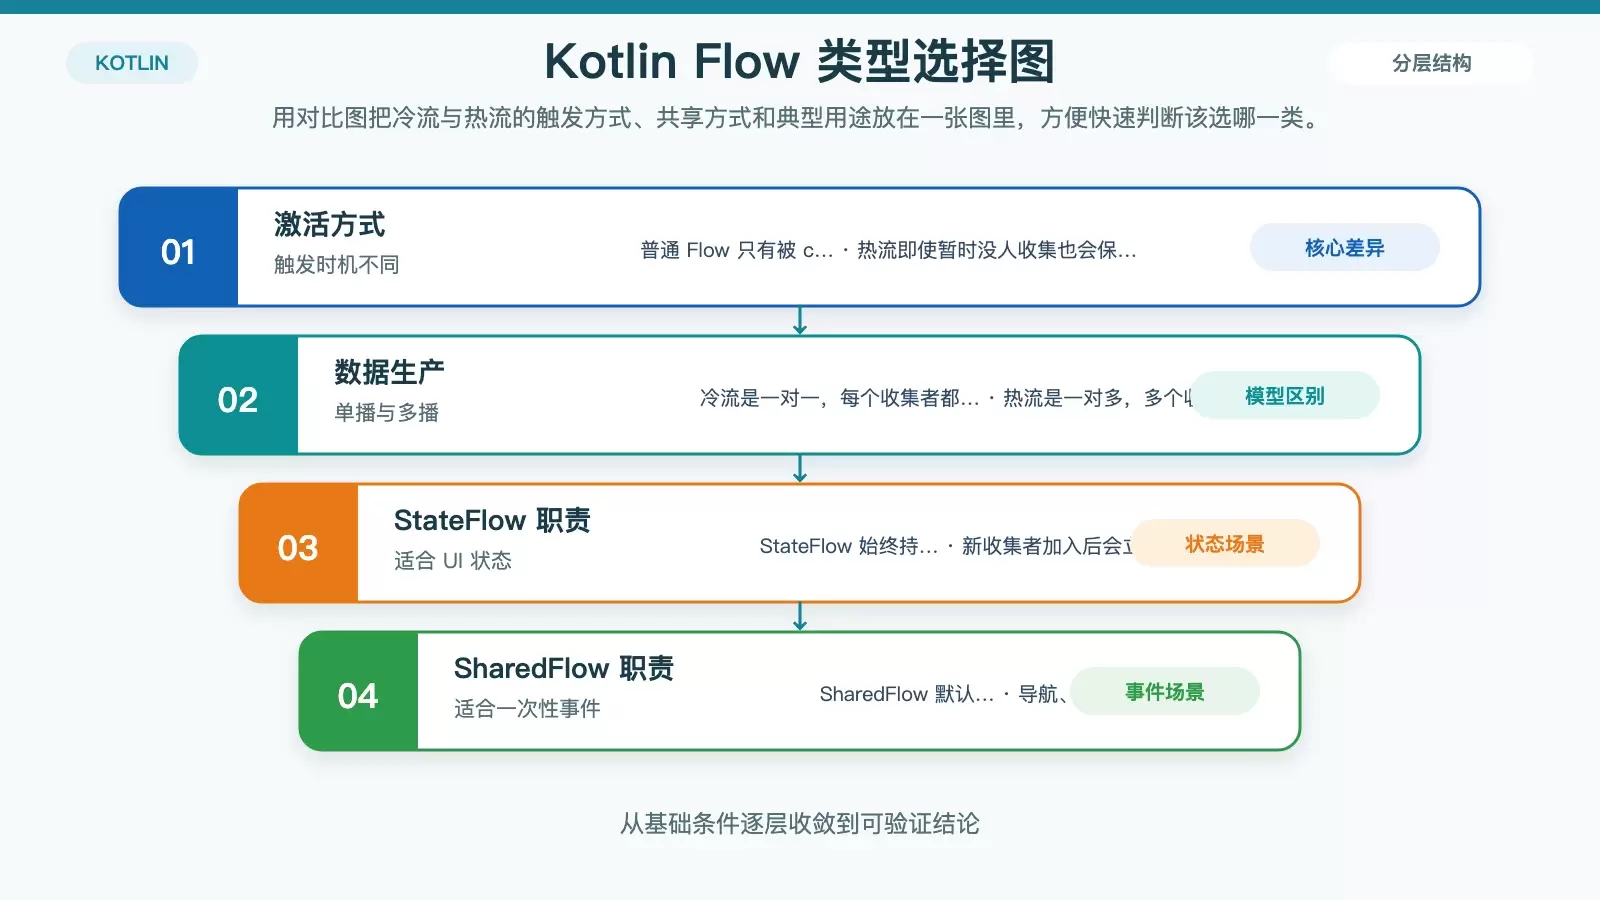
这篇文章用 Android 开发语境梳理 Kotlin Flow:先讲清冷流与热流的区别,再拆分 Flow、StateFlow、SharedFlow 的使用边界,最后补上在 Views 与 Compose 中安全收集的写法,以及常见操作符该放在哪一层。 Kotlin Flow 在 Android 里几乎已经是异步数据处理的默认选项,但真正落到项目中,很多人最容易混淆的还是三件事:普通 Flow、StateFlow、SharedFlow 各自该管什么,以及它们在 UI 层该怎么收集才不踩生。
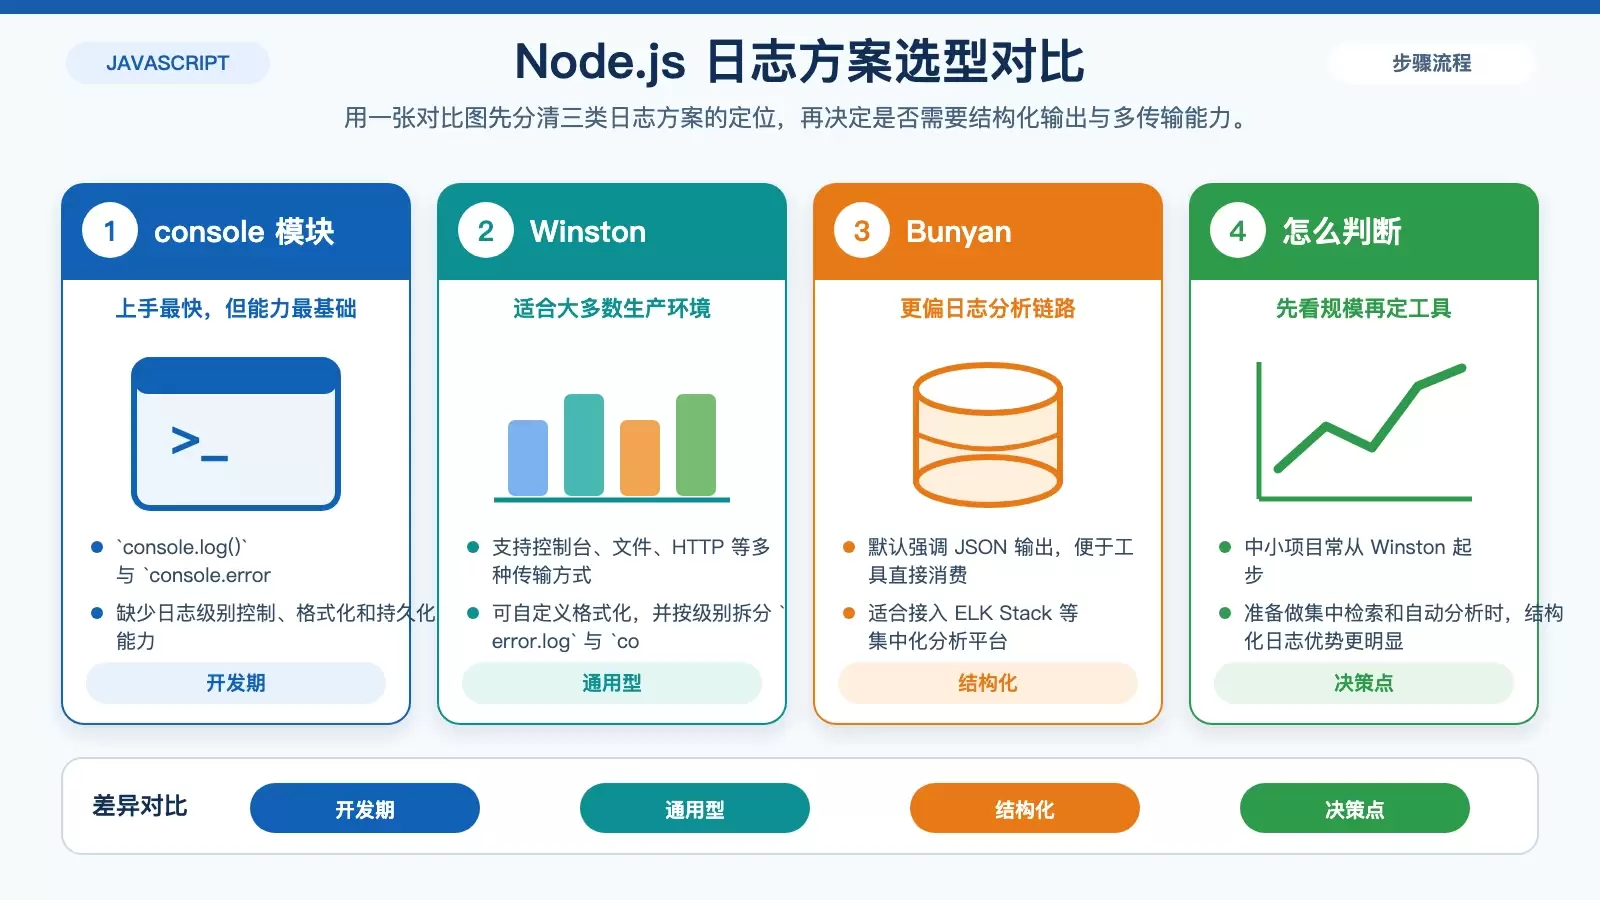
这篇文章按 Ubuntu 上 Node.js 日志管理的实际落地顺序,梳理了从 `console`、Winston 与 Bunyan,到日志轮转、PM2 以及 ELK 集中化方案的配置思路。重点不是工具越多越好,而是根据部署规模判断何时需要结构化日志、何时必须做轮转与统一检索。
这篇文章围绕 Laravel 5.5 集成 Scout 与 Algolia 的完整流程展开,涵盖依赖安装、配置发布、模型索引定义、批量导入以及常见超时问题处理。读完后,你可以判断这套方案是否适合自己的检索场景,尤其是国内网络环境下的实际可用性。