

详解Python遍历列表时删除元素的正确做法
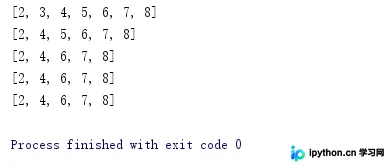
本文深入解析在Python中遍历列表并删除元素时的常见错误及四种正确解决方案。通过对比直接删除、新建列表操作、filter函数及列表解析和倒序遍历等方法,详细阐述其原理与适用场景,帮助开发者避免索引偏移导致的漏删问题,提升代码健壮性。
2026-10-12
22

本文深入解析在Python中遍历列表并删除元素时的常见错误及四种正确解决方案。通过对比直接删除、新建列表操作、filter函数及列表解析和倒序遍历等方法,详细阐述其原理与适用场景,帮助开发者避免索引偏移导致的漏删问题,提升代码健壮性。
本文详细解析如何在 Django 项目中实现自定义用户验证系统。通过继承 AbstractUser 创建自定义 User 模型,在 settings.py 中配置 AUTH_USER_MODEL 指向新表,并完成数据库迁移。文章进一步演示了如何使用 create_user 创建用户,以及利用 authenticate 函数进行身份验证,涵盖 POST 请求处理与结果判断。

本文详解pandas中筛选指定列值对应行的多种方法。涵盖布尔索引、基于iloc的位置索引、基于loc的标签索引及高效的query API。通过具体代码示例,演示如何筛选等于标量、属于范围、多条件组合及排除特定值的行,帮助开发者高效处理数据子集。
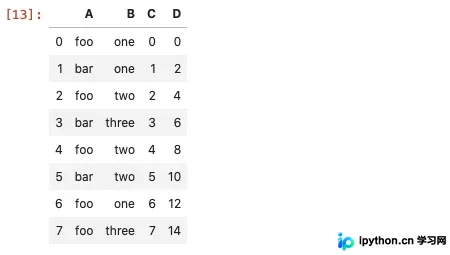
本文介绍Python中列表排序的两种核心方法:sort()与sorted()。sort()直接修改原列表,不返回值;sorted()返回新列表,保留原数据。通过示例演示升序、降序及自定义排序的实现方式,帮助开发者根据需求选择合适的方法。
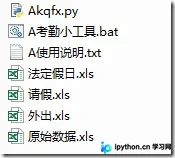
本文介绍如何利用Python的xlrd、xlwt和xlutils库自动化处理Excel考勤数据。重点解析日期与时间值的内部存储机制及数字类型转换问题,提供从读取多个Excel文件、比对请假与外出记录到生成校正后文件的完整代码示例,并通过.bat批处理文件实现一键执行,适用于办公场景下的考勤数据批量修正。
本文介绍如何在Python中使用pickle模块将变量保存到本地文件,以及如何从文件中读取变量。通过定义save_variable和load_variavle函数,实现变量的持久化存储和读取。
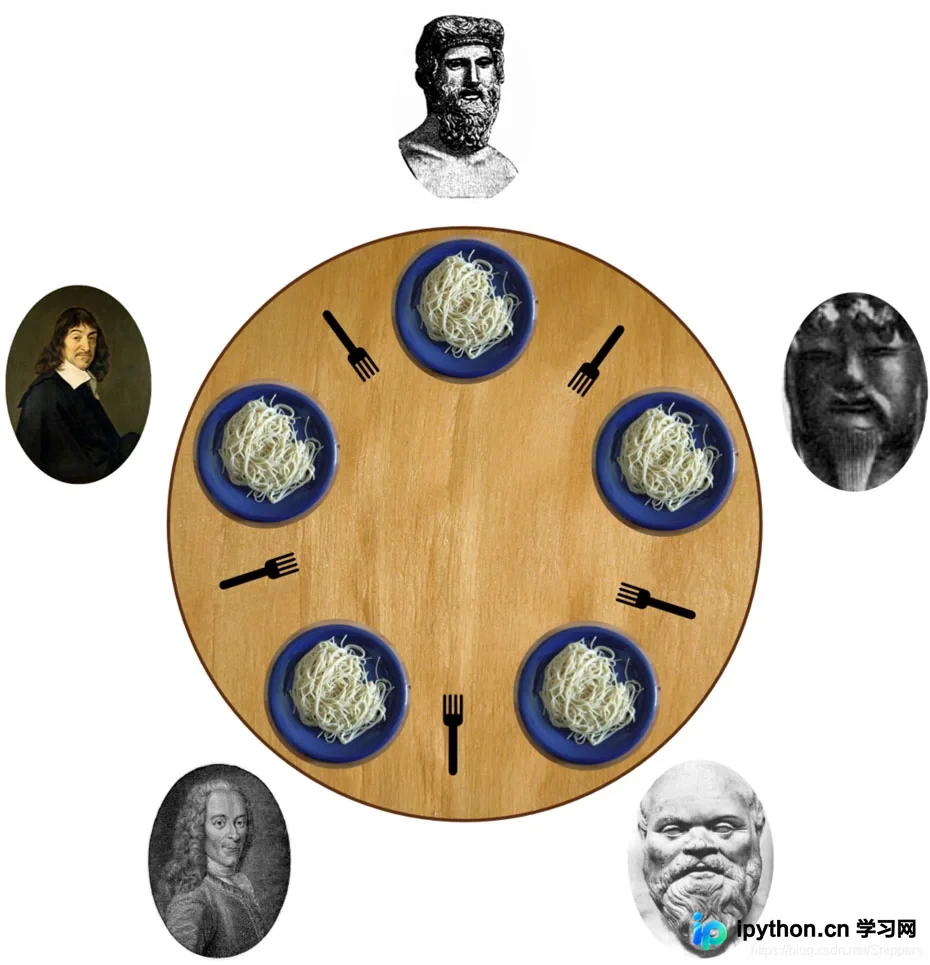
本文介绍如何使用Python多线程解决经典的哲学家就餐问题。通过定义CountDownLatch和DiningPhilosophers类,利用Lock实现叉子资源的互斥访问,并采用非阻塞获取策略避免死锁。代码完整展示了哲学家思考、拿取、进食及释放叉子的全过程,并输出符合格式的行为记录列表。
本文详细介绍如何利用 Python 和 Pymysql 库实现两个数据库之间的表结构同步。通过连接源数据库查询所有表名,并动态生成对应的创建表 SQL 语句,最终在目标数据库中执行这些语句以完成数据表的快速复制与结构同步,适用于需要批量维护多数据库结构的场景。
本文介绍如何使用Python实现针对C段IP地址的多线程Ping扫描脚本,以检测网络中存活的主机。通过多线程并发执行ping命令,利用Queue管理IP地址队列,并处理不同操作系统下的ping命令差异(Windows与Linux),从而高效完成网络扫描任务。
本文介绍如何在Python中实现背景音乐播放及视频音频混合。通过pygame库实现音频文件的加载与播放,利用subprocess调用ffmpeg命令行工具进行视频与多段音频的混合处理。
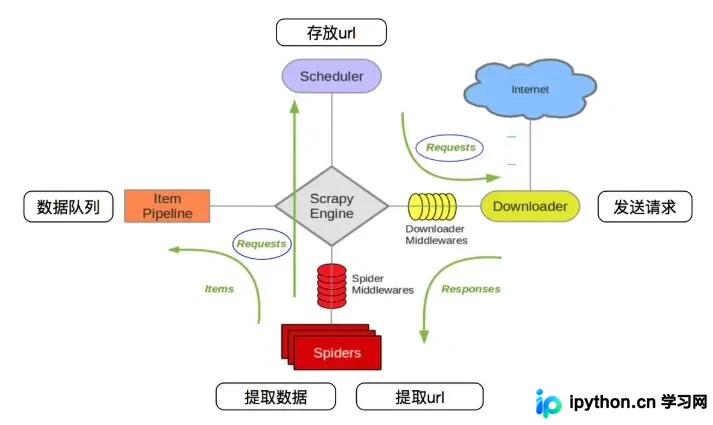
本文详解如何使用Scrapy框架通过携带Cookie的方式访问淘宝购物车。文章介绍了Scrapy架构,对比了三种登录方式,重点演示了手动提取Cookie并重写start_requests方法的过程。通过具体代码示例,展示了如何绕过登录验证获取购物车页面源码,为后续数据提取奠定基础。
本文解析Python中字符串格式化操作符%s、%d和%f的具体用法。通过定义包含占位符的模板字符串,将姓名、爱好等字符串数据与年龄、身高整数及体重浮点数进行映射。重点演示了如何控制浮点数保留小数位,并提供了完整的变量赋值与格式化输出代码示例。
