

SQL Server 查看 SQL 语句执行时间的三种方法
在 SQL Server 中,准确测量 SQL 语句的执行耗时是优化性能的关键。本文介绍了两种常用且有效的方法:一是利用 getdate() 和 datediff() 函数手动计算执行前后的毫秒级差值;二是使用 SET STATISTICS TIME ON 开启统计信息,直接获取语句编译和执行所消耗的 CPU 时间及 I/O 开销。通过合理选择工具,您可以快速定位耗时操作。
2026-10-16
10

在 SQL Server 中,准确测量 SQL 语句的执行耗时是优化性能的关键。本文介绍了两种常用且有效的方法:一是利用 getdate() 和 datediff() 函数手动计算执行前后的毫秒级差值;二是使用 SET STATISTICS TIME ON 开启统计信息,直接获取语句编译和执行所消耗的 CPU 时间及 I/O 开销。通过合理选择工具,您可以快速定位耗时操作。
本文深入解析MySQL数据库中自连接(Self Join)与子查询(IN/EXISTS)的核心概念与实战应用。通过PHP mysqli扩展演示如何编写SQL语句,处理具有层级结构的数据(如地区表)以及多表匹配过滤。文章提供了完整的连接代码、SQL模板及结果调试输出,帮助开发者掌握复杂数据检索技巧并理解底层逻辑。
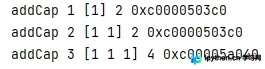
本文详细解析了Golang中Slice(切片)的扩容机制。当切片容量不足时,若容量小于1024,新容量翻倍;超过1024后,按1.25倍系数增长。通过代码验证发现,扩容不仅改变容量的数值,还会在触及原数组上限时分配新内存并拷贝数据,导致底层指针指向的地址发生变化,从而引发共享切片的观测值差异。
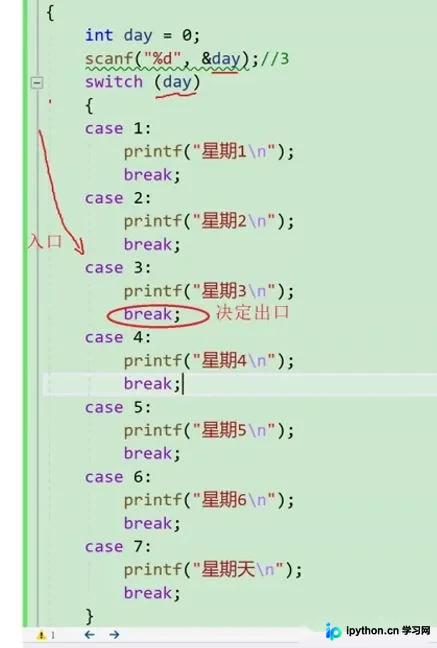
本文深入解析C语言中的分支与循环语句。涵盖if-else多分支逻辑、悬空else陷阱及代码书写规范;详解switch-case结构、default子句使用及break控制流机制;剖析while循环中break永久终止与continue跳过本次迭代的关键区别,助您掌握结构化编程核心。
本文介绍了在C#环境中如何利用NPOI库实现Excel与DataSet之间的互操作。涵盖从.xls和.xlsx文件解析数据到内存对象,以及处理列名识别、数据类型转换(如时间格式),同时将数据集反向导出为Excel文件的完整代码实现。
本文详细介绍C语言标准库中生成随机数的核心机制。通过深入解析伪随机数原理,演示如何使用 srand() 结合 time(NULL) 实现每次运行不重复的随机序列,以及利用取模运算将随机数限制在指定范围内,解决编程中抽奖、模拟等场景的随机需求。
本文详细解析C语言标准库中用于时间格式化的strftime()函数。通过剖析其四个核心参数,梳理常用格式化符号(如%Y, %m, %H等)及struct tm成员含义,并结合完整代码示例演示如何将time_t转换为指定格式的日期字符串,帮助开发者灵活处理时间显示需求。
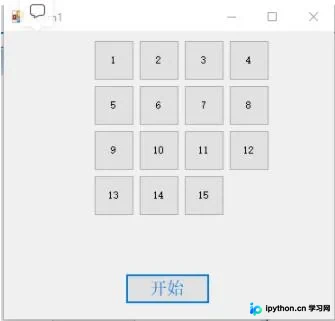
本文介绍如何使用C#和Windows Forms框架从零实现数字华容道游戏。通过二维数组管理按钮状态,利用随机交换算法生成初始乱序局面,并在点击事件中根据坐标逻辑判断相邻关系与移动合法性。附带完整源码,展示事件处理、UI布局及胜利条件检测的核心实现。
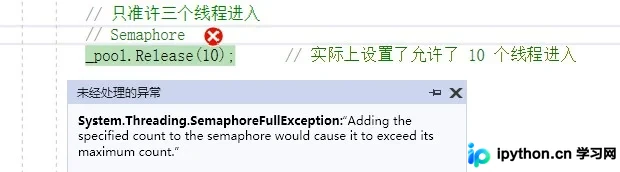
本文详解C#中用于限制并发线程数的Semaphore与SemaphoreSlim类。通过示例代码演示如何利用WaitOne/WaitAsync获取权限,以及Release释放资源,实现最多指定数量的线程同时进入资源池。文章对比两者在进程间同步、性能开销及API差异上的区别,帮助开发者选择合适的并发控制工具。
在MySQL中,当遇到大数据导入或更新失败时,往往是因为max_allowed_packet参数值过小。本文详细讲解了如何通过查看当前配置、修改配置文件(my.cnf/my.ini)以及在命令行临时调整这几种方法来正确设置该参数,有效解决因数据包限制导致的写入错误问题。
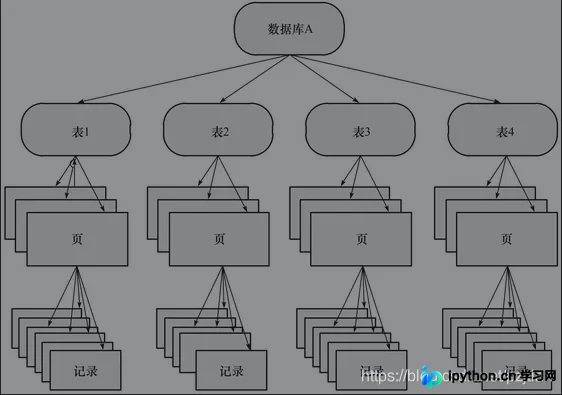
本文深入解析MySQL InnoDB存储引擎的锁机制,涵盖共享锁(S)、排他锁(X)及其兼容性,意向锁(IS/IX)的作用,以及MVCC非锁定读原理。详细对比Record Lock、Gap Lock和Next-Key Lock三种锁算法,阐述其在解决脏读、不可重复读和幻像问题中的应用,并介绍死锁检测与超时处理策略,帮助开发者优化高并发场景下的数据库性能。
本文介绍如何在C语言中统计二叉树的叶子结点个数。通过构建二叉链表结构,利用先序遍历递归算法判断左右子节点是否同时为空,从而累加叶子结点数。提供完整的创建、遍历及统计函数代码示例与输入输出验证。