Python中实现当前时间增加一天、一小时或一分钟的方法
本文介绍如何在Python中使用datetime和timedelta模块对当前时间进行增加操作,包括加一天、一小时和一分钟。通过示例代码展示如何获取当前时间、格式化输出以及进行时间增量计算,并提供相关在线工具推荐。
2026-10-13
23

本文介绍如何在Python中使用datetime和timedelta模块对当前时间进行增加操作,包括加一天、一小时和一分钟。通过示例代码展示如何获取当前时间、格式化输出以及进行时间增量计算,并提供相关在线工具推荐。
本文系统讲解Pandas核心数据处理技巧,涵盖数据清洗(缺失值处理、重复值去重)、排序(索引与值排序)、索引管理(reindex、set_index、reset_index)及高效数据选取(loc、iloc、query)。通过具体代码示例,帮助开发者掌握从基础属性到高级操作的全流程方法,提升数据处理效率。
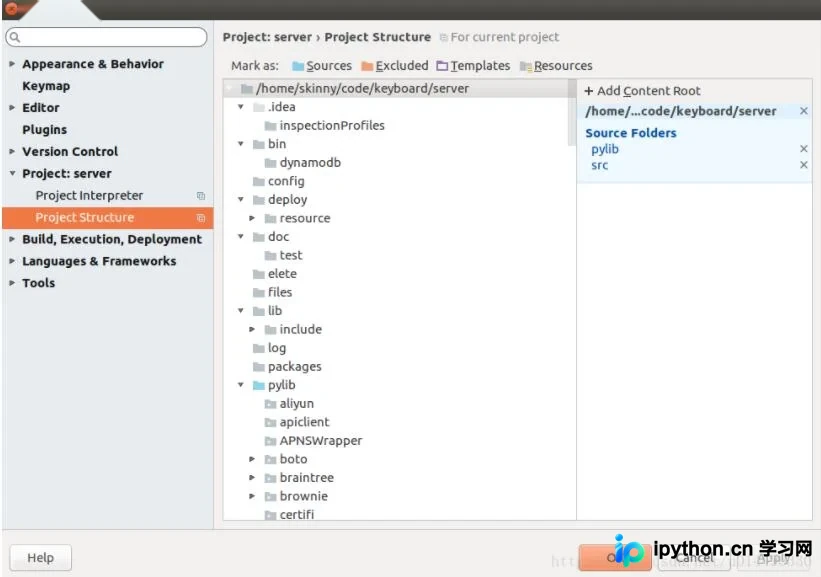
本文解决PyCharm中Unresolved reference报错及模块导入失败问题。核心原因是PyCharm默认项目根目录为source目录,导致绝对路径查找异常。通过修改代码为相对路径或正确设置Source Root(将包文件夹标记为Source),可修复导入错误,确保IDE能正确识别模块路径。
本文分析了使用nohup重定向Python程序输出到文件时,因标准输出缓冲导致内容未实时写入的问题。提供了两种有效解决方法:一是在运行命令中增加-u参数以关闭缓冲;二是在代码中调用sys.stdout.flush()强制刷新缓冲区,确保日志正常保存。
本文介绍如何利用Python的Splinter库进行浏览器自动化操作。通过两个具体案例,演示如何初始化浏览器、访问网页、填充表单元素以及模拟点击按钮。文章涵盖Google搜索跳转验证及126邮箱自动登录的实现细节,包括元素定位、等待机制及资源释放,为Web应用测试提供基础参考。
本文总结了Python 3中实现print输出重定向的三种主要方法。包括直接通过文件对象写入、利用sys模块临时重定向标准输出流,以及通过编写包含write方法的自定义类来捕获输出。文章提供了具体的代码示例和操作步骤,帮助开发者在不同场景下灵活处理程序输出。
在Python3环境下,cv2.imwrite无法直接处理包含中文字符的文件路径。本文介绍使用cv2.imencode结合tofile方法作为替代方案,通过视频帧提取示例演示如何正确保存带有中文路径的图片文件,解决编码兼容性问题。
本文介绍在Python环境中使用pytesseract库识别图片文字的方法。详细列出安装Python 2.7或3.4、Pillow、tesseract-ocr及pytesseract的步骤,涵盖Ubuntu环境下的具体命令。通过示例代码展示识别过程,并提示可能出现乱码的情况,供开发者参考。
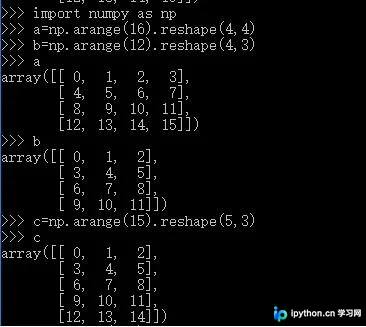
本文介绍NumPy中数组拼接的两种常用方式。第一种通过np.vstack()实现垂直拼接,np.hstack()实现水平拼接;第二种利用np.c_[]按列合并,np.r_[]按行合并。掌握这些方法可高效处理多特征样本数据的合并分析。
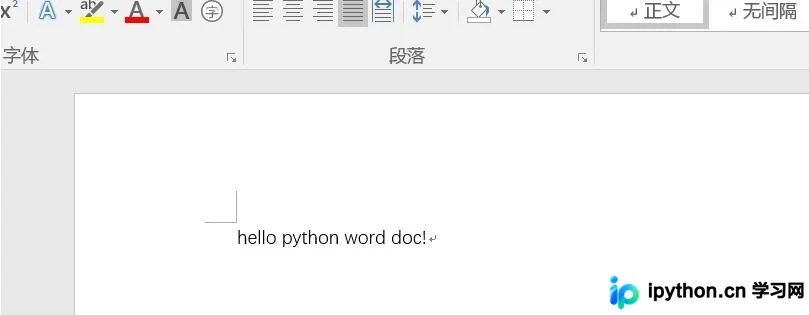
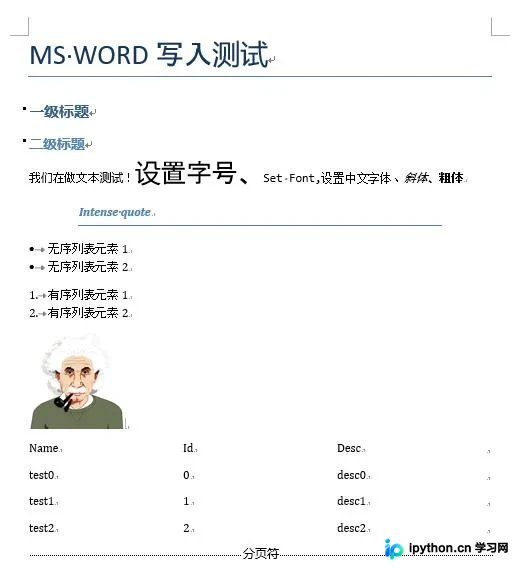
本文详细介绍如何使用Python的python-docx库进行Word文档的读写操作。涵盖环境安装、文档创建与保存、段落与表格处理、样式自定义及字体设置等核心功能,提供具体代码示例,帮助开发者快速掌握Word文档自动化处理技能。
本文详解如何使用python-docx库读写MS Word文件。通过pip安装后,演示添加标题、文本样式及表格的完整代码,并展示读取docx内容的实现。特别指出读取doc文件时的编码问题,建议使用utf-8或批量转换为docx格式,助力开发者快速掌握Word自动化处理。
本文介绍利用Python的win32 COM接口自动化操作Word文档的方法。通过Dispatch调用Word应用,演示了如何创建新文档、插入文本内容、保存为docx文件并关闭程序。该方法适用于Windows环境下需要批量处理Word文件的场景,代码简洁且无需额外第三方库,仅依赖系统组件。