

在IPython中执行Python脚本与格式化输出技巧
本文介绍在IPython环境中执行Python程序文件的方法。通过%run命令可直接调用脚本,相比传统模块导入更便捷。同时对比展示了IPython对字典等数据结构的默认输出与格式化输出差异,并结合Windows 10环境下的pwd命令及Tab自动补全功能,提升开发效率。
2026-10-13
23

本文介绍在IPython环境中执行Python程序文件的方法。通过%run命令可直接调用脚本,相比传统模块导入更便捷。同时对比展示了IPython对字典等数据结构的默认输出与格式化输出差异,并结合Windows 10环境下的pwd命令及Tab自动补全功能,提升开发效率。
本文详解Ubuntu系统中Python2与Python3共存时的默认调用机制及切换方法。通过查看版本、使用alias别名或update-alternatives配置工具,可将默认python命令指向Python3。同时补充了pip安装注意事项,确保开发环境稳定运行。
本文深入解析Numpy中的向量式三目运算符np.where,通过对比纯Python列表推导式与np.where的运算结果,验证两者在数值上的一致性。重点展示np.where在处理条件筛选时如何利用向量化计算显著加速运算过程,适用于需要高效数据筛选的场景。
本文针对Python中使用f.write写入中文时出现的编码错误问题,提供了两种有效的解决方案。主要原因为默认编码方式不匹配,建议显式指定UTF-8编码进行写入,或通过修改系统默认编码来解决,确保中文内容能正确保存至文件。
本文解析Python中None与空值的区别,并提供判断参数是否为None或空的代码示例。通过if-elif-else结构演示如何区分NoneType与空字符串,帮助开发者避免常见错误。
本文介绍在Python Pandas中处理缺失值的方法。通过创建包含NaN的DataFrame,利用merge进行左连接后,使用fillna(0)函数将所有NaN值替换为0。代码示例展示了从数据合并到缺失值填充的完整流程,适用于数据预处理场景。
本文介绍在Python Pandas中处理数据清洗时遇到的空值与空格混合问题。通过两种方法:一是利用布尔数组筛选,二是使用apply函数将空格转为NaN后处理,并结合具体代码示例展示如何替换DataFrame中的NaN值,帮助开发者更准确地获取有效数据。
本文详细介绍在Ubuntu系统中下载、解压并安装PyCharm Community版的完整流程。重点讲解新建或打开项目时如何指定Python解释器(如python2.7),以及在配置文件中手动添加PYTHONPATH等环境变量的具体操作步骤,确保项目依赖正确加载。
本文通过具体代码示例,演示了Python中如何使用startswith和endswith方法判断字符串是否以特定字符开头或结尾。文章涵盖了基础用法及包含起始和结束索引参数的进阶用法,帮助开发者快速掌握字符串前缀和后缀的匹配技巧。
本文介绍如何在图像识别中绘制特定大小和角度的矩形框。通过Python PIL库计算旋转后的顶点坐标并绘图,随后提供将该逻辑移植到C++环境的实现思路与代码片段,帮助开发者在跨语言项目中复用该功能。
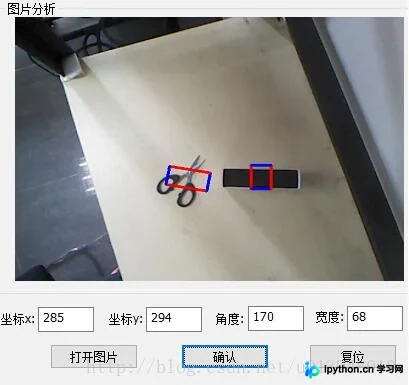
本文介绍在 Python 中自动安装缺失库文件的方法。通过 os.system 执行指令,可处理如 tqdm 等库的安装。示例代码展示了 try-except 捕获导入错误并自动执行 pip3 安装的操作,适用于需要动态依赖管理的场景。
本文介绍如何使用Python递归遍历文件夹,并高效筛选出以指定后缀名结尾的文件。通过定义辅助函数判断序列中是否存在满足条件的元素,结合os.listdir实现目录遍历,支持多后缀匹配。示例代码展示了基础实现与包含计时统计的优化版本,适用于需要批量处理特定格式文件的场景。