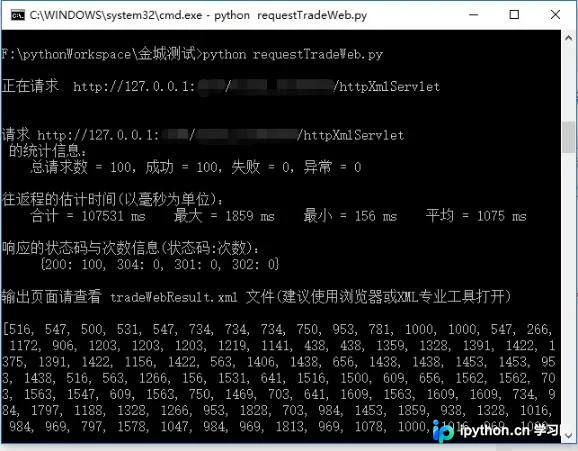
Python 3.x 实现基于 XML 数据的 HTTP 请求与多线程压力测试
本文介绍如何使用 Python 3.x 编写基于 XML 数据的 HTTP 请求脚本,适用于 B/S 架构下的 WEB 服务通信测试。文章详细讲解了利用 urllib.request 发起请求、多线程并发处理、类与方法定义等核心技术,并提供了包含配置文件和源码的完整示例,旨在帮助开发者快速实现功能验证及初步的压力测试。
2026-10-13
23

本文介绍如何使用 Python 3.x 编写基于 XML 数据的 HTTP 请求脚本,适用于 B/S 架构下的 WEB 服务通信测试。文章详细讲解了利用 urllib.request 发起请求、多线程并发处理、类与方法定义等核心技术,并提供了包含配置文件和源码的完整示例,旨在帮助开发者快速实现功能验证及初步的压力测试。
本文介绍利用Python通过pykafka消费Kafka数据,并批量插入Elasticsearch的方法。针对Kafka 0.8版本,使用get_simple_consumer确保多应用不重消费。通过设置consumer_timeout_ms避免阻塞,并配合死循环持续处理。当数据达到阈值时,利用bulk接口批量写入ES,适用于高并发数据场景。
本文介绍在IoT PoC项目中,通过Python脚本周期性探测本地IP地址变化以指示设备移动性。当设备作为视频接收端发生移动导致IP变更时,系统自动向发送端发起携带新IP的内容请求,确保视频流畅度。代码利用ipconfig指令获取IP,并提供了Socket获取外网IP的替代方案思路,适用于需要感知网络环境变化的场景。
本文介绍如何在Python中利用requests库模拟浏览器行为发送HTTP请求。通过构造包含User-Agent、Accept等字段的Headers字典,并配置代理服务器,可实现与真实浏览器相似的请求特征。示例展示了GET请求的完整参数设置及状态码获取方式,适用于需要规避基础反爬机制的场景。
本文详细介绍如何利用Python的re模块通过正则表达式分别匹配IP地址、URL网址以及电子邮件地址。文章提供了具体的正则模式代码及测试示例,帮助开发者快速掌握网络数据格式验证的核心技巧。
本文介绍如何使用Python的re模块匹配两个指定短语之间的字符。通过open读取文件,利用re.findall配合非贪婪模式.*?提取目标内容,并遍历打印结果。
本文介绍在Python中判断一个列表是否包含另一个列表全部元素的两种方法。第一种通过for循环配合in关键字进行逐个检查;第二种利用集合特性,将列表转换为集合后判断子集关系。文中提供了具体的代码示例及运行结果,帮助开发者快速掌握相关技巧。
本文介绍在Python3中利用csv模块将CSV文件数据读取并转换为字典格式的具体实现方式。通过示例代码展示了如何打开文件、获取字段名以及逐行处理数据生成字典对象,供开发者参考使用。
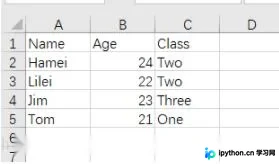
本文介绍在Python中将TXT文件数据读取并转换为NumPy数组或列表的方法。针对包含混合数据的TXT文件,提供逐行处理并转为数组的代码示例;针对纯数字文件,推荐loadtxt直接读取。同时详细解析split和strip函数的语法、参数及实际应用案例,帮助开发者高效处理文本数据。
本文介绍如何利用Python pandas库进行数据差分运算。通过df.diff()方法,可实现纵向一阶、横向一阶及多阶(如periods=2)差分计算。文章包含完整代码示例,展示如何处理空值及不同轴向的差分结果,适用于时间序列分析与特征工程场景。
本文介绍如何使用Python读取TXT文件,并通过split()方法去除每行空格后计算实际字符长度。提供了完整的代码示例,展示如何打开文件、逐行读取、处理字符串及计算长度,最后关闭文件。适合需要处理文本数据的开发者参考。
本文提供使用Python采集微信公众号文章的完整代码方案。通过搜狗微信搜索接口获取文章列表,利用PyQuery解析内容,并将结果存储至MongoDB。代码包含配置模块config.py及主程序采集公众号文章.py,支持关键词搜索、分页抓取及代理池配置,实测可有效运行,适合Python初学者参考学习。