

pandas DataFrame转字典:直接转换方法与结果分析
本文介绍如何使用pandas将DataFrame直接转换为字典对象。通过dict()函数转换,生成的字典键为列名,值为对应的Series对象。文章展示了具体代码实现及输出结果,包括列名列表和值的数据类型,帮助开发者理解转换后的数据结构。
2026-10-13
24

本文介绍如何使用pandas将DataFrame直接转换为字典对象。通过dict()函数转换,生成的字典键为列名,值为对应的Series对象。文章展示了具体代码实现及输出结果,包括列名列表和值的数据类型,帮助开发者理解转换后的数据结构。
本文提供使用Python matplotlib.pyplot库绘制图表并保存为图片的完整代码示例。内容涵盖figsize设置、坐标轴刻度与标签配置、背景颜色调整及数据标签显示,最后通过savefig实现导出保存,适合需要快速掌握基础绘图保存功能的开发者参考。
本文详细介绍Python中Plotly库的安装方法及在线、离线两种绘图模式。通过pip安装Plotly后,开发者可利用其接口快速生成图表。文章对比了在线保存至网站与本地生成图像的区别,并提供了基础代码示例,帮助初学者掌握Plotly在数据科学中的应用。
本文介绍在Numpy中将二维数组添加至空数组的方法。核心在于确保参与操作的数组维度一致。通过定义形状为[0,3]的空数组,利用np.append函数并指定axis=0,依次将不同二维数据追加,最终实现多维数据的合并与形状验证。
本文通过Python3代码实例,详细演示如何求一个数的最大约数(不含本身)、两个数的最大公约数(GCD)以及最小公倍数(GCM)。内容涵盖判断素数的逻辑、辗转相除法求GCD的实现,以及利用积与GCD关系求GCM的方法,为Python初学者提供清晰的算法参考。
本文介绍了如何使用Python生成特定分布的随机数,包括泊松分布和负二项分布。通过示例代码展示了具体实现方法,并利用matplotlib进行数据可视化,帮助读者理解和应用这些统计分布。
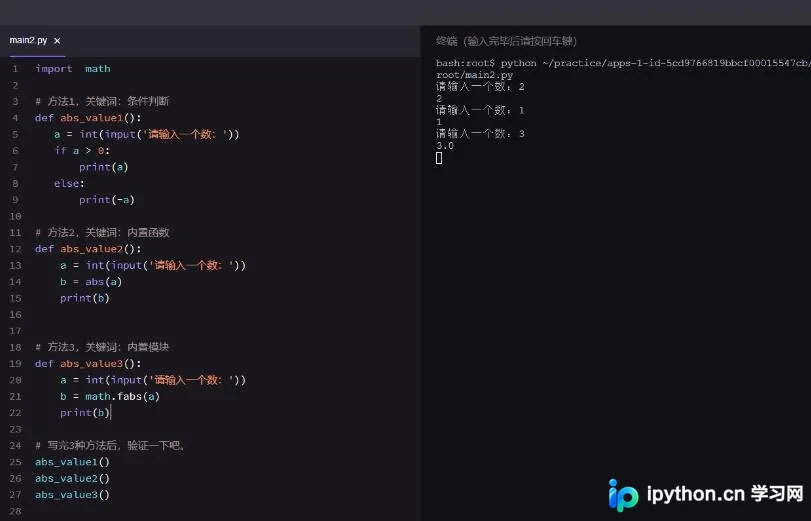
本文总结Python中获取绝对值的三种常用方法:条件判断、内置函数abs()以及math模块中的fabs()。重点解析了abs()与fabs()在参数类型支持(如复数)及返回值类型(int/float)上的关键区别,帮助开发者根据实际需求选择最合适的实现方式。
本文介绍如何在Python中使用Matplotlib绘制图表时,解决横坐标中文显示为方块或乱码的问题。通过封装自定义库py_hanzi并调用set_ch()函数,配置默认字体为仿宋并关闭Unicode负号显示,即可实现横坐标汉字的正常渲染。
在Python中,若需预先分配固定大小的列表,直接append效率较低。本文介绍两种高效初始化定长数组的方法:使用列表推导式[[wp:a0]]或乘法运算符[[wp:a1]]。通过示例展示如何快速生成包含指定数量元素的列表,适用于需要预分配内存的场景。
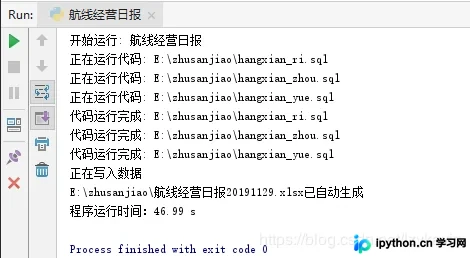
本文介绍利用Python实现固定报表的自动化生成。通过多线程并发执行Oracle SQL查询,解决Excel写入冲突;使用xlwings和Pandas将结果写入指定模板并生成带日期命名的新文件。集成logging记录日志,并结合try...except实现错误自动重试,确保报表生成的稳定性与效率。
本文介绍如何在Python中使用numpy库合并两个矩阵。主要讲解hstack和vstack两个函数的用法:hstack用于在行方向上水平合并矩阵,vstack用于在列方向上垂直合并矩阵。通过具体代码示例展示如何调用np.hstack和np.vstack实现矩阵拼接,适用于科学计算中的数据处理场景。
本文介绍如何利用Python的NumPy库将三维数组转换为二维数组。通过np.reshape函数,指定目标维度如(a, b),其中-1可自动计算未知维度,实现数组形状的重塑。示例展示了(4,3,2)数组展开为(12,2)的过程,保持最后一维相对位置不变,适用于数据预处理和模型输入调整。