

Python列表遍历的5种常用方法及文件遍历技巧
本文总结了Python中遍历列表的五种主要方法,包括基础的for循环、while循环、索引访问、iter()迭代器以及enumerate()枚举器,并详细解析了各方法的代码示例与运行结果。此外,文章还扩展介绍了在验证码识别等场景下,利用os模块进行文件遍历的三种实现方式,涵盖listdir、path.walk及os.walk的使用差异与注意事项。
2026-10-14
18

本文总结了Python中遍历列表的五种主要方法,包括基础的for循环、while循环、索引访问、iter()迭代器以及enumerate()枚举器,并详细解析了各方法的代码示例与运行结果。此外,文章还扩展介绍了在验证码识别等场景下,利用os模块进行文件遍历的三种实现方式,涵盖listdir、path.walk及os.walk的使用差异与注意事项。
本文详解在Python中如何在一个.py文件中调用另一个.py文件内的函数。针对同目录场景,介绍了直接import和from...import两种写法;针对跨目录场景,讲解了通过sys.path添加路径及使用imp模块加载源文件的方法。内容涵盖具体代码示例与注意事项,帮助开发者解决模块引用问题。
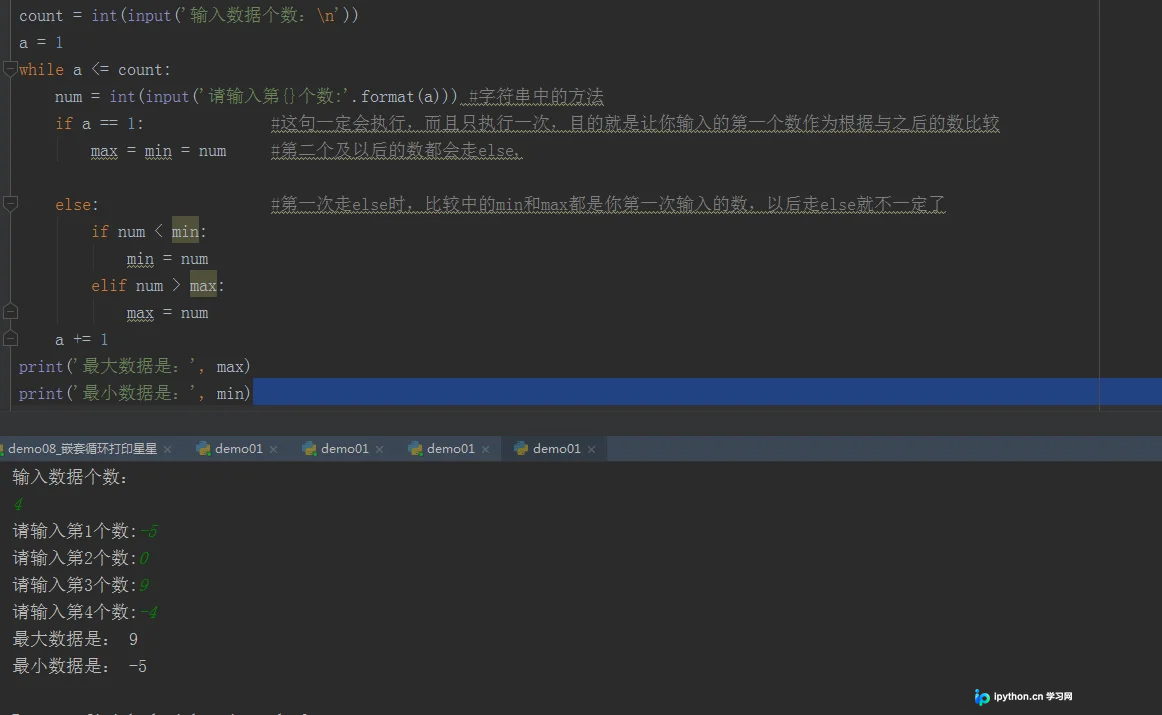
本文总结了Python中获取最大值和最小值的两种常见方法。第一种通过循环逐个比较输入数据,无需额外存储;第二种将所有数据存入列表后直接调用内置函数。两种方法均包含完整代码示例,适用于不同场景下的极值计算需求。
本文介绍利用Python3.6及urllib库抓取某平台翻译资源,实现中英互译功能。通过构造请求参数调用翻译接口,解析返回的JSON数据并展示翻译结果,包含输入、处理及输出完整流程,供开发者参考学习。
本文深入解析编译型与解释型语言的执行机制。通过对比源代码到可执行文件的转换流程,阐述编译器、链接器及预处理器的作用,并分析解释器逐行执行的特性。重点说明编译型语言因生成机器码而具备更高的运行速度,以及链接器在整合库文件中的关键角色。
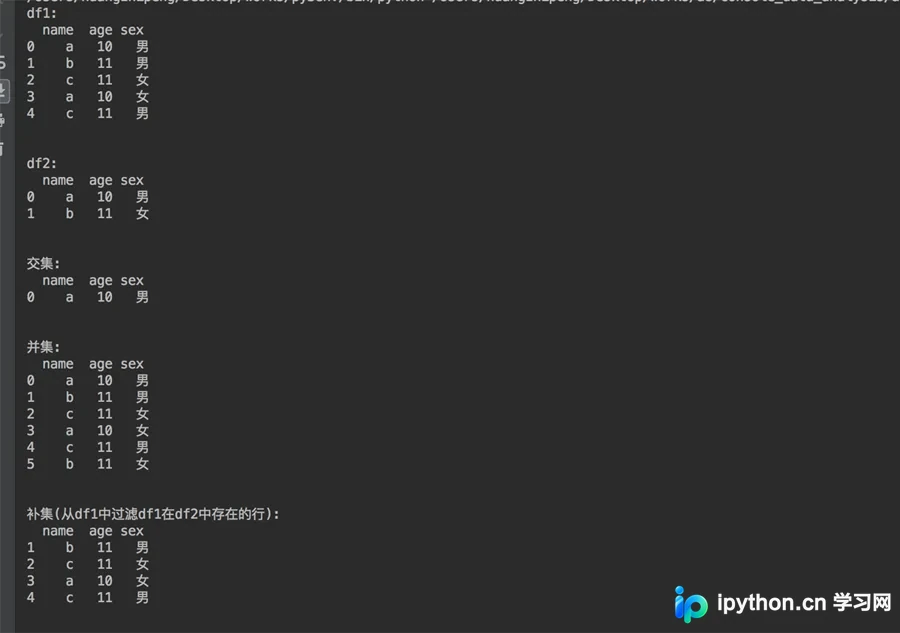
本文介绍在 columns 相同的 DataFrame 中进行集合运算的方法。利用 pd.merge 配合 on 参数可获取交集,设置 how='outer' 获取并集。对于补集(从 df1 中剔除 df2 存在的行),通过 append 合并后使用 drop_duplicates 保留唯一值实现。
在Python遍历二维数组时,直接在内层使用break无法终止外层循环。本文介绍利用for...else语法结构实现跳出双层循环的方法:当内层循环未执行break时,外层循环继续;若内层执行break,则触发外层的else分支并跳出。该方法简洁高效,适用于需要提前终止嵌套遍历的场景。
本文介绍如何在Python中通过调用Windows API实现在CMD窗口输出彩色文字。通过导入自定义模块,使用cprint函数指定颜色参数,即可轻松实现不同颜色的文字显示效果,解决默认暗白色文字不易辨识的问题。
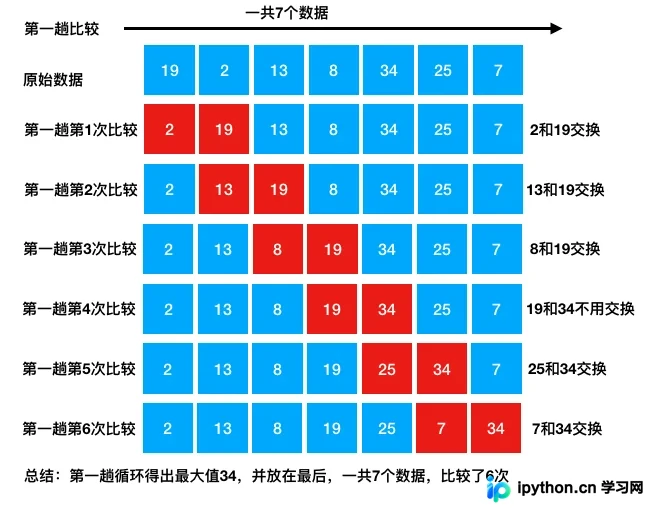
本文详细解析冒泡排序算法,涵盖其基本工作原理、图解演示及Python与C语言代码实现。重点介绍通过标志位进行的性能优化策略,分析最优与最坏时间复杂度,并论证其稳定性。适合初学者掌握基础排序逻辑及进阶优化技巧。
本文详细介绍Python中pandas库创建DataFrame的多种方法,包括从字典和列表构建数据框、指定列名与顺序、修改列名以及生成随机整数数据。同时演示如何使用时间序列作为索引,并简要提及类SQL操作功能,帮助开发者快速掌握DataFrame的基础构建技巧。
本文解决Python2.7环境下os.path.isdir等路径判断方法对含中文路径返回False的问题。通过对比IDE与交互式命令行执行结果,定位原因为字符串编码差异。核心解决方案是将中文路径字符串转换为Unicode对象,例如使用u前缀或unicode()函数,确保路径处理一致性与准确性。
本文分析Python通过ctypes调用C语言SO库时出现的Segment Fault问题。针对create_handler返回void*指针,在extract_feature中发生段错误的情况,指出未显式声明函数参数和返回类型导致指针处理异常。通过为so.create_handler设置restype,并为extract_feature和destroy设置argtypes,成功解决段错误,确保指针传递正确。