Python将List列表写入文件并读取的多种方法详解
本文汇总了Python中将List列表写入文本文件的四种常用方法,包括直接写入、字符串转换、循环写入及join函数处理,并详细解析了read、readline和readlines三种读取方式的区别与注意事项。此外,文章还补充了使用csv和xlwt库写入CSV及Excel文件的实现代码,帮助开发者灵活处理数据持久化需求。
2026-10-15
9

本文汇总了Python中将List列表写入文本文件的四种常用方法,包括直接写入、字符串转换、循环写入及join函数处理,并详细解析了read、readline和readlines三种读取方式的区别与注意事项。此外,文章还补充了使用csv和xlwt库写入CSV及Excel文件的实现代码,帮助开发者灵活处理数据持久化需求。
本文介绍如何使用Python多线程技术构建一个支持百度、必应和谷歌的图片下载器。通过requests获取接口数据,利用threading库实现并发搜索与下载,配合alive-progress显示进度条。文章提供了完整的开发环境配置、核心代码逻辑及命令行使用示例,适用于构建小型图像分类数据集。
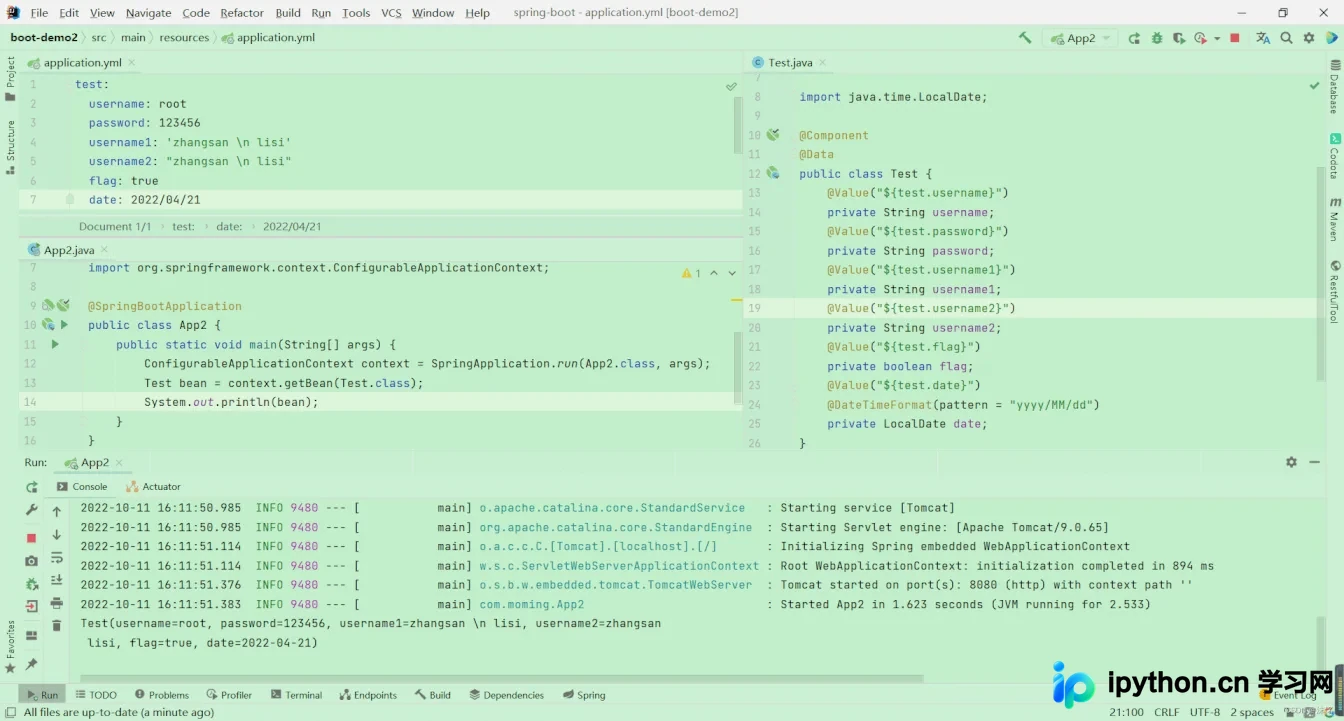
本文详细介绍Spring Boot中YAML配置文件的语法规则,涵盖字面量、对象、数组及复合结构的书写方式。重点解析使用 @ConfigurationProperties 和 @Value 注解读取各类配置数据的技巧,包括字符串转义、Map集合引用及多文档环境切换,帮助开发者规范使用YAML进行项目配置管理。
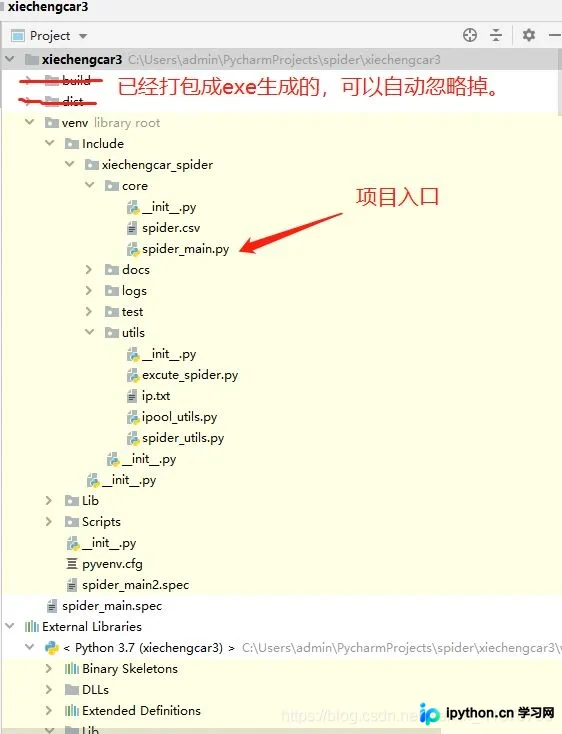
本文详细讲解如何将包含多个Python模块和外部资源的项目通过PyInstaller打包为单个EXE可执行文件。重点介绍pyi-makespec生成Spec文件的方法,详解Analysis中pathex、datas及hiddenimports的配置技巧,并针对模块缺失、脚本执行失败及CMD运行卡顿等常见坑点提供具体解决方案。
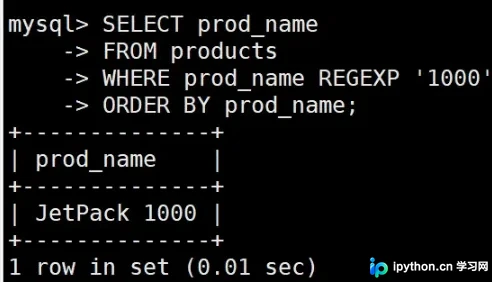
本文详细介绍如何在MySQL中使用REGEXP操作符进行灵活的字符串匹配。涵盖基本字符匹配、OR逻辑(|)、字符集合([ ])、特殊字符转义、字符类、重复元字符及定位符(^ $)的使用方法与注意事项,并对比了LIKE与REGEXP的区别,助力精准检索数据库字段。
本文深入解析C/C++中宏与函数的核心差异。通过汇编代码展示,宏虽因无调用开销在执行速度上更快且支持类型无关,但存在体积膨胀、无法调试及副作用风险;函数则具备类型安全、可逐语句调试的优势。此外还探讨了内联函数如何结合两者优点,以及宏的全大写命名规范,帮助开发者在性能与严谨性间做出最佳选择。
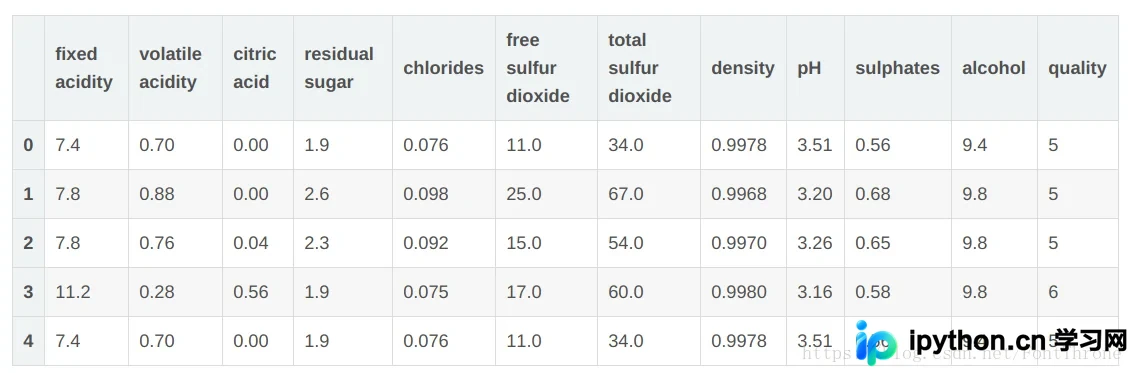
本文介绍如何使用Python实现灰色关联分析,通过改写现有算法使其支持对整个数据矩阵进行批量计算,形式类似Pandas中的相关性计算。文章提供基于UCI红酒质量数据集的完整代码,包括数据下载、无量纲化处理、关联度计算及热力图可视化,帮助读者快速掌握灰色系统理论在动态历程分析中的应用。
本文总结了 TypeScript 开发中实用的 11 个高阶技巧,涵盖关键类型操作(keyof、Pick、Omit)、类型守卫(is)、接口与类型的区别以及 VS Code 配置优化。通过具体代码示例,帮助开发者在编译期更好地进行类型约束,减少运行时错误,提升大型项目的代码健壮性。
在 SQL Server 中,普通唯一索引允许重复的 NULL 值,无法满足“非空值唯一”的需求。本文介绍了三种解决方案:利用带逻辑判断的自定义函数配合 CHECK 约束(适用于所有版本),以及使用 SQL Server 2008 及之后版本的筛选索引功能(推荐)。筛选索引通过 WHERE 子句仅对非空行建立唯一索引,语法简洁且性能更优。
本文介绍如何在PHP中准确提取URL的根域名(如 example.com)。通过封装Sl_RootDomain类,结合一级、二级顶级域及国家代码列表,支持自动识别主机名。适用于需要分析访问来源或构建子域名管理的后端场景,提供完整的实例化、设置URL及获取结果的操作流程。
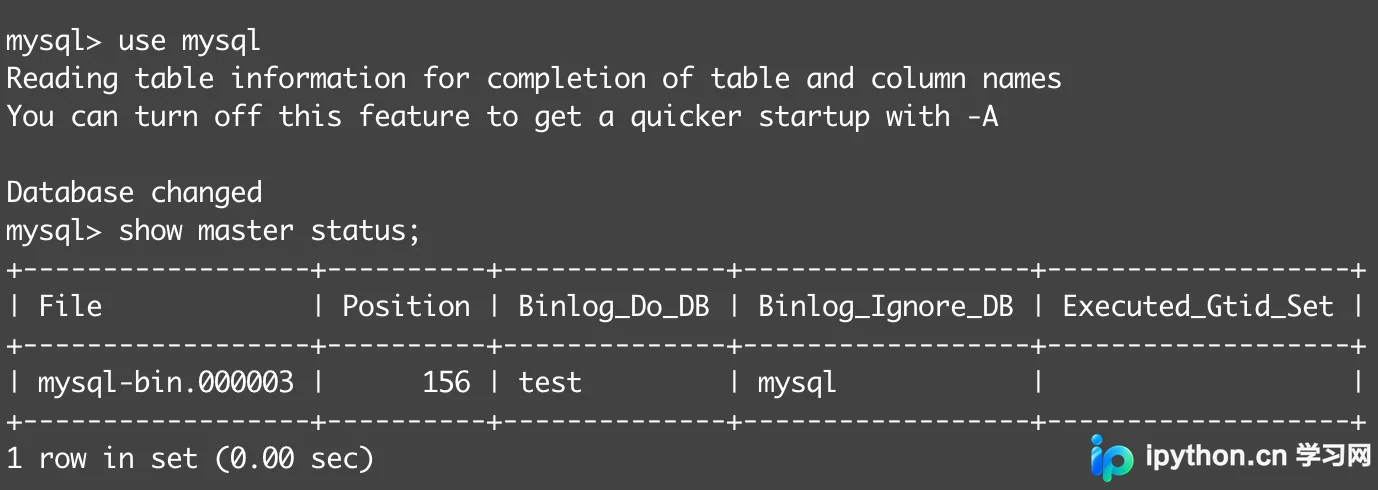
本文详述在Ubuntu环境下搭建MySQL 8.0主从复制的完整流程。涵盖基础安装、主库binlog配置与备份快照、从库数据导入及Slave状态初始化,通过具体命令和配置文件参数,实现数据库数据的实时异步同步,确保数据安全与读写分离基础。
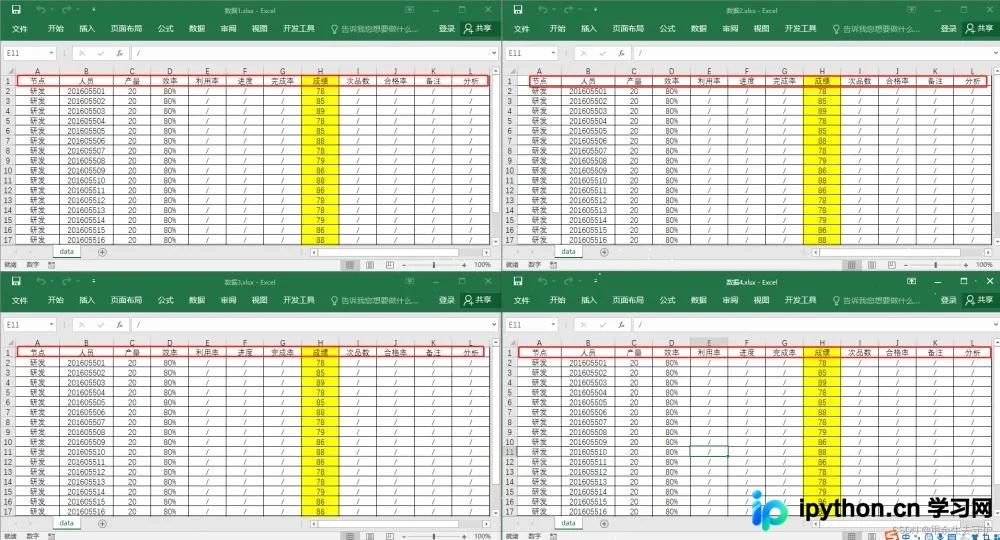
本文介绍如何使用Python脚本,按列索引从包含多个Excel文件的文件夹中提取指定列数据,并将结果汇总到一个新的Excel文件中。文章详细说明了代码注意事项,如文件夹内文件限制及结果文件处理,并提供了完整的Python实现代码示例,帮助开发者高效处理批量Excel数据。