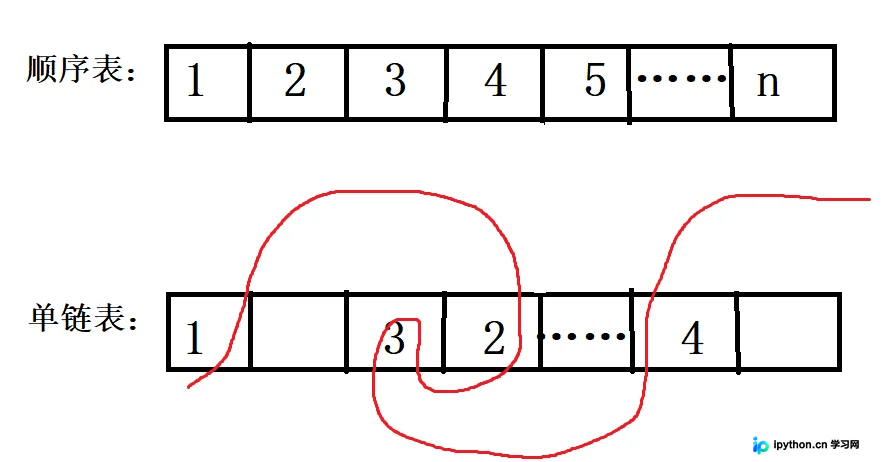
C语言单链表存储详解:从原理到完整代码实现
本文详细介绍C语言中单链表的存储原理与实现。通过对比顺序表,说明如何使用指针连接离散内存。涵盖带头结点和不带头结点的初始化、遍历输出逻辑,并提供可直接运行的完整代码及运行结果,帮助掌握基础链表操作。
2026-10-15
7

本文详细介绍C语言中单链表的存储原理与实现。通过对比顺序表,说明如何使用指针连接离散内存。涵盖带头结点和不带头结点的初始化、遍历输出逻辑,并提供可直接运行的完整代码及运行结果,帮助掌握基础链表操作。
在SQL Server中,处理字段NULL值常遇到类型转换错误。本文介绍两种核心方案:使用CASE WHEN语句进行逻辑判断与显式转换,或利用COALESCE函数自动返回第一个非空表达式。掌握这两种方法可有效解决数据导出或展示时的NULL显示问题,确保结果集的格式统一。
在R语言中,常需将连续数值转换为分类数据。本文介绍三种实现方式:使用attach/detach进行直接索引赋值;使用within()优化作用域管理;以及利用cut()函数配合breaks、labels及区间控制参数(right、include.lowest)进行高效分箱。重点解析cut函数的开闭区间逻辑及极端值处理细节。
本文深入解析 Python 3.5 引入的 async/await 关键字及 asyncio 库的核心机制。详细阐述事件循环、协程、Future 与 Task 的区别,对比 asyncio.gather 与 wait 的使用场景,并通过爬虫实战展示如何高效利用异步 I/O 提升程序性能。
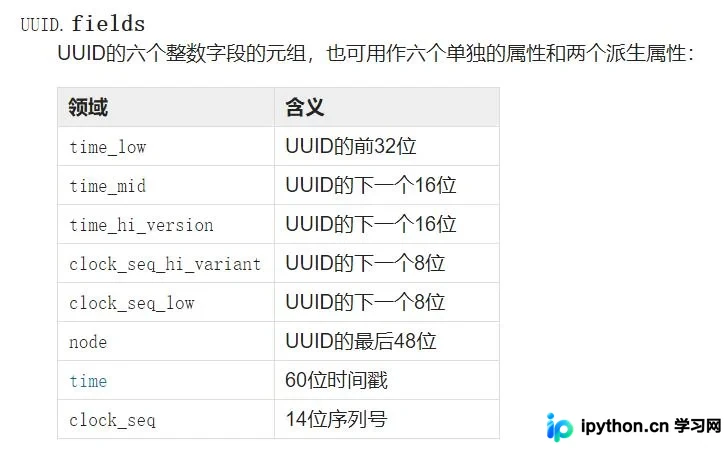
本文详解Python标准库uuid模块,涵盖uuid1至uuid5各版本的生成原理、参数配置及源码实现。重点分析不同版本在分布式环境、命名空间哈希及随机数生成上的差异,并探讨UUID作为数据库主键时的空间占用与索引性能劣势,提供实际应用建议。
本文详解Python中__getattribute__内建属性的工作原理。作为所有类的默认继承基类object提供的拦截器,它允许开发者在属性访问时进行自定义处理。通过重写该方法,可实现权限校验、日志记录等功能,但需注意必须正确调用父类方法并返回结果,否则会导致属性访问失败。
本文解析 MySQL 中 COUNT(*)、COUNT(1) 和 COUNT(字段) 的性能差异。通过实验证明在 InnoDB 引擎下,COUNT(*) 与 COUNT(1) 效率几乎一致且最优,因为它们均会选择最小的辅助索引进行全表扫描计数;而 COUNT(主键字段) 需额外回表或判断 NULL 值,速度略慢。同时说明了 information_schema.TABLES_ROWS 仅作为估算值不可靠,并指出 InnoDB 基于 MVCC 无法像 MyISAM 那样直接存储行数。
本文介绍在C#中使用System.Text.RegularExpressions进行数据过滤和提取的方法。通过导入命名空间、构建匹配模式(如\d),结合流读取与循环遍历,高效筛选出目标文本。包含基础匹配规则详解及去除非十六进制字符的示例代码。
本文介绍如何在MySQL中通过修改my.ini配置文件中的lower_case_table_names参数来设置表名是否区分大小写。该参数仅在数据库初始化前生效,运行中修改无效且可能导致数据丢失。不同操作系统下的默认值与行为存在显著差异,使用前务必做好数据备份并谨慎操作。
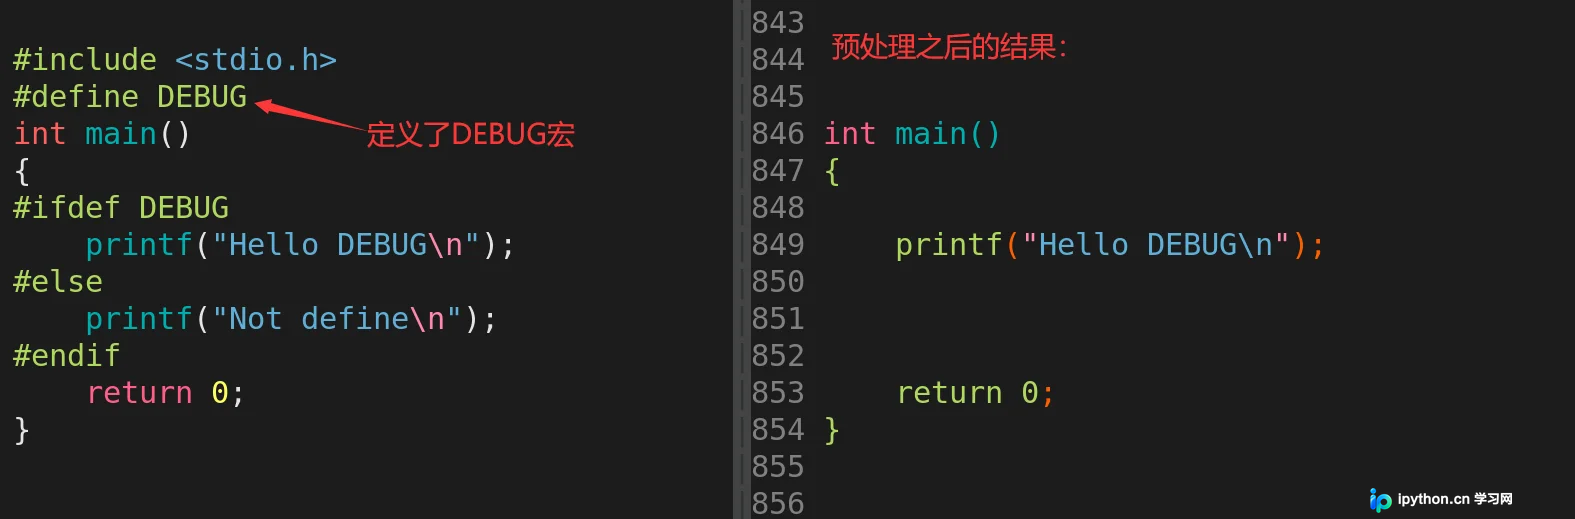
深入解析C语言预处理的进阶用法。掌握三种条件编译模式及其嵌套逻辑,理解代码裁剪与跨平台开发原理;通过实际演示剖析#include的本质及防止重复包含机制;学习#error、#line等调试工具及#和##字符串化连接技巧,提升C语言底层编码能力。
本文介绍Python中处理数字千分位的方法。通过内置format函数或自定义逻辑,可将整数或浮点数转换为带逗号分隔符的字符串,反之亦可去除千分位符号还原数值。重点解析整数与小数部分的处理差异,提供去除及添加千分位的完整代码示例,适用于财务数据处理场景。
本文详细介绍Python中xlsxwriter模块的使用方法,涵盖从安装导入、创建工作簿与单元格数据写入,到字体、边框、背景色等样式配置。重点讲解write系列方法、图片插入、图表生成及大文件constant memory模式优化,同时指出其不支持读取和旧版xls格式的局限性,帮助开发者高效处理Excel文件。