

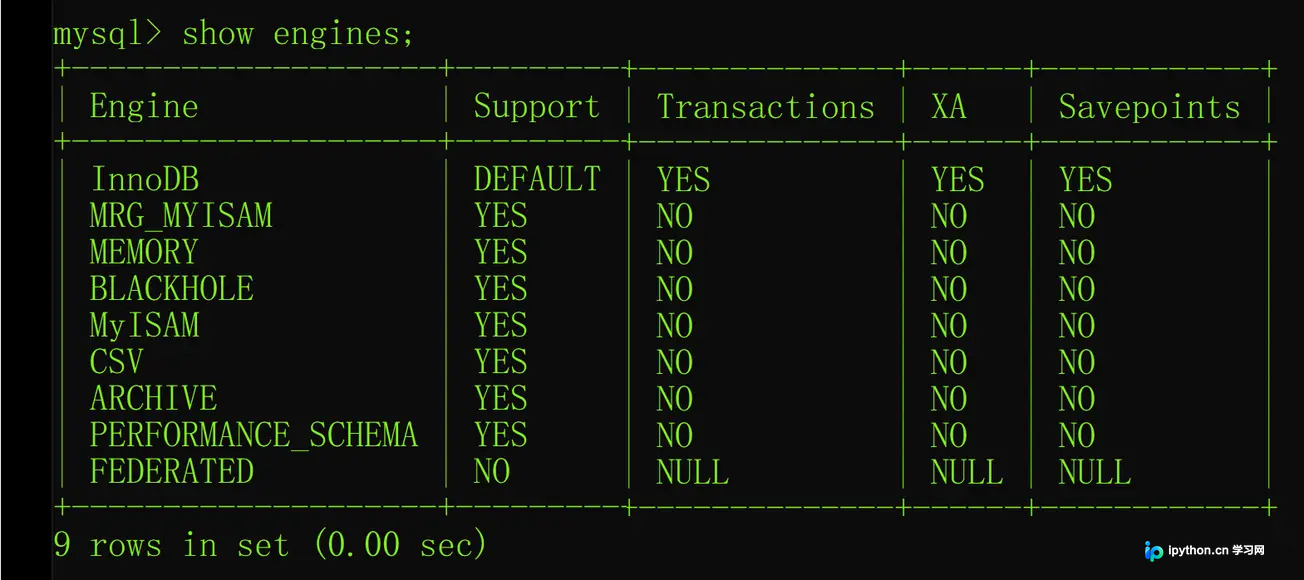
MySQL 常用存储引擎对比及配置方法
本文对比 MySQL 三大常用存储引擎:InnoDB、MyISAM 和 MEMORY。从事务支持、锁机制、读写效率及适用场景进行详细分析,并提供使用 SQL 命令查看及修改表级存储引擎的具体操作指南。
2026-10-15
9

本文对比 MySQL 三大常用存储引擎:InnoDB、MyISAM 和 MEMORY。从事务支持、锁机制、读写效率及适用场景进行详细分析,并提供使用 SQL 命令查看及修改表级存储引擎的具体操作指南。
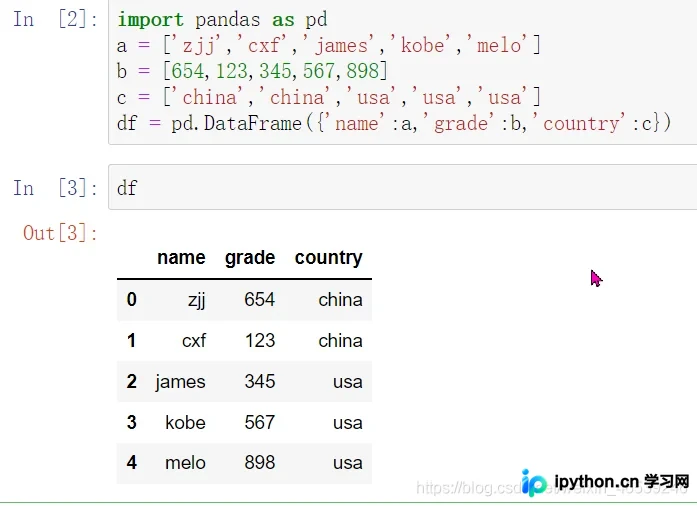
本文详细总结了Python Pandas库中增加行列数据的多种常用方法。内容涵盖使用直接赋值、eval计算、insert函数插入指定列,以及利用loc、iloc、append和concat处理行数据。此外,还介绍了通过apply函数结合自定义逻辑新增衍生列的技巧,适用于数据清洗与特征工程场景。
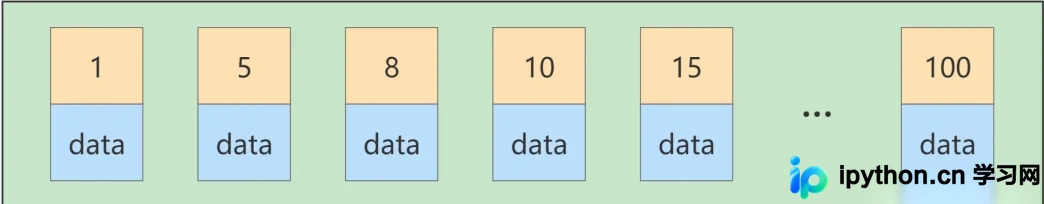
本文详细解析MySQL索引失效的九种常见场景,涵盖违反最佳左前缀法则、主键插入乱序、范围查询右侧列失效、函数计算导致失效、like左模糊匹配、is not null过滤以及字符集不统一等问题。通过SQL示例和执行计划对比,帮助开发者规避性能陷阱,确保查询高效利用B+树索引。
本文介绍如何使用C语言通过结构体和动态数组构建一个具备增删改查及排序功能的通讯录系统。核心在于使用柔性数组或动态指针管理数据,利用函数指针实现通用排序,并通过循环交互提供完整的用户界面体验。
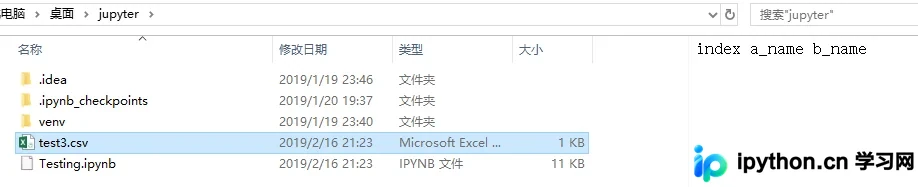
本文介绍如何使用 Python 将新生成的数据实时追加到现有的 CSV 或 TXT 文件中。通过演示 csv 模块的 writerow 和 writerows 方法,以及文件打开模式 'a' 的使用,详细讲解了如何避免数据覆盖、处理换行符及正确关闭文件,确保数据持久保存。
本文详解Python Numpy库中面向数组编程的核心操作。通过向量化计算替代循环,显著提升数据处理效率。深入解析np.where三元表达式、sum/mean等统计聚合函数、布尔数组判定以及unique等集合操作,提供从基础生成到复杂逻辑处理的完整代码示例,助力高效数据分析。
本文介绍如何使用OpenCV内置的ANN_MLP类构建神经网络以识别手写数字。通过Keras加载MNIST数据集,配置反向传播算法与Sigmoid激活函数进行模型训练。实验显示100次迭代后准确率达0.9376,且模型文件仅1MB,远小于SVM和KNN,非常适合客户端部署。

本文介绍如何使用Python的OpenCV库进行基础图像处理。涵盖模块安装、图像读取(cv2.imread)、显示(cv2.imshow)及保存(cv2.imwrite)的具体操作,并详解如何获取图像的像素尺寸、通道数等属性,适用于计算机视觉初学者。
本文详细解析Python中六个高频使用的内置函数:Map用于高效转换可迭代对象,Lambda创建匿名函数简化逻辑,Enumerate辅助索引遍历,Reduce执行累积运算,Filter精准过滤数据,以及Zip合并多个列表。通过具体代码示例展示如何简化编程工作,提升代码运行速度与内存效率,帮助开发者掌握Python数据处理的核心技巧。
本文详细解析C++中获取长度的三种方法:strlen()针对C风格字符串,返回字符数;sizeof是运算符,计算内存字节数;size()用于STL string对象。通过代码对比指针与值类型的差异,并演示在程序中的实际调用方式,帮助开发者准确选择对应工具避免混淆。
本文详细介绍Python第三方库Tenacity的高级重试功能。涵盖无条件重试、设置重试次数与时间限制、基于异常类型或结果的条件重试,以及重试失败后的错误重新抛出和回调函数配置。通过具体代码示例,帮助开发者优雅地处理网络请求超时等不可控因素。
本文详细介绍如何使用C++标准库中的read()和write()成员方法实现高效的二进制文件读写。通过具体代码示例,展示了如何定义数据结构、以二进制模式打开文件、利用write()将对象数据写入磁盘,以及使用read()从文件中恢复数据,并解释了读写指针的运作机制及注意事项。