Python3利用pandas与pandas_datareader获取股票数据及常见报错修复
本文介绍如何在Python3环境中使用pandas和pandas_datareader库获取股票数据。详细记录了安装步骤,并针对运行时报错的ImportError(is_list_like导入失败)和ImmediateDeprecationError(Yahoo Daily弃用)提供了具体的代码修改方案,包括修改fred.py和data.py文件中的导入路径及注释弃用报错语句。

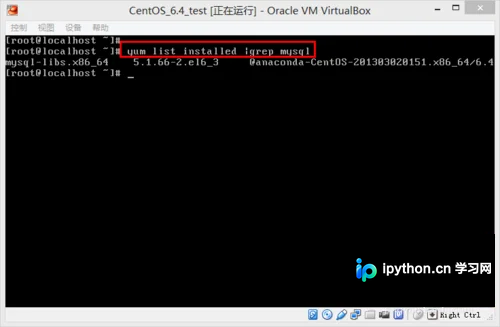
本文详细介绍了在 CentOS 6.4 操作系统下使用 yum 命令安装 MySQL 数据库的完整流程。内容涵盖从检查、卸载系统自带旧版本依赖,到执行正式安装命令、验证版本号及启动服务的各个关键环节,适用于需要进行 Linux 环境下数据库配置的开发人员。

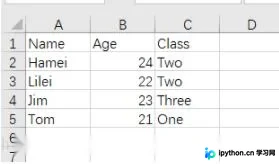
本文介绍在Python中将TXT文件数据读取并转换为NumPy数组或列表的方法。针对包含混合数据的TXT文件,提供逐行处理并转为数组的代码示例;针对纯数字文件,推荐loadtxt直接读取。同时详细解析split和strip函数的语法、参数及实际应用案例,帮助开发者高效处理文本数据。
本文介绍如何使用Python读取通达信股票数据文件(.day)。通过struct模块解析二进制数据,处理日期、价格及成交量字段,最终将结果封装为pandas DataFrame对象,便于后续数据分析与处理。
本文详解Python 3.x中print函数的格式化输出技巧,涵盖数字与字符串的左右对齐方法。通过%运算符演示右对齐(如%3d、%10.3f)及左对齐(%-3d)的具体用法,解析占位符含义及补零规则,帮助开发者掌握类似C语言printf的格式控制能力,实现精确的输出排版。
本文介绍在Python3中利用csv模块将CSV文件数据读取并转换为字典格式的具体实现方式。通过示例代码展示了如何打开文件、获取字段名以及逐行处理数据生成字典对象,供开发者参考使用。

本文介绍如何使用Python将TXT文件内容逐行读取并转换为字典对象。通过按空格分割行数据,利用冒号提取键值对,最终生成包含多个字典的列表。代码特别处理了中文字符的编码问题,确保写入新文件时数据格式正确,适合需要批量处理结构化文本数据的场景。
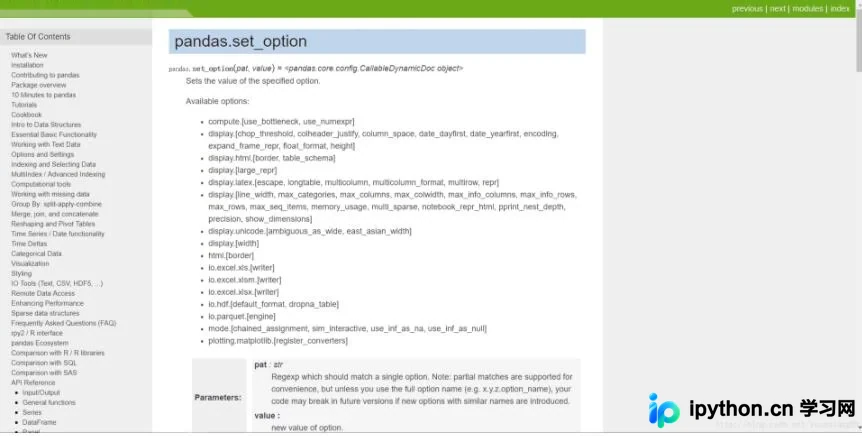
本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。

本文详细解析MySQL中KEY、PRIMARY KEY、UNIQUE KEY与INDEX的区别。主要结论如下:1. KEY与INDEX同义,均用于加速查询;2. PRIMARY KEY是唯一的非空唯一键,单表仅能有一个;3. UNIQUE KEY允许多个且字段可为NULL(但全NULL除外)。本文提供创建与撤销约束的SQL语法示例,帮助开发者优化数据库设计。
本文介绍在Python中实现输入数字反向输出的具体方法。通过示例代码展示如何利用循环和取余操作完成数字反转,适用于初学者理解基础算法逻辑与字符串处理技巧。
在 Laravel 中,虽然框架自带基础防护,但处理富文本时仍可能面临 XSS 风险。本文介绍如何通过 Composer 安装 mews/purifier 扩展包来集成 HTMLPurifier,详细演示服务提供者注册、配置文件发布及自定义安全规则(如标签白名单),并提供辅助函数与门面类两种清理恶意输入的操作方法,帮助开发者有效阻断脚本注入。
本文介绍在 Python 中如何高效处理包含连续空格的字符串。通过结合使用 split() 和 join() 方法,可以自动忽略多余空格并将剩余单词用单个空格连接。例如 'line dd' 经处理后变为 ['line', 'dd'],再拼接即可得到规范化的单空格字符串,适用于数据清洗和文本预处理场景。