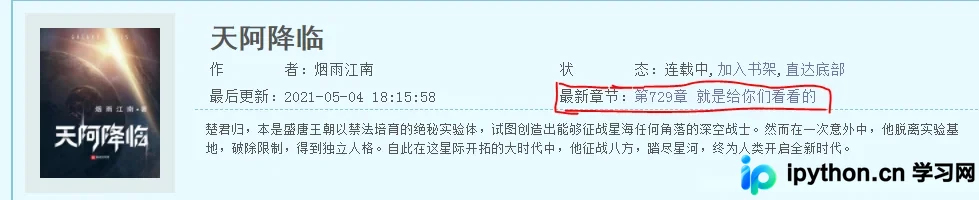
Python爬虫实战:自动搜索并获取小说最新章节及最快访问网站
本文介绍如何使用Python爬虫技术,通过模拟百度搜索请求解析搜索结果页面,提取小说最新章节链接。程序结合访问耗时计算权重,自动筛选出更新最快且响应速度最优的前5个网站链接,解决手动查找小说更新慢、网站打开困难的问题,并提供完整代码实现与案例演示。
2026-10-14
19

本文介绍如何使用Python爬虫技术,通过模拟百度搜索请求解析搜索结果页面,提取小说最新章节链接。程序结合访问耗时计算权重,自动筛选出更新最快且响应速度最优的前5个网站链接,解决手动查找小说更新慢、网站打开困难的问题,并提供完整代码实现与案例演示。
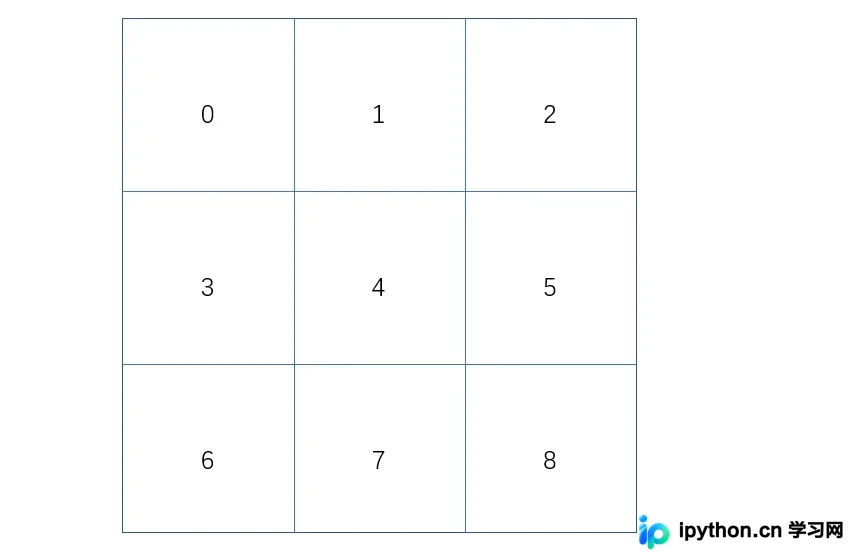
本文详解pygame井字棋开发的第二步,重点实现游戏核心逻辑。内容涵盖玩家通过鼠标点击下棋的事件处理、电脑随机落子的算法实现,以及基于列表解析的输赢判断机制。同时介绍了文字渲染、屏幕刷新及界面显示的具体代码实现,为后续逻辑优化奠定基础。
本文深入解析C++异常处理机制,通过标准关键字throw、try、catch展示如何捕获运行时错误。包含完整的自定义异常类代码示例,详细对比传值与传指针抛出的性能差异及内存管理要点,并列举构造函数抛出异常的注意事项及接口声明规范。
本文通过一个C#控制台应用程序示例,展示如何使用System.Threading.Tasks命名空间下的Task类创建和管理多个并行任务。代码演示了两个独立线程分别以不同间隔打印日志并在完成后退出,同时保持主线程阻塞等待所有任务结束,从而解决常见的线程同步问题并提供直观的运行效果分析。
本文介绍如何使用 PHP 的正则函数 preg_match 来检测并拦截用户输入中的非法特殊符号。通过定义包含空格、标点、转义字符及中英文标点等的正则规则,配合提示信息,可有效规范姓名或昵称等字段的输入格式,确保数据安全性与整洁性。
本文介绍使用Python批量删除同一文件夹下相似图片的两种方法。第一种方法通过相邻文件比较,适合视频截图等连续图像,效率较高;第二种方法采用逐个比对策略,准确率更高但耗时较长。文章提供了基于OpenCV和scikit-image的完整代码示例,涵盖SSIM相似度计算及文件删除逻辑。
本文介绍在Python中统计列表中特定元素出现次数并返回所有索引值的方法。首先使用list.count()获取个数,随后通过list.index()配合起始参数、直接索引遍历判断、以及enumerate结合列表推导式三种方式实现索引提取,适用于不同场景下的数据处理需求。

本文提供了一套基于 JDBC 的 Java 连接 Oracle 数据库的通用解决方案。通过创建 ConfigManager 单例模式读取 database.properties 配置,并在 BaseDao 基类中封装获取连接、执行增删改查(PreparedStatement)及关闭资源的方法,简化数据库操作开发流程。该方案适用于需要统一管理数据库连接和 SQL 执行的 Java 项目基础架构。
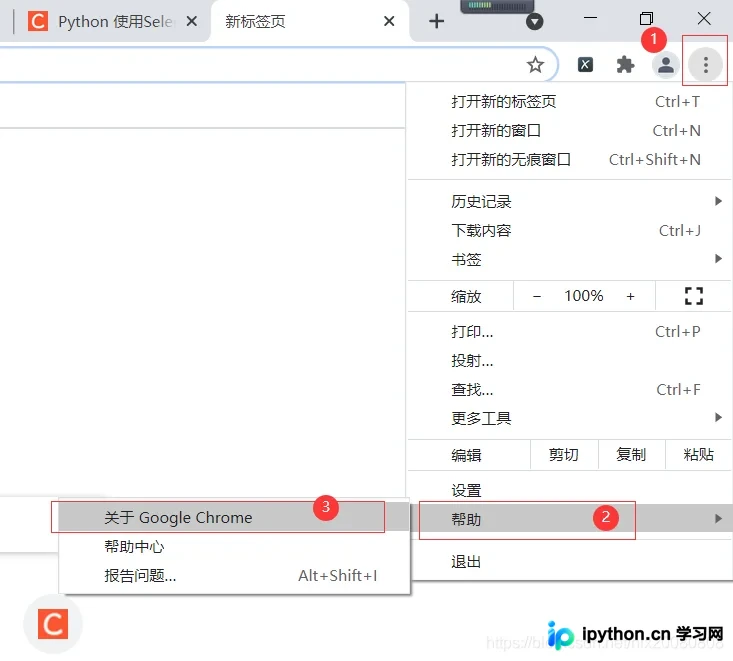
本文详细介绍在 Python 中安装 Selenium 的完整流程。首先通过 pip 命令在虚拟环境中安装 selenium 模块,随后指导用户如何根据本地 Chrome 浏览器版本下载匹配的 chromedriver。内容涵盖 Windows、Linux 和 macOS 系统下的驱动解压、路径设置及环境变量配置方法,确保 Selenium 能正确调用浏览器进行自动化测试。
本文介绍如何在Django 2.0中利用AJAX技术实现博文实时搜索功能。通过前后端分离的设计思路,前端在用户输入关键词时异步发送请求,后端仅返回匹配文章的数量而非完整列表,从而提升用户体验并减少服务器负载。文章详细讲解了URL配置、视图处理逻辑以及前端JavaScript的交互实现。
本文提供 C# 语言实现的万年历类(ChineseCalendar)源码,支持公历转农历、农历转公历及双向校验。通过预置的二进制位数组存储 1900-2049 年的阴阳历数据,该类可准确输出干支纪年、十二生肖、二十八星宿、二十四节气精确时刻以及中西节日信息。代码包含完整的日期验证与逻辑转换算法,适用于需要在 .NET 应用中集成传统日历功能的场景。
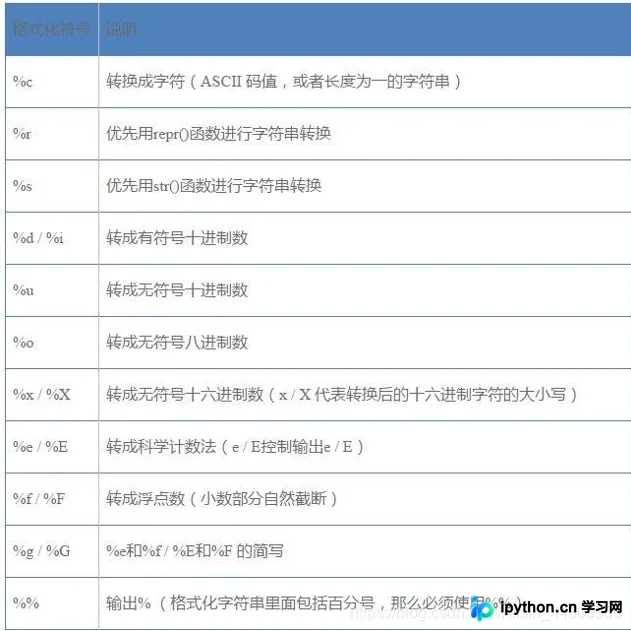
本文系统讲解Python中字符串的常规操作。涵盖使用+运算符拼接、利用len与encode计算字节长度、通过切片语法截取、split与join分割合并,以及find、index等检索方法。详细解析%与format两种格式化方式,并深入说明str与bytes类型的encode编码及decode解码转换机制,助您掌握核心技能。