

Pandas DataFrame重排与旋转:pivot、stack、melt及交叉表详解
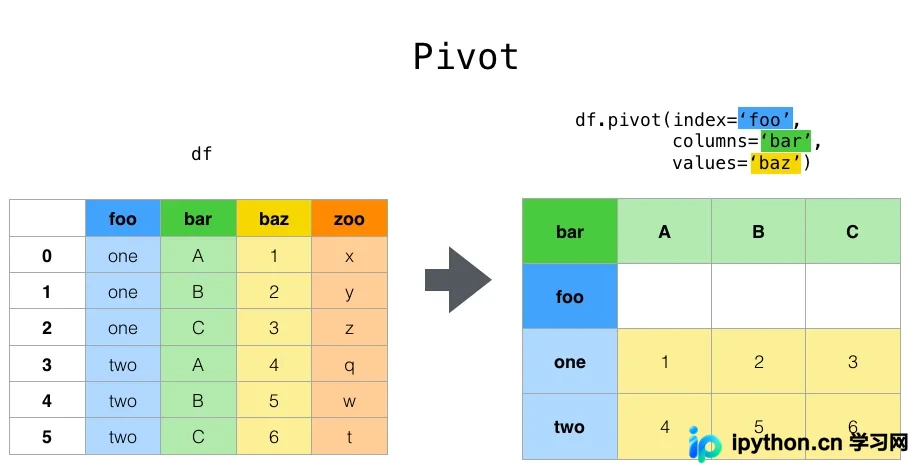
本文深入解析Pandas中DataFrame的重排与旋转技术。详细讲解pivot函数的索引、列及值重组机制,对比stack与unstack在层级索引转换中的反向操作,阐述melt将宽表转为长表的标志变量用法,并介绍pivot_table聚合统计、crosstab交叉计数及get_dummies独热编码的具体实现与参数配置。
2026-10-14
19

本文深入解析Pandas中DataFrame的重排与旋转技术。详细讲解pivot函数的索引、列及值重组机制,对比stack与unstack在层级索引转换中的反向操作,阐述melt将宽表转为长表的标志变量用法,并介绍pivot_table聚合统计、crosstab交叉计数及get_dummies独热编码的具体实现与参数配置。
本文介绍在 C# 中如何将带透明通道的图片像素数据解析,提取非透明部分并构建 System.Drawing.Region。通过 LockBits 高效读取 ARGB 像素,遍历检测 Alpha 通道,使用 GraphicsPath 添加矩形点集,最终生成可交互的 Region 对象。
在PHP中,json_encode对连续索引数组生成方括号JSON,而对关联或不连续数组生成花括号JSON。这导致json_decode返回类型不同。为解决此问题并确保始终获取数组结构,应使用JSON_FORCE_OBJECT参数或结合JSON_UNESCAPED_UNICODE进行标准化编码,避免后续解析的类型意外切换。
在MySQL存储过程中,直接传入逗号分隔的字符串无法被解析为标准的IN列表。本文介绍两种解决方案:对于枚举数量较少的情况,推荐使用FIND_IN_SET函数,语法简单且安全;对于复杂场景或需利用索引的情况,则采用动态SQL拼接并预处理执行的方式,能更灵活地处理大量数据筛选。
本文详细介绍 JavaScript 数组的创建方式(构造函数与字面量)、底层原理及长度机制。重点解析 `splice`、`slice`、`concat` 和 `sort` 等常用方法的语法参数与实际应用场景,帮助开发者掌握高效处理数组的技巧。
介绍 MySQL 中 ORDER BY RAND() 效率低的原因,并提供基于主键范围随机选取和 JOIN 语法的高效 SQL 语句,可将数万条数据的随机查询从秒级降低至毫秒级。
本文详细介绍Python中tqdm进度条库的安装方法及核心用法。涵盖通过pip安装模块、基础迭代器使用示例,以及desc、total、bar_format等关键参数的配置。tqdm支持list、tuple等多种可迭代对象,帮助开发者在命令行中实时监控长循环执行进度与处理速度。
针对 MySQL 大表深层分页导致的 LIMIT 延迟问题,本文提供三种主流优化策略。通过主键覆盖索引的子查询加速、JOIN 连接分页以及利用 SQL_CALC_FOUND_ROWS 一次性获取总数与数据。实测表明,在偏移量巨大时,基于索引的子查询与 JOIN 方案相比全表扫描有显著性能提升,而 FOUND_ROWS 则能减少二次查询开销,适合需要总行数的场景。
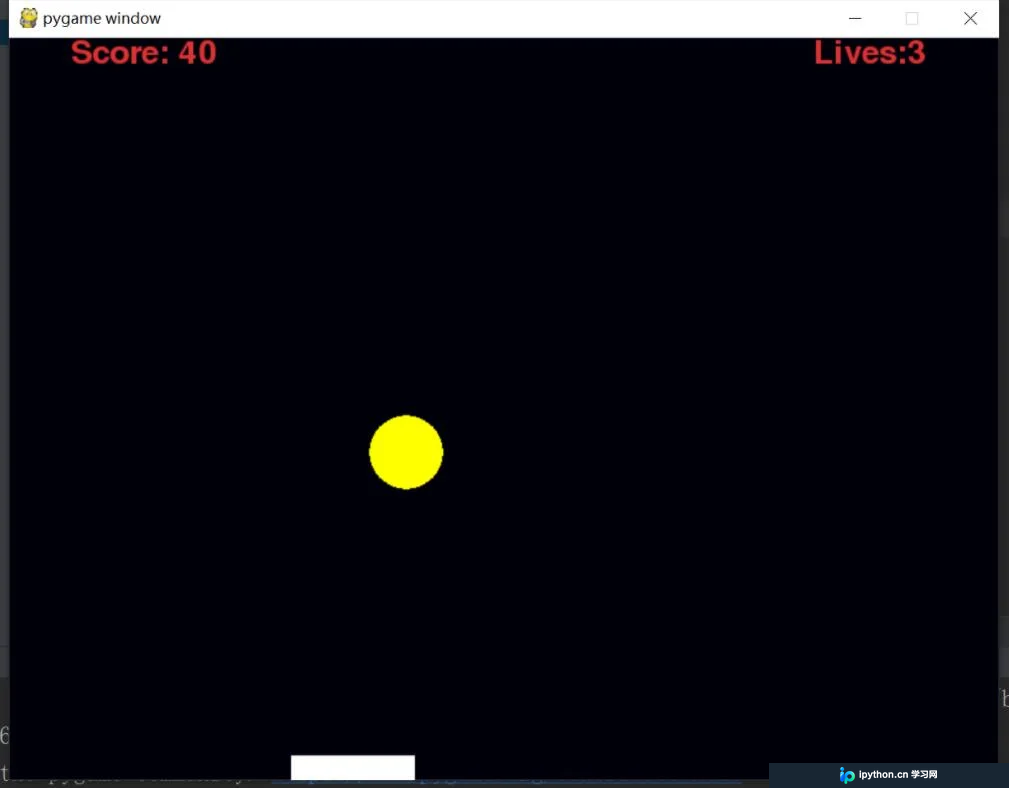
本文介绍如何使用Python的Pygame库开发一个简单的滑块接小球游戏。通过绘制圆形、矩形及随机数生成,演示基本的鼠标交互与碰撞逻辑。文章提供完整代码解析,涵盖游戏初始化、主循环处理、球体运动控制及生命值计分机制,适合Python初学者练习基础游戏开发思维。
本文深入解析C/C++中通过stdarg.h处理不定数目参数的核心机制。详细讲解va_list、va_start、va_arg和va_end四个宏的定义与作用,结合具体代码实例演示如何安全读取可变参数。同时分析堆栈中的参数分布原理,并对比C语言变参与C++多态性的适用场景,帮助开发者掌握底层调用规范。
本文系统梳理正则表达式的核心语法规则,涵盖量词、字符类、边界锚点及转义字符等关键概念。通过对比 JavaScript 客户端验证与 C# 服务器端验证的代码示例,展示如何在实际开发中利用 Regex 进行字符串模式匹配与数据校验。文末汇总了常用的邮箱、手机号等验证正则模板,助力开发者高效构建安全的数据过滤逻辑。
在MySQL中进行数据入库时,正确处理特殊字符是保证数据安全与查询准确的关键。本文详细解析了MySQL支持的各类转义字符(如NUL、换行符等),并演示了单双引号混合使用时如何正确转义引号字符。掌握这些规则能有效避免语法错误及潜在的SQL注入风险,确保数据完整存入数据库。