

K-means聚类算法详解与Python实战:从原理到代码实现

本文深入解析K-means聚类算法的核心原理、迭代步骤及优缺点,并通过Python代码展示具体实现过程。文章首先厘清聚类与分类的本质区别,随后详细阐述K-means的最小误差平方和准则及算法流程,最后结合实战案例探讨K值选择、初始质心敏感性等常见问题及其改进策略。
聚类
本文重点介绍K-means聚类算法。在深入之前,必须明确区分“聚类”与“分类”的概念差异。许多业务人员在日常数据分析中容易混淆二者,但实际上它们存在本质区别。
分类是一种从特定数据中挖掘模式并做出判断的过程。以Gmail邮箱的垃圾邮件过滤器为例,初始阶段系统可能不进行任何过滤。随着用户使用过程中对每封邮件手动标记为“垃圾”或“非垃圾”,系统通过不断分析这些带有标签的数据,学习并建立判别模式。最终,当新邮件到达时,系统能自动将其归入人工预设的“垃圾”或“非垃圾”类别之一。
聚类的目标同样是将数据分组,但其关键在于事先并不知晓具体的分类标准。算法完全依据数据间的相似性自行判断,将相似的数据归为一类。在聚类结果生成前,各类别的具体特征未知,必须依赖人工经验对聚类后的结果进行分析,以揭示各类别的潜在特点。
1、概述
K-means是处理聚类任务时最常用的算法之一,兼具简单性与经典性,是一种基于距离度量的聚类算法。
该算法采用距离作为相似性的评价指标,即假设两个对象之间的距离越近,其相似度越高。
算法假设类簇由距离相近的对象组成,因此其最终目标是将数据划分为紧凑且相互独立的簇。
2、核心思想
K-means通过迭代寻找一种将数据划分为k个类簇的方案,使得用这k个类簇的均值代表相应样本时,总体误差最小。
理想的k个聚类应满足:各聚类内部尽可能紧凑,而各聚类之间尽可能分离。
K-means算法的基础是最小误差平方和准则。
其代价函数定义为:
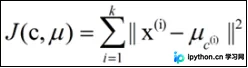
式中,μc(i)表示第i个聚类的均值。
各类簇内的样本与类均值间的误差平方越小,说明样本越相似。对所有类所得到的误差平方求和,即可验证分为k类时各聚类是否达到最优。
由于该代价函数无法通过解析方法直接最小化,因此必须采用迭代算法求解。
3、算法步骤图解
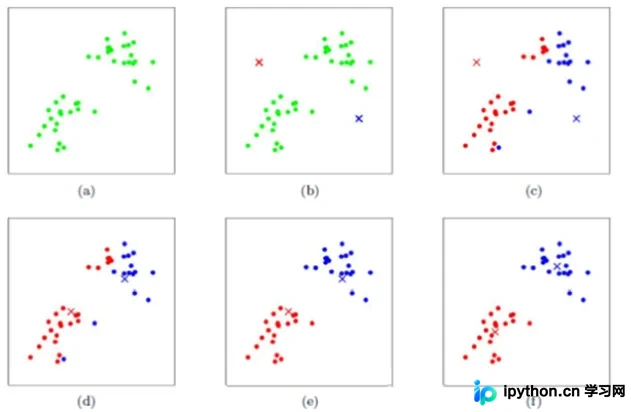
下图展示了对n个样本点进行K-means聚类的效果,此处设定k=2。
4、算法实现步骤
K-means算法将样本聚类成k个簇(cluster),其中k为用户指定的参数。其求解过程直观且简单,具体算法描述如下:
1) 随机选取k个聚类质心点。
2) 重复以下步骤直到收敛:
对于每一个样例i,计算其应归属的类别。
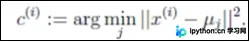
对于每一个类j,重新计算该类的质心。
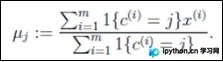
}
其伪代码如下:
******************************************************************************
创建k个点作为初始的质心点(随机选择)
当任意一个点的簇分配结果发生改变时
对数据集中的每一个数据点
对每一个质心
计算质心与数据点的距离
将数据点分配到距离最近的簇
对每一个簇,计算簇中所有点的均值,并将均值作为质心
********************************************************
5、K-means聚类算法python实战
需求:
对给定的数据集进行聚类。
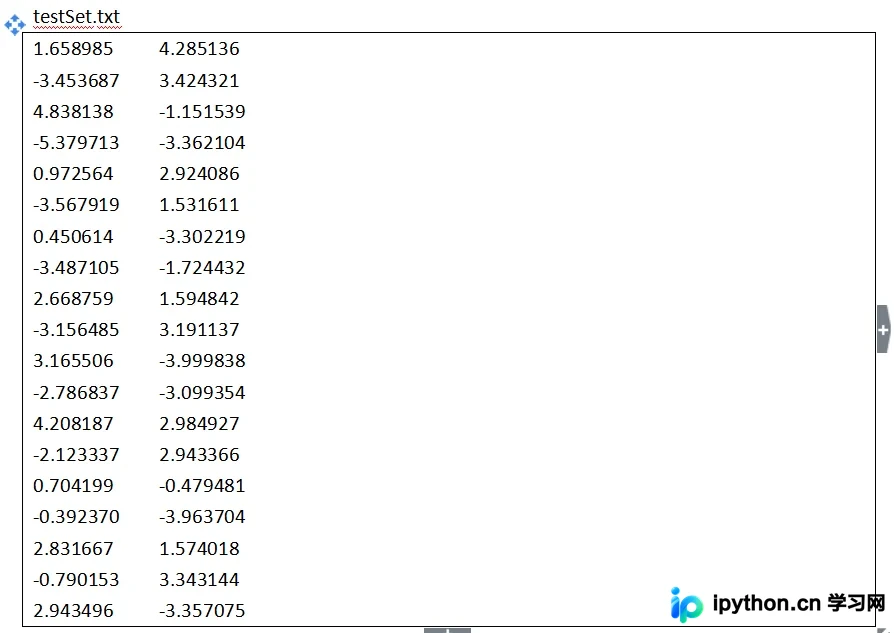
本案例采用二维数据集,共80个样本,包含4个类。
#!/usr/bin/python
# coding=utf-8
from numpy import *
# 加载数据
def loadDataSet(fileName): # 解析文件,按tab分割字段,得到一个浮点数字类型的矩阵
  dataMat = []       # 文件的最后一个字段是类别标签
  fr = open(fileName)
  for line in fr.readlines():
    curLine = line.strip().split('\t')
    fltLine = map(float, curLine)  # 将每个元素转成float类型
    dataMat.append(fltLine)
  return dataMat

# 计算欧几里得距离
def distEclud(vecA, vecB):
  return sqrt(sum(power(vecA - vecB, 2))) # 求两个向量之间的距离

# 构建聚簇中心,取k个(此例中为4)随机质心
def randCent(dataSet, k):
  n = shape(dataSet)[1]
  centroids = mat(zeros((k,n)))  # 每个质心有n个坐标值,总共要k个质心
  for j in range(n):
    minJ = min(dataSet[:,j])
    maxJ = max(dataSet[:,j])
    rangeJ = float(maxJ - minJ)
    centroids[:,j] = minJ + rangeJ * random.rand(k, 1)
  return centroids

# k-means 聚类算法
def kMeans(dataSet, k, distMeans =distEclud, createCent = randCent):
  m = shape(dataSet)[0]
  clusterAssment = mat(zeros((m,2)))  # 用于存放该样本属于哪类及质心距离
  # clusterAssment第一列存放该数据所属的中心点,第二列是该数据到中心点的距离
  centroids = createCent(dataSet, k)
  clusterChanged = True  # 用来判断聚类是否已经收敛
  while clusterChanged:
    clusterChanged = False;
    for i in range(m): # 把每一个数据点划分到离它最近的中心点
      minDist = inf; minIndex = -1;
      for j in range(k):
        distJI = distMeans(centroids[j,:], dataSet[i,:])
        if distJI < minDist:
          minDist = distJI; minIndex = j # 如果第i个数据点到第j个中心点更近,则将i归属为j
      if clusterAssment[i,0] != minIndex: clusterChanged = True; # 如果分配发生变化,则需要继续迭代
      clusterAssment[i,:] = minIndex,minDist**2  # 并将第i个数据点的分配情况存入字典
    print centroids
    for cent in range(k):  # 重新计算中心点
      ptsInClust = dataSet[nonzero(clusterAssment[:,0].A == cent)[0]]  # 去第一列等于cent的所有列
      centroids[cent,:] = mean(ptsInClust, axis = 0) # 算出这些数据的中心点
  return centroids, clusterAssment
# --------------------测试----------------------------------------------------
# 用测试数据及测试kmeans算法
datMat = mat(loadDataSet('testSet.txt'))
myCentroids,clustAssing = kMeans(datMat,4)
print myCentroids
print clustAssing
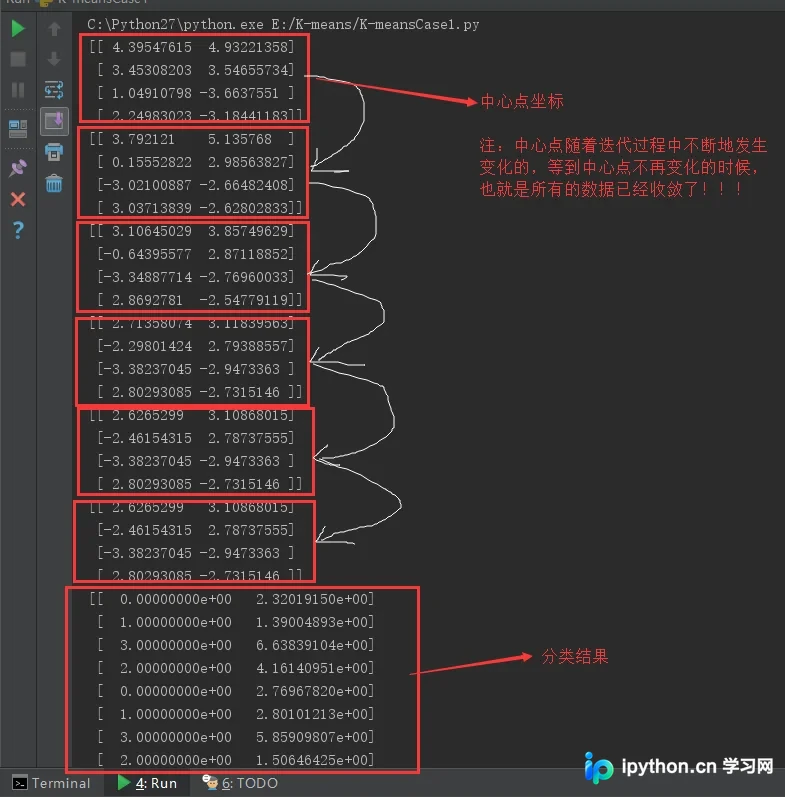
运行结果:
6、K-means算法补充
K-means算法的缺点及改进方法
(1)k值的选择由用户指定,不同的k值会导致结果显著不同。如下图所示,左侧为k=3的结果,显得过于稀疏,其中蓝色簇实际上可进一步划分为两个子簇;右侧为k=5的结果,可见红色菱形与蓝色菱形两个簇本应合并。
改进:
在选择k值前,可先利用重心和密度等算法分析数据分布,从而选择合适的k值。
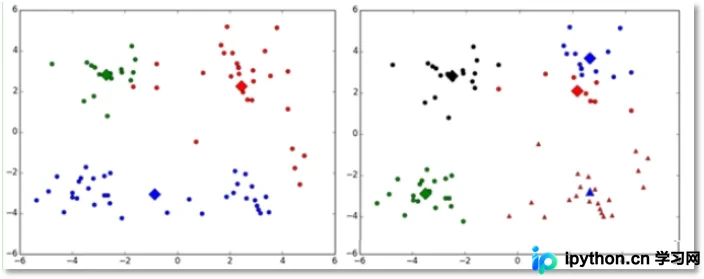
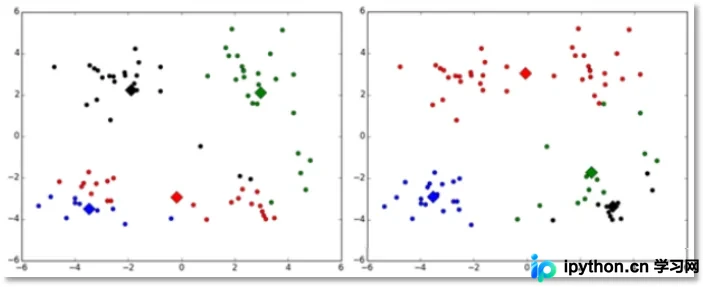
(2)对k个初始质心的选择较为敏感,容易陷入局部最小值。例如,上述算法运行时可能得到不同结果,如下两种情况所示。虽然K-means均已收敛,但仅收敛到了局部最小值。
改进:
有人提出了二分k均值(bisecting k-means)算法,该算法对初始k个质心的选择相对不敏感。
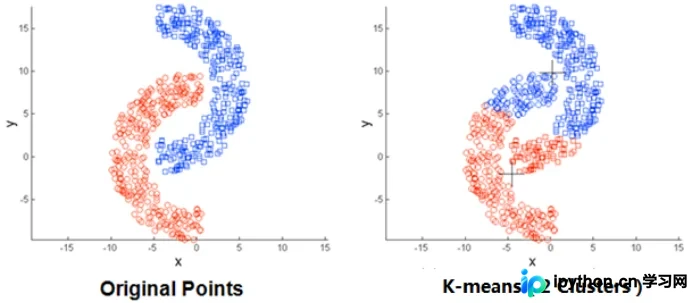
(3)存在局限性,如下面这种非球状的数据分布就无法处理。
(4)当数据集较大时,收敛速度较慢。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









